Систематичний відбір


 .
Оцінка
дисперсії
 називається
незміщеною
оцінкою дисперсії
 ,
якщо
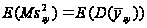 ,
тобто, якщо вона незміщена відносно середнього по всім скінченим популяціям, які можуть бути отримані з цієї надпопуляції.
Популяція, одиниці якої розташовані навмання.


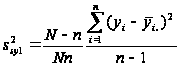 .
Остання
формула є оцінкою
дисперсії
систематичної
вибірки
 -
тої одиниці.
Ця модель застосовується, якщо ми впевненні в тому, що порядок розташування одиниць має в основному випадковий характер відносно ознаки, що спостерігається. Формула дисперсії збігається з формулою дисперсії простого випадкового відбору, і її оцінка незміщена, якщо наша модель справедлива.
Стратифікована популяція, одиниці якої у стратах розташовані навмання
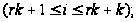
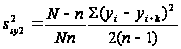 .
В цьому
випадку середнє
значення є
постійним
всередині
кожної страти
з
 одиниць. Оцінка
 ,
яка заснована
на середньому
квадраті послідовних
різниць, не
буде незміщеною.
В її утворенні
приймають
небажану участь
різниці значень
 сусідніх страт
і, зокрема, при
оцінюванні
випадкового
доданку дисперсії
перша та остання
страти мають
занадто малу
вагу. Якщо наша
модель справедлива,
то для достатньо
великих вибірок
ця оцінка буде,
взагалі кажучи,
перевищувати
дисперсію.
Лінійний тренд


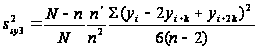 .
Оцінка
заснована на
квадратах
послідовних
різниць, що
утворюються
трьома сусідніми
значеннями
 ,
 ,
 у вибірці. Сума
квадратів
містить
 членів. У випадку
лінійного
тренду його
можна виключити,
використовуючи
кінцеві поправки.
Член
 дорівнює сумі
квадратів ваг
у виразі
 .
Якщо тільки
 не мале,
можна замінити
звичайним
множником
 .
Це можна зробити,
оскільки крайнім
стратам надана
дуже мала вага,
оцінка зміщена,
за виключенням
випадку, коли
 є постійною
величиною. Але
якщо
велике і наша
модель справедлива,
то оцінка буде
цілком задовільною.
1.9 Стратифікований систематичний відбір
Якщо одиниці певним чином впорядковані, то систематичний відбір забезпечує деякого роду стратифікування з рівними долями відбору. Якщо стратифікування виконано за деяким іншим критерієм, то з кожної страти можна вилучити окрему систематичну вибірку, визначаючи точки відліку незалежно. Такий підхід зручний, якщо ми хочемо отримати окремі оцінки для кожної страти або якщо застосовуються нерівні долі відбору. Цей метод буде, звичайно, більш точним, ніж стратифікований випадковий відбір, якщо систематичний відбір всередині страт більш точний, ніж випадковий відбір всередині страт.
Якщо
 − середнє значення
для систематичної
вибірки у страті
 ,
то оцінка середнього
для сукупності
 і її дисперсія
мають вигляд:
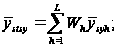
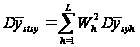 .
Якщо страт
небагато, то
задача знаходження
дисперсії за
вибіркою зводиться
до задачі пошуку
за вибіркою
задовільної
оцінки
 у кожній страті.
Якщо страт багато, то може бути кращою оцінка, знайдена за методом «поєднанних страт». Оцінка
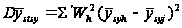 ,
де підсумовування проводиться за всіма парами страт, у середньому перебільшує дисперсію, навіть якщо варіація періодичного характеру існує всередині страт.
Незміщену
оцінку дисперсії
похибки можна
отримати, якщо
з кожної страти
вилучаються
дві систематичні
вибірки з різними
точками відліку,
які обрані
навмання, та
з інтервалом
відбору
 .
При цьому кожна
страта забезпечує
один ступінь
вільності. Якщо
систематичний
відбір є ефективним,
то такий прийом
призведе до
деякої втрати
точності. Якщо
страт багато,
то з більшості
їх можна добути
по одній систематичній
вибірці, а по
дві вибірки
для оцінювання
по ним похибки
вилучити лише
у частині страт,
відібравши
цю частину
навмання.
1.10 Двовимірний систематичний відбір
При відборі з популяції, що представляє собою деяку територію, найпростішим узагальненням одновимірного систематичного відбору буде відбір за схемою квадратної решітки, яка зображена на рис.1.10.1. Вибірка повністю визначається парою випадкових чисел, які задають координати лівої верхньої одиниці.
Характеристики
схеми квадратної
решітки були
дослідженні
на прикладах
як теоретичних,
так і реальних
популяцій.
Матерн (1960) дослідив
найкращий тип
вибірки для
випадку, коли
кореляція
спостережень
у довільних
двох точках
виражається
монотонно
спадаючою
випуклою вгору
функцією відстані
між ними
 .
Для корелограм
вигляду
 відбір по квадратній
решітці виявляється
достатньо
придатним і
перевищує
простий або
стратифікований
випадковий
відбір з однією
одиницею у
кожній страті,
хоча Матерн
і вказує причини,
за якими можна
очікувати, що
найкращою
схемою для цієї
ситуації виявиться
відбір по трикутній
решітці, що
утворені вершинами
рівносторонніх
трикутників.
У 14 сільськогосподарських дослідженнях на однорідність Хейнс (1948) знайшов, що відбір за квадратною решіткою дає майже ту саму точність, що і двовимірний простий випадковий відбір. Мілн (1959) вивчав відбір за «центральною» схемою квадратної решітки, коли вибірка визначається точкою, яка лежить в центрі квадрату, у 50 випробуваннях на однорідність. Такий спосіб відбору виявився краще простого випадкового відбору і, можливо, дещо краще, ніж стратифікований випадковий відбір, хоча остання перевага не була статистично значущою. Ці результати вказують на те, що принаймні, для даних такого типу, автокореляція виражена слабко. При оцінюванні по мапі площі, яку займає ліс чи вода, Матерн у двох прикладах помітив, що квадратна решітка перевищує випадкові методи відбору.
Два типи двовимірної систематичної вибірки
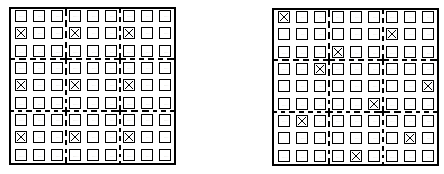
Рис. 1.10.1 Рис. 1.10.2 Вирівняна вибірка або Невирівняна вибірка за схемою «квадратної решітки»
На рис. 1.10.2 наведена систематична вибірка іншого типу, яка називається невирівняною вибіркою.
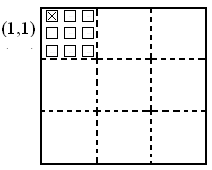
1. Добуваючи пару випадкових чисел, задаємо координати лівої верхньої одиниці:
2. Добуваючи пару випадкових чисел, задаємо горизонтальні координати двох одиниць в першому стовбці:
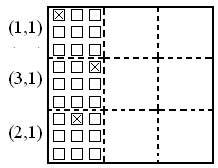
Наприклад, в другому рядку − координати правої одиниці, в третьому рядку − координати центральної одиниці.
3. Добуваючи пару випадкових чисел, задаємо вертикальні координати двох одиниць в першому рядку:
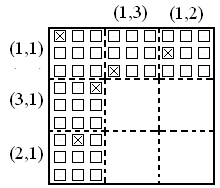
Наприклад, в другому стовбці − координати нижньої одиниці, в третьому стовбці − координати центральної одиниці.
Після
цього постійний
інтервал
(що
дорівнює сторонам
квадратів)
однозначно
задає розташування
всіх інших
точок. Дослідження
Кенуя (1949) і Даса
(1950) для простих
двовимірних
корелограм
вказують на
те, що невирівняна
схема часто
дає кращі результати,
ніж квадратна
решітка та
стратифікований
випадковий
відбір.
Ще
одне свідчення
переваги невирівняної
вибірки дає
досвід планування
експериментів,
який виявив,
що для розміщення
спостережень
у прямокутній
області цілком
можна застосовувати
схему латинського
квадрату.
Вважатимемо,
що латинський
квадрат (5 5),
який показаний
на рис. 1.10.3, задає
розбиття області
на п’ять систематичних
вибірок, кожна
з яких відповідає
певній літері.
Є деякі данні
про те, що цей
особливий
квадрат, що
називається
латинським
квадратом
«ходом коня»,
буде більш
точним, ніж
навмання вибраний
квадрат (55).
Причина цього,
ймовірно, у
тому, що у першого
ніяка вибірка
не містить двох
елементів не
тільки з одного
рядка чи одного
стовпця, але
й із кожної
діагоналі.
Принципом побудови латинських квадратів скористалися Хомейер та Блек при відборі на прямокутних полях вівса. Кожне поле містило 21 ділянку. Три можливі систематичні вибірки, які позначені відповідно літерами A, B, C, що показані на рис. 1.10.4. Таке розміщення, коли на кожному полі обирається навмання одна з літер, збільшило точність приблизно на 25% у порівнянні зі стратифікованим випадковим відбором, в якому рядки виступали стратами. Оскільки кожна літера зустрічається тричі в одному стовпчику і по два рази в інших, таке розміщення не зовсім точно задовольняє означенню латинського квадрату, але, наскільки це можливо, відповідає йому.
Дві схеми систематичного відбору, засновані на латинських квадратах
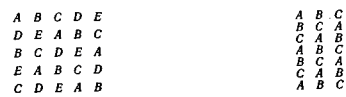
Рис.
1.10.3 Латинський
квадрат «ходом
коня» Рис. 1.10.4
Схема систематичного
відбору для
прямокутного
поля 37
Йейтс
(1960), який назвав
розміщення
такого типу
відбором за
решіткою, розглядає
їх застосування
для двовимірного
та тривимірного
відбору. У випадку
трьох вимірів
кожний рядок,
кожний стовпець
та кожна вертикаль
можуть бути
представлені
у вибірці шляхом
відбору
 одиниць
з
 одиниць
популяції. Якщо
вибірка містить
 одиниць, то в
ній можуть бути
представленні
кожне з
сполук рядків
та стовпців
або рядків та
вертикалей,
або стовпців
та вертикалей.
Паттерсон
(1954) дослідив
розміщення,
які дають незміщену
оцінку похибки.
1.11 Приклади розв’язування задач
Приклад 1. У таблиці 1.11.1 наведена кількість саджанців на кожному футі довжини гряди, загальною довжиною у 200 футів.
Знайти
дисперсію
середнього
систематичної
вибірки, що
включає кожний
двадцятий фут
гряди. Порівняти
її з дисперсією
простої випадкової
вибірки. Для
всіх вибірок
 .
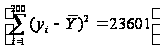
Таблиця 1.11.1 Число саджанців
| Фути довжини гряди | Підсумки систематичних вибірок | ||||||||||
| 1-20 | 21-40 | 41-60 | 61-80 | 81-100 | 101-120 | 121-140 | 141-160 | 161-180 | 181-200 | ||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | ||
|
8 6 6 23 25 16 28 21 22 18 26 28 11 16 7 22 44 26 31 26 |
20 19 25 11 31 26 29 19 17 28 16 9 22 26 17 39 21 14 40 30 |
26 26 10 41 30 55 34 56 39 41 27 20 25 39 24 25 18 44 55 39 |
34 21 27 25 32 43 33 45 23 27 37 14 14 24 18 17 14 38 36 29 |
31 23 41 18 15 21 8 22 11 3 4 5 11 9 25 16 13 22 18 9 |
24 19 28 18 29 24 33 37 32 26 36 20 43 27 20 21 18 19 24 30 |
18 13 7 9 11 20 16 9 14 15 20 21 15 14 13 9 25 17 7 30 |
16 12 8 10 12 20 17 12 7 17 21 26 16 18 11 19 27 29 31 29 |
36 8 29 33 14 13 18 20 13 24 29 18 16 20 6 15 4 8 8 10 |
10 35 7 9 12 7 6 14 12 15 18 4 4 9 8 8 9 10 5 3 |
223 182 188 197 211 245 222 255 190 214 234 165 177 202 149 191 193 227 225 235 |
|
| Підсумки для страт | 410 | 459 | 674 | 554 | 325 | 528 | 303 | 358 | 342 | 205 | 4155 |
Розв’язання.
а) Систематична вибірка:
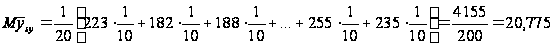
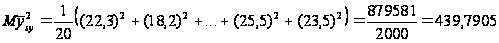
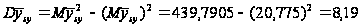
Дисперсія
середнього
систематичної
вибірки дорівнює
 .
б) Проста випадкова вибірка:
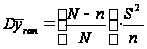
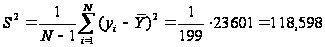
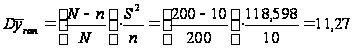
Дисперсія
простої випадкової
вибірки дорівнює
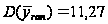 .
Відповідь:
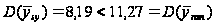 .
Дисперсія
середнього
систематичної
вибірки краща
ніж дисперсія
простої випадкової
вибірки.
Приклад 2. Популяція, що складається з 360 домогосподарств (які перенумеровані від 1 до 360), розміщена в картотеці у алфавітному порядку за прізвищами головних членів господарств. Домогосподарства, де голова сім’ї небілий, мають наступні номери: 28, 31-33, 36-41, 44, 45, 47, 55, 56, 58, 68, 69, 82, 83, 85, 86, 89-94, 98, 99, 101, 107-110, 114, 154, 156, 178, 223, 224, 296, 298-300, 302-304, 306-323, 325-331, 333, 335-339, 341, 342. (Серед небілих іноді зустрічаються «скупчення» домогосподарств через зв'язок між прізвищем та кольором шкіри).
Порівняйте точність систематичної вибірки кожного восьмого домогосподарства з простою випадковою вибіркою того ж обсягу при оцінюванні частки домогосподарств, у яких головний член сім’ї небілий.
Розв’язання.
Будемо позначати домогосподарство, де голова сім’ї небілий як 1 і відповідно де голова білий – 0. Тоді запишемо всі систематичні вибірки кожного восьмого домогосподарства у таблицю 1.11.2:
Таблиця 1.11.2 Дані по 8-ми систематичним вибіркам
|
Номер
систематичної
вибірки ( |
||||||||
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 1 | 0 | 0 | 1 | 1 | |
| 1 | 0 | 0 | 1 | 1 | 1 | 1 | 1 | |
| 1 | 0 | 0 | 1 | 1 | 0 | 1 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 1 | 1 | |
| 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 1 | 1 | 0 | 1 | 1 | 0 | 0 | |
| 1 | 1 | 1 | 1 | 1 | 1 | 0 | 0 | |
| 0 | 1 | 1 | 0 | 1 | 0 | 0 | 0 | |
| 0 | 0 | 1 | 1 | 1 | 1 | 0 | 0 | |
| 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | |
| 1 | 1 | 1 | 0 | 1 | 1 | 1 | 0 | |
| 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | |
| 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | |
| 1 | 1 | 0 | 1 | 1 | 1 | 1 | 1 | |
| 1 | 1 | 0 | 1 | 0 | 1 | 1 | 1 | |
| 1 | 1 | 0 | 1 | 1 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | |
|
|
0,2222 | 0,2667 | 0,1556 | 0,2667 | 0,2667 | 0,2222 | 0,2444 | 0,1556 |
|
|
10 | 12 | 7 | 12 | 12 | 10 | 11 | 7 |


а) Систематична вибірка
Середнє значення систематичної вибірки має розподіл
 ~
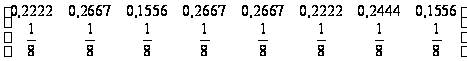
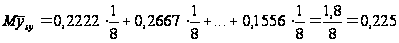
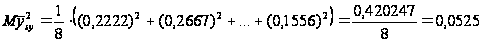
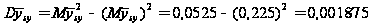
Дисперсія
середнього
систематичної
вибірки дорівнює
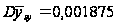 .
б) Проста випадкова вибірка
Частка домогосподарств, де головний член сім’ї не білий дорівнює
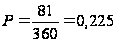
Для простої випадкової вибірки дисперсія вибіркової частки має вигляд:
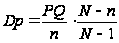 ,
де
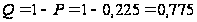 ,
 .
Підставляємо
і отримаємо:
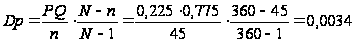 .
Дисперсія
простої випадкової
вибірки при
оцінюванні
частки домогосподарств
з небілим головним
членом сім’ї
дорівнює
 .
Відповідь:
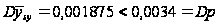 .
Дисперсія
систематичної
вибірки точніша
за дисперсію
простої випадкової
вибірки при
оцінюванні
частки домогосподарств,
де головний
член сім’ї
небілий.
Приклад 3. Є наступний список мешканців 13-ти будинків деякої вулиці. М – дорослий чоловік, Ж – доросла жінка, м – хлопчик, ж – дівчинка.
Сім’ї
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 |
| М | М | М | М | М | М | М | М | М | М | М | М | М |
| Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж | Ж |
| ж | ж | м | м | ж | ж | м | м | м | ж | ж | ||
| м | м | ж | м | м | ж | ж | ж | м | ||||
| ж | ж | ж | м |
Порівняйте дисперсії для систематичної вибірки кожної п’ятої людини та 20%-вої простої випадкової вибірки при оцінюванні: (а)частки людей чоловічої статі, (б) частки дітей. У випадку систематичної вибірки ведіть відлік у кожному стовбці зверху вниз і далі з верху наступного стовпця.
Розв’язання.
Запишемо всі систематичні вибірки кожної п’ятої людини:
М М М Ж ж М М Ж ж М
Ж Ж Ж М М Ж Ж м М Ж
ж ж м Ж Ж ж м М Ж ж
м м ж м ж ж ж Ж ж М
ж ж М м м м М м м Ж
а) Оцінювання частки людей чоловічої статі
Систематична вибірка кожної п’ятої людини


Тоді розподіл середнього має вигляд:
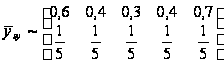 .
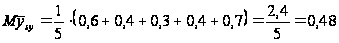
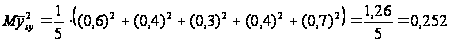
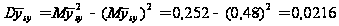
Дисперсія
середнього
систематичної
вибірки дорівнює
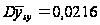 .
20%-ва проста випадкова вибірка
Якщо
 ,
тоді
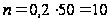 .
Частка людей
чоловічої статі
дорівнює
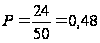
Тоді дисперсія вибіркової частки простої випадкової вибірки дорівнює
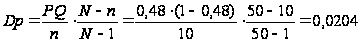
Дисперсія
простої випадкової
вибірки при
оцінюванні
частки людей
чоловічої статі
дорівнює
 .
б) Оцінювання частки дітей
Систематична вибірка кожної п’ятої людини


Тоді розподіл середнього має вигляд:
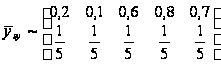 .
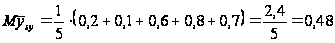
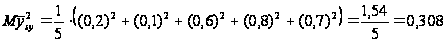
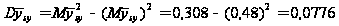
Дисперсія
середнього
систематичної
вибірки дорівнює
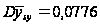 .
20%-ва проста випадкова вибірка
Якщо
,
тоді
.
Частка дітей
дорівнює
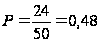
Тоді дисперсія вибіркової частки простої випадкової вибірки дорівнює
Дисперсія
простої випадкової
вибірки при
оцінюванні
частки дітей
дорівнює
.
Відповідь:
а) При
оцінюванні
частки людей
чоловічої статі
отримали, що
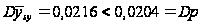 .
Дисперсія
систематичної
вибірки точніша
за дисперсію
20%-ї простої
випадкової
вибірки. Але
можна помітити,
що вони майже
рівні. б) При
оцінюванні
частки дітей
отримали, що
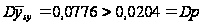 .
В цьому випадку
дисперсія 20%-ї
простої випадкової
вибірки є кращою
ніж дисперсія
систематичної
вибірки.
РОЗДІЛ ІІ. ПОРІВНЯННЯ СИСТЕМАТИЧНОГО ВІДБОРУ, ПРОСТОГО ВИПАДКОВОГО ТА СТРАТИФІКОВАНОГО ВІДБОРІВ
2.1 Місто StatVillage
StatVillage – це гіпотетичне місто, яке складається з окремих домогосподарств і використовується як база даних для студентів та аспірантів, що вивчають вибіркові методи.
Дані домогосподарств для StatVillage обирались навмання з результатів перепису сімей, що мешкали в домогосподарствах у місті Ванкувері, Британській Колумбії, Канаді у 1991 році. Сам перепис населення проходив шляхом анонімного анкетування. Бралися до уваги наступні характеристики:
демографічні показники – розмір домогосподарства та його склад за віком та статтю;
показники доходу – зайнятість, інвестиції, валові витрати, різні доходи домогосподарств та інші;
житлові характеристики – тип житла, рік побудови, своє житло чи орендоване, оціночна вартість, щомісячні витрати на розміщення та інші;
характеристика двох головних членів сім’ї, які відповідають за добробут сім’ї – вік, стать, професія, рідна мова, освіта, зайнятість і т.д;
Існують три конфігурації міста StatVillage:
Maximal village – складається зі 128 блоків, кожен з яких містить 8 домогосподарств (загальна кількість домогосподарств - 1024).
Mini village – складається з 60 блоків, кожен з яких містить 8 домогосподарств (загальна кількість домогосподарств – 480).
Micro village – складається з 36 блоків, кожен з яких містить 8 домогосподарств (загальна кількість домогосподарств – 288).
Кожен блок домогосподарств нумерується в певному порядку, а саме
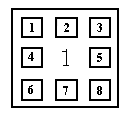
Рис. 2.1.1 Нумерування блоку домогосподарств
Для того, щоб отримати дані з міста StatVillage, необхідно спочатку відмітити домогосподарства позначкою як показано на рисунку 2.1.2 (відмічено кожне 8-ме домогосподарство)
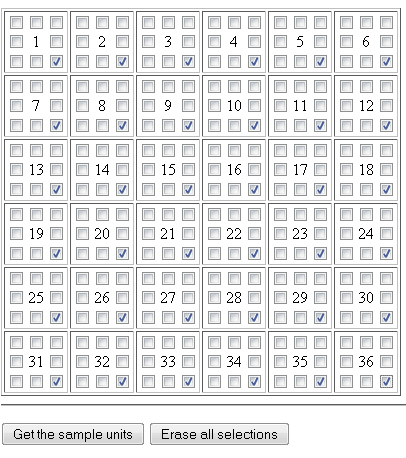
Рис. 2.1.2 Систематичної вибірка кожного восьмого домогосподарства
Після цього натискаємо кнопку «Get the sample units» і отримуємо код, який представлений на рис. 2.1.3