Построение систем распознавания образов
Теоретические основы метода Монте-Карло известны уже давно. Более того, некоторые задачи статистики решались с использованием случайных выборок, то есть, фактически этим методом. Но так как моделировать случайные величины вручную - очень трудоемкая работа, широкое применение метода началось с появления вычислительных машин.
Само название “Монте-Карло” происходит от названия города в княжестве Монако, знаменитого своими игорными домами. Все дело здесь в том, что одним из простейших механических устройств для получения случайных величин является рулетка. Простейшая схема ее - вращающийся диск с цифрами, резко останавливающийся для определения цифры, на которую указывает неподвижная стрелка.
Пуская и останавливая рулетку и объединяя получаемые в каждом пуске цифры в группы заданного размера (например, пять), можно составить таблицу случайных цифр (в случае примера группирования - пятизначную). Таблица эта носит название таблицы случайных чисел, хотя правильнее было бы назвать ее таблицей случайных цифр. Самая большая такая таблица (RAND Corporation, 1955 г) содержит 1 000 000 цифр.
Составление таблиц случайных чисел - не такая простая задача. Если мы хотим иметь хорошую таблицу, то придется при разработке ее тщательно проверять, так как любое физическое устройство вырабатывает случайные числа отличающимися по распределению от равномерного.
Ну, а используются такие таблицы либо для ручного счета, что сегодня - редкость, либо при машинном применении приходится поступаться тем, что при вводе соответствующий файл потребует большой памяти в ущерб решаемым при этом задачам.
Для устранения этого недостатка казалось бы легче подключить рулетку к ЭВМ. Однако ясно, что быстродействие такого комплекса генерации случайных чисел будет исключительно низким. Поэтому в качестве генераторов случайных величин чаще используются шумы в электронных лампах. Например, здесь может быть предложен следующий алгоритм. Если за некоторый фиксированный промежуток времени Dt уровень шума превысил заданный порог четное число раз, то в разряд некоторого числа записывается единица, если нечетное - ноль.
Так как количество такого рода генераторов выбирают равным количеству разрядов упомянутого числа в ЭВМ, то во все эти разряды будут записаны нули и единицы. Каждый такт такой логической проверки всех генераторов дает одно полноразрядное число, равномерно распределенное в интервале [0,1].
Недостатки этого метода генерации:
1)Возможны неисправности электронных генераторов шума, приводящие к пропаданию равновероятности нулей и единиц, что требует постоянных проверок и ремонта.
2)Невозможно повторение случайной последовательности чисел, полученной в одном эксперименте, для проверки работы программы ЭВМ.
Поэтому такого рода датчики применяются в специализированных ЭВМ для решения задач методом Монте-Карло.
Для универсальных ЭВМ такие датчики - слишком дорогостоящее оборудование, так как в таких ЭВМ прибегают к расчетам с использованием случайных чисел достаточно редко. Но чтобы не исключить полностью такую возможность здесь лучше использовать так называемые псевдослучайные числа.
Генерация псевдослучайных чисел осуществляет сама машина в соответствии со специальными стандартными функциями, предусматриваемыми в ее математическом обеспечении.
Можно вообще не интересоваться, как эти числа получаются. Указанные стандартные функции неоднократно проверяются разработчиками и качество их гарантируется. Однако сама постановка вопроса “получение псевдослучайных чисел” на ЭВМ вызывает недоумение. Ведь все, что делает машина, должно быть заранее запрограммировано. Поэтому хотелось бы понимать, откуда появляется случайность. Кроме того, без понимания особенностей псевдослучайных последовательностей, хотя бы поверхностного, трудно говорить иногда о их разумном использовании.
Что же такое псевдослучайные числа?
Числа, получаемые по какой-либо формуле и имитирующие значения случайной величины, называются псевдослучайными.
Под словом “имитирующие” подразумевается, что эти числа удовлетворяют ряду требований так, как если бы они были значениями случайной величины.
Первый алгоритм для получения псевдослучайных чисел был предложен Дж.фон Нейманом в 1951 г. Он получил название метода середины квадратов. . Существо его заключается в следующем.
Пусть задано произвольное 4-значное целое число n1= 9876.
Возведем его в квадрат и получим 8-значное число n12 = 97535376.
Выберем 4 средние цифры из этого числа и обозначим n2= 5353.
Затем снова возведем его в квадрат n22 = 28654609 и выберем 4 средние цифры. В результате получим n3 = 6546.
Продолжая указанные рекуррентные действия будем иметь
n4 = 8501; n5 = 2670; n6 = 1289 и т.д.
В качестве псевдослучайных значений предлагалось использовать
gк = 10 -4 *n к ,
то есть:
0.9876; 0.5353; 0.6546; 0.8501; 0.2670; 0.1289 и т.д.
Таков самый простой алгоритм, обладающий отдельными недостатками, на которых не будем задерживать внимание. Главное то, что они заставили в последующем обратиться к более сложным алгоритмам. Но схема получения псевдослучайных чисел осталась фактически неизменной: очередное значение получается из предыдущего или предыдущих.
Рассмотрение теории вопроса и других алгоритмов не входит в планы нашего курса, но нам необходимо знать один важный вывод из соответствующих разделов, имеющий практическое значение:
рекуррентно получаемые псевдослучайные последовательности обладают периодом, величина которого зависит главным образом от разрядности представления чисел в машине.
С точки зрения теории вероятностей - это плохо. Однако там, где длины генерируемых последовательностей удовлетворяют потребителя, появляется такое достоинство как возможность отработки программного обеспечения сложных систем при одних и тех же последовательностях.
Ну, а рекуррентность получения псевдослучайных последовательностей и определенный период позволяют повторять генерацию последовательности любое число раз, что невозможно для физических датчиков случайных чисел и что так важно для отладки специфических программ.
В целом достоинства методов получения псевдослучайных чисел заключаются в следующем:
1) на получение каждого числа затрачивается всего несколько простых операций, в результате чего скорость генерирования случайных чисел имеет тот же порядок, что и скорость работы ЭВМ.
2) программы получения псевдослучайных чисел чрезвычайно компактны в силу простоты рекуррентных соотношений.
3) любое псевдослучайное число может быть легко воспроизведено.
4) последовательность псевдослучайных чисел достаточно один раз аттестовать, а затем постоянно использовать в сходных задачах без опасения изменения характеристик.
Л Е К Ц И Я 5.4
Метод статистических испытаний
(продолжение)
5.4.1. Моделирование независимых случайных событий
Возможность генерации псевдослучайных чисел, равномерно распределенных на интервале [0,1], открывает широкие возможности для статистического моделирования вообще во всех его приложениях.
Наиболее важным в задачах статистических испытаний представляется моделирование независимых случайных событий. Здесь существо задачи состоит в том, что необходимо воспроизвести случайное событие А, наступающее с вероятностью p.
Если для этого воспользоваться квазиравномерной последовательностью, то интересующая вероятность в общем виде может рассматриваться как результат интегрирования соответствующей плотности распределения вероятностей
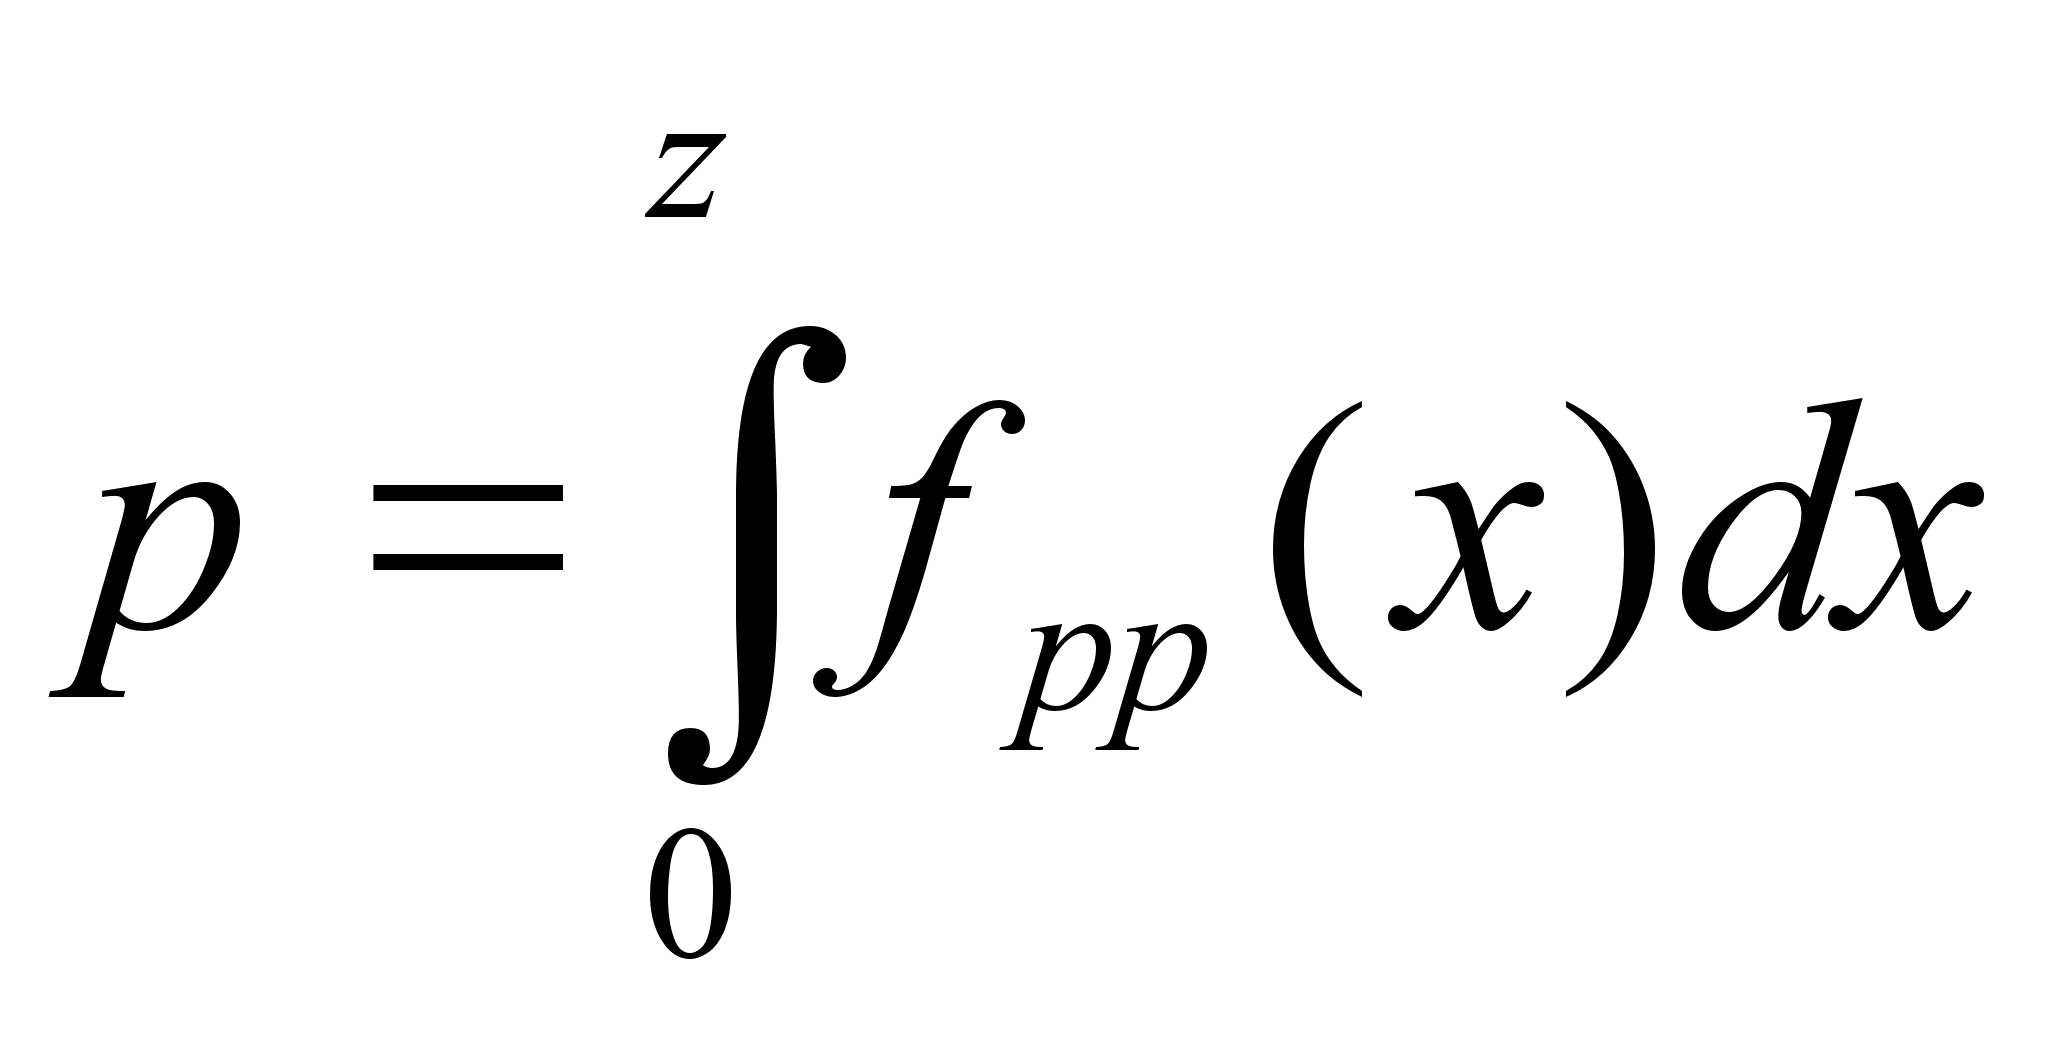
где z - некоторый пока неопределенный предел; fрр(x)- плотность вероятностей равномерно распределенных чисел.
Но для равномерного распределения на интервале [a,b] имеем
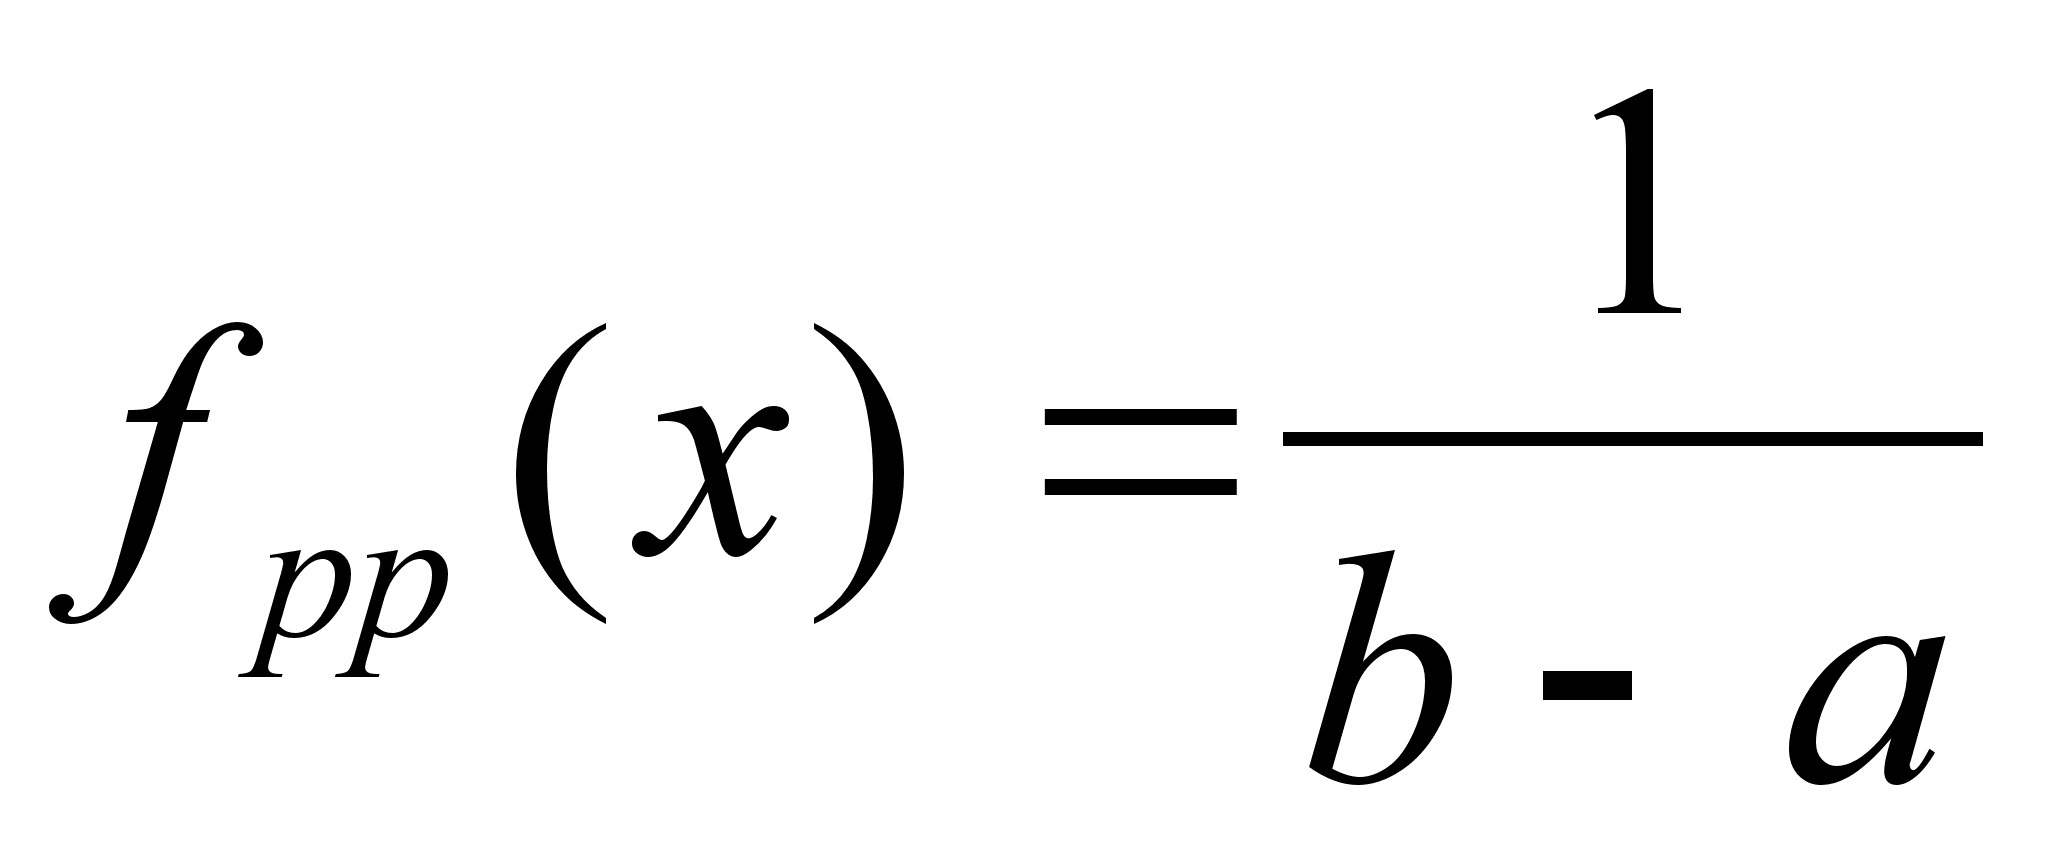
Для чисел равномерных на интервале [0,1] будем иметь
f рр(x)= 1 и соответственно
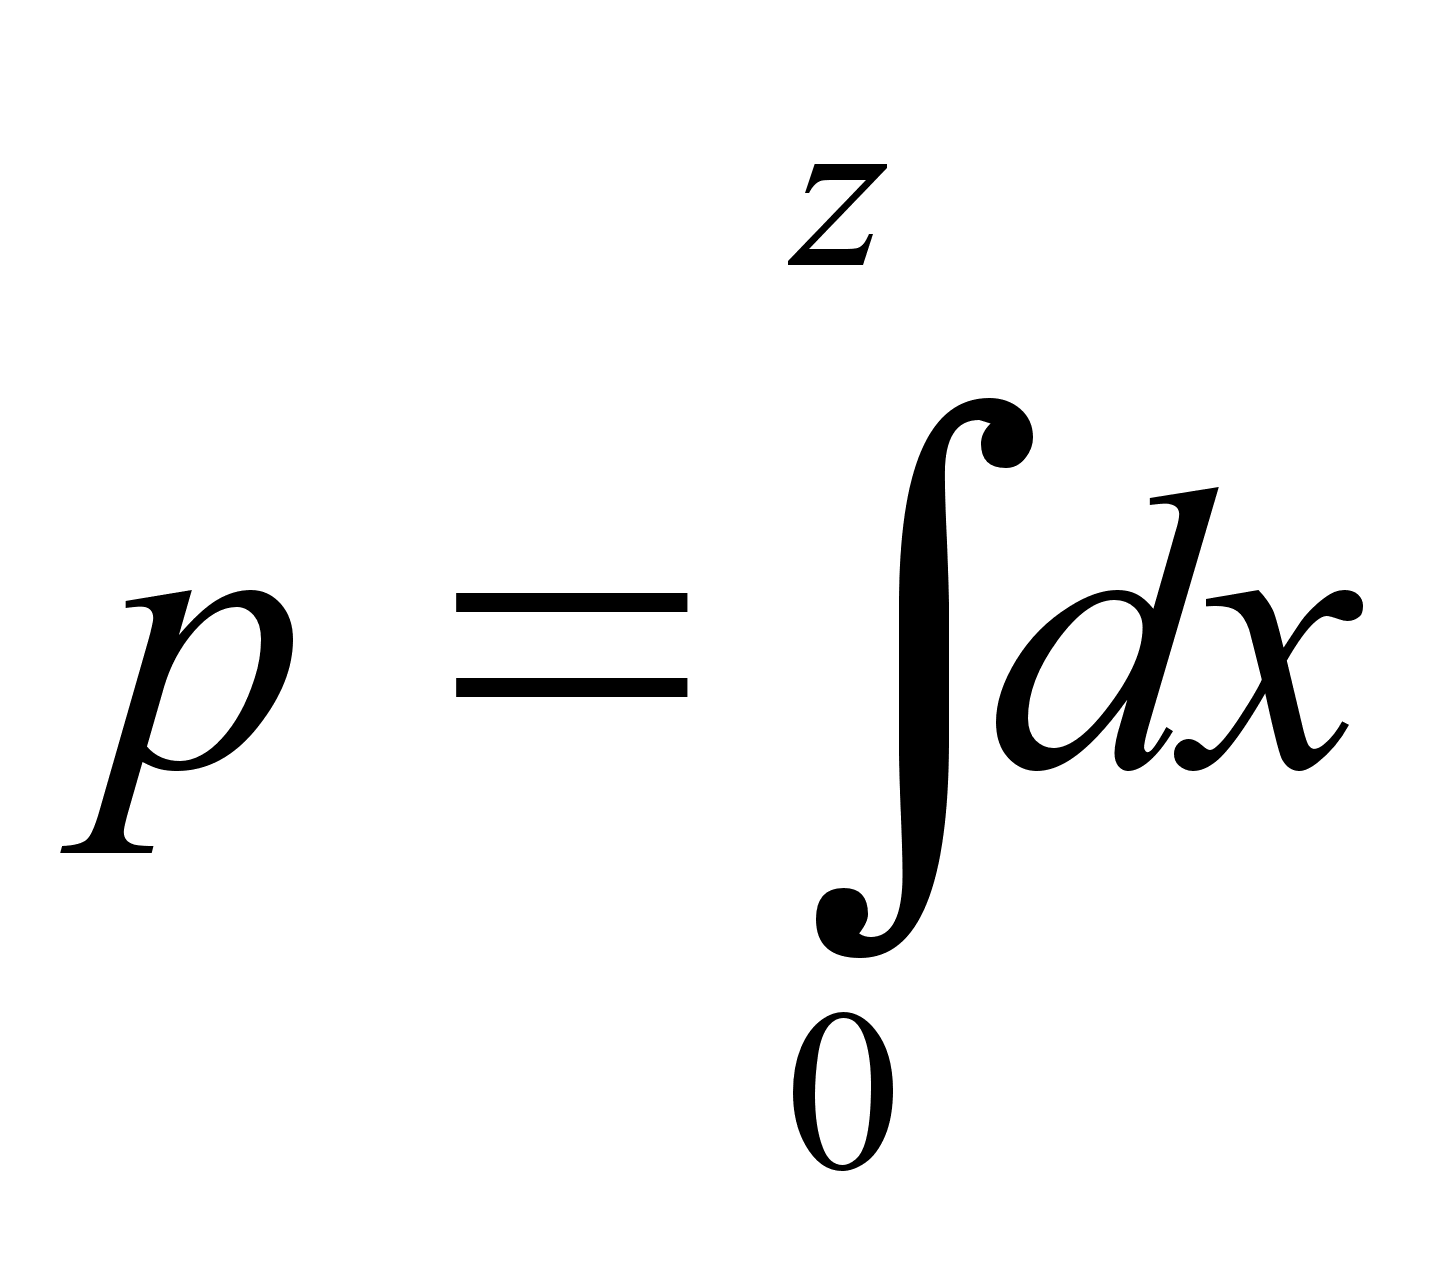
Отсюда очевидно z = p.
Тогда понятно, что реализация события А с вероятностью p осуществляется тогда, когда равномерно распределенные числа на интервале [0,1] попадают в его часть [0,p].
Следовательно, процедура моделирования появления случайного события А должна состоять в генерации случайных чисел R 4i 0 и сравнении их с величиной p : Ri <= p
Выполнение неравенства соответствует наступлению события А.
Рассмотренные соображения распространяются на моделирование полной группы событий . A1,A2,…,Am , наступающих с вероятностями p1,p2 ,…,pm, для которых естественно определено:
p1 + p2 +…+ pm = 1.
Здесь, используя ту же квазиравномерную последовательность, можем записать условия наступления любого события As из представленной группы:
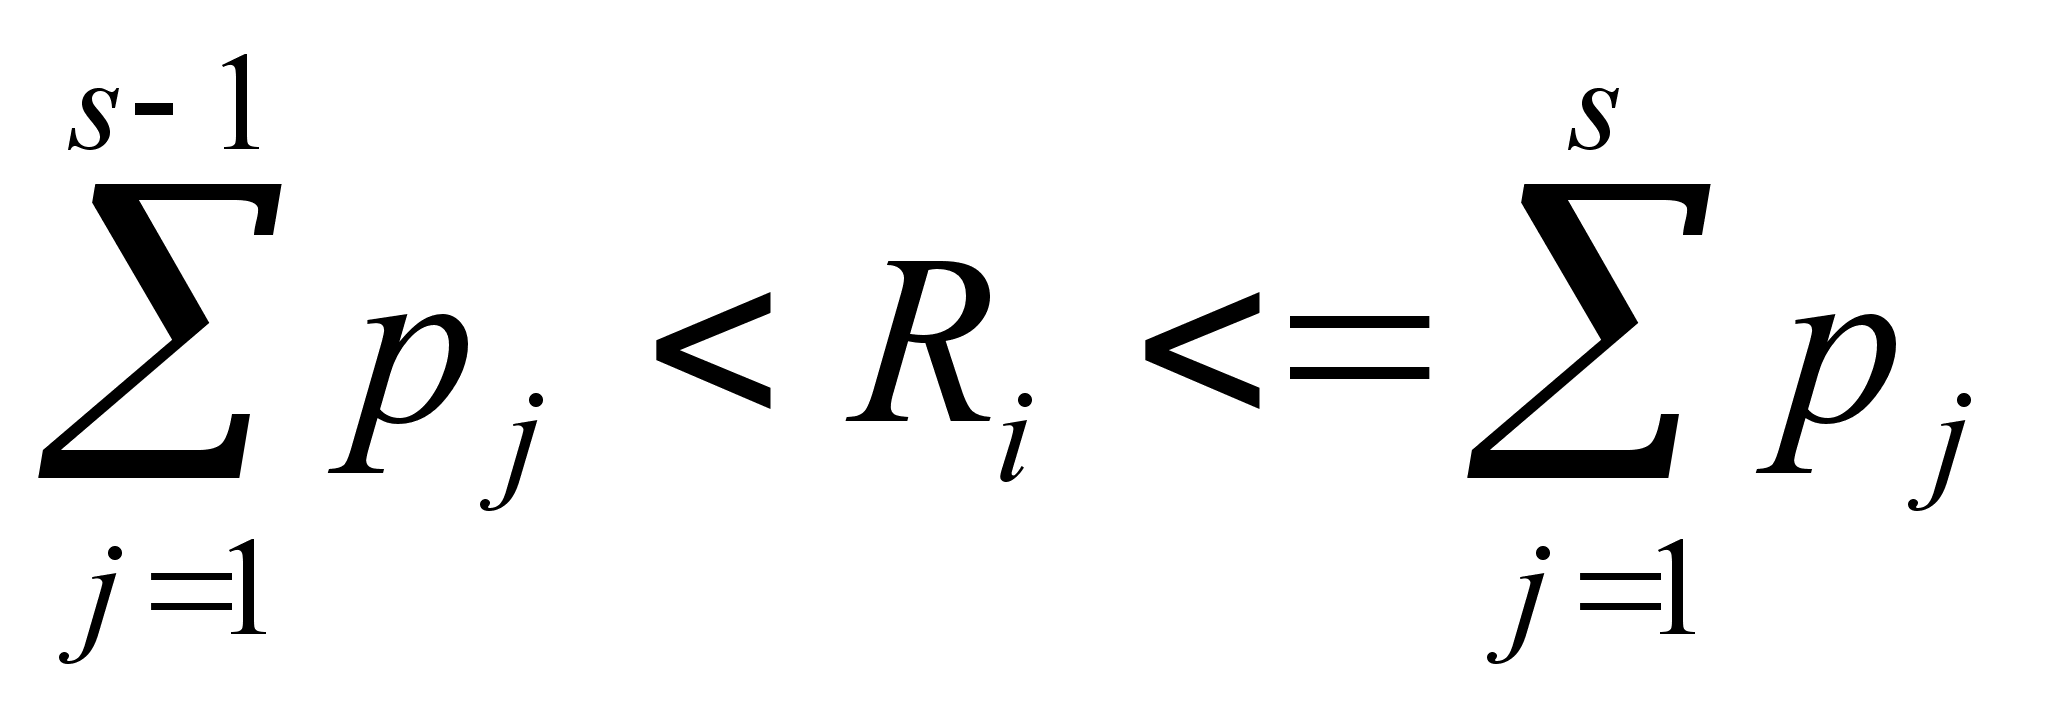
Тогда действительно:
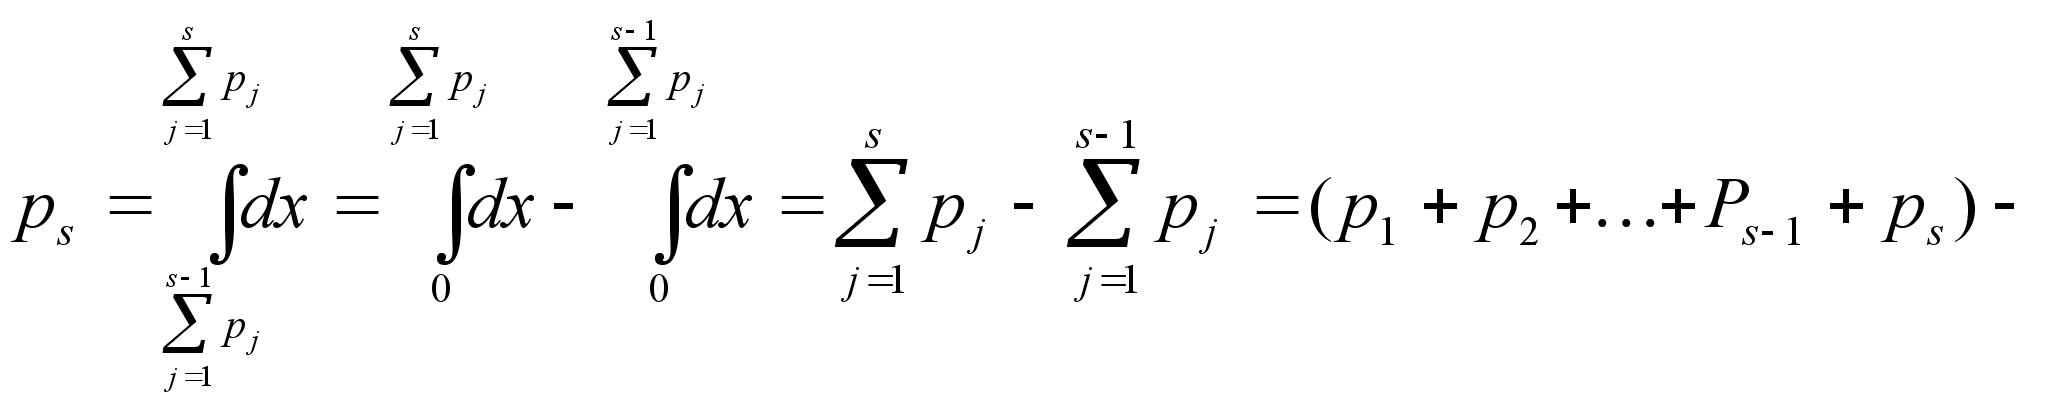
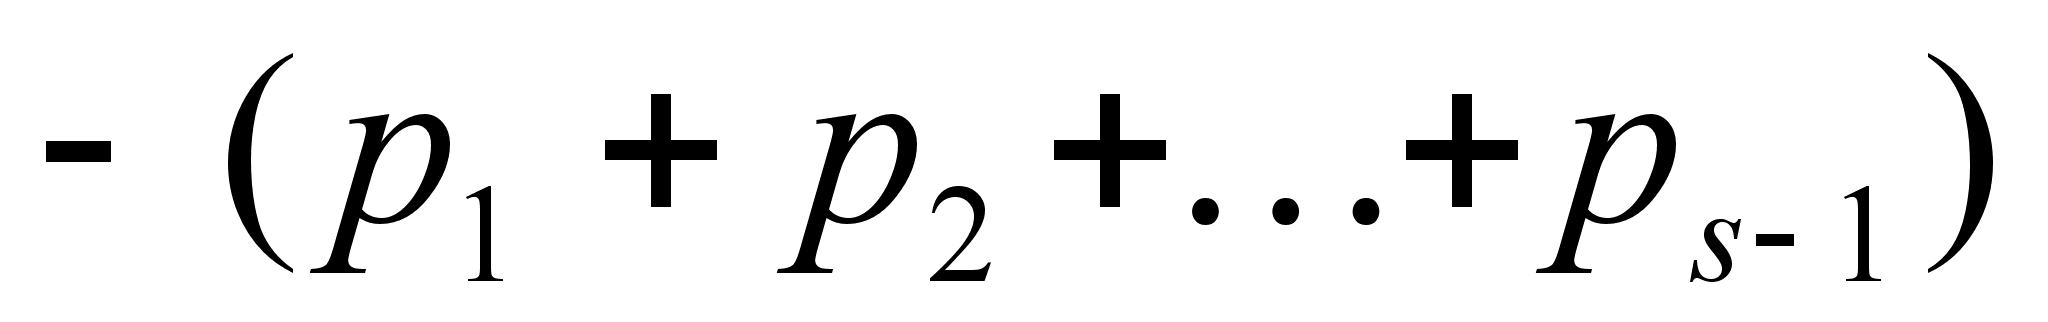
что и требовалось доказать.
Процедура моделирования появления событий As (s=1,m) состоит в рассмотренном случае в генерации последовательности Ri и проверки попадания ее в интервалы
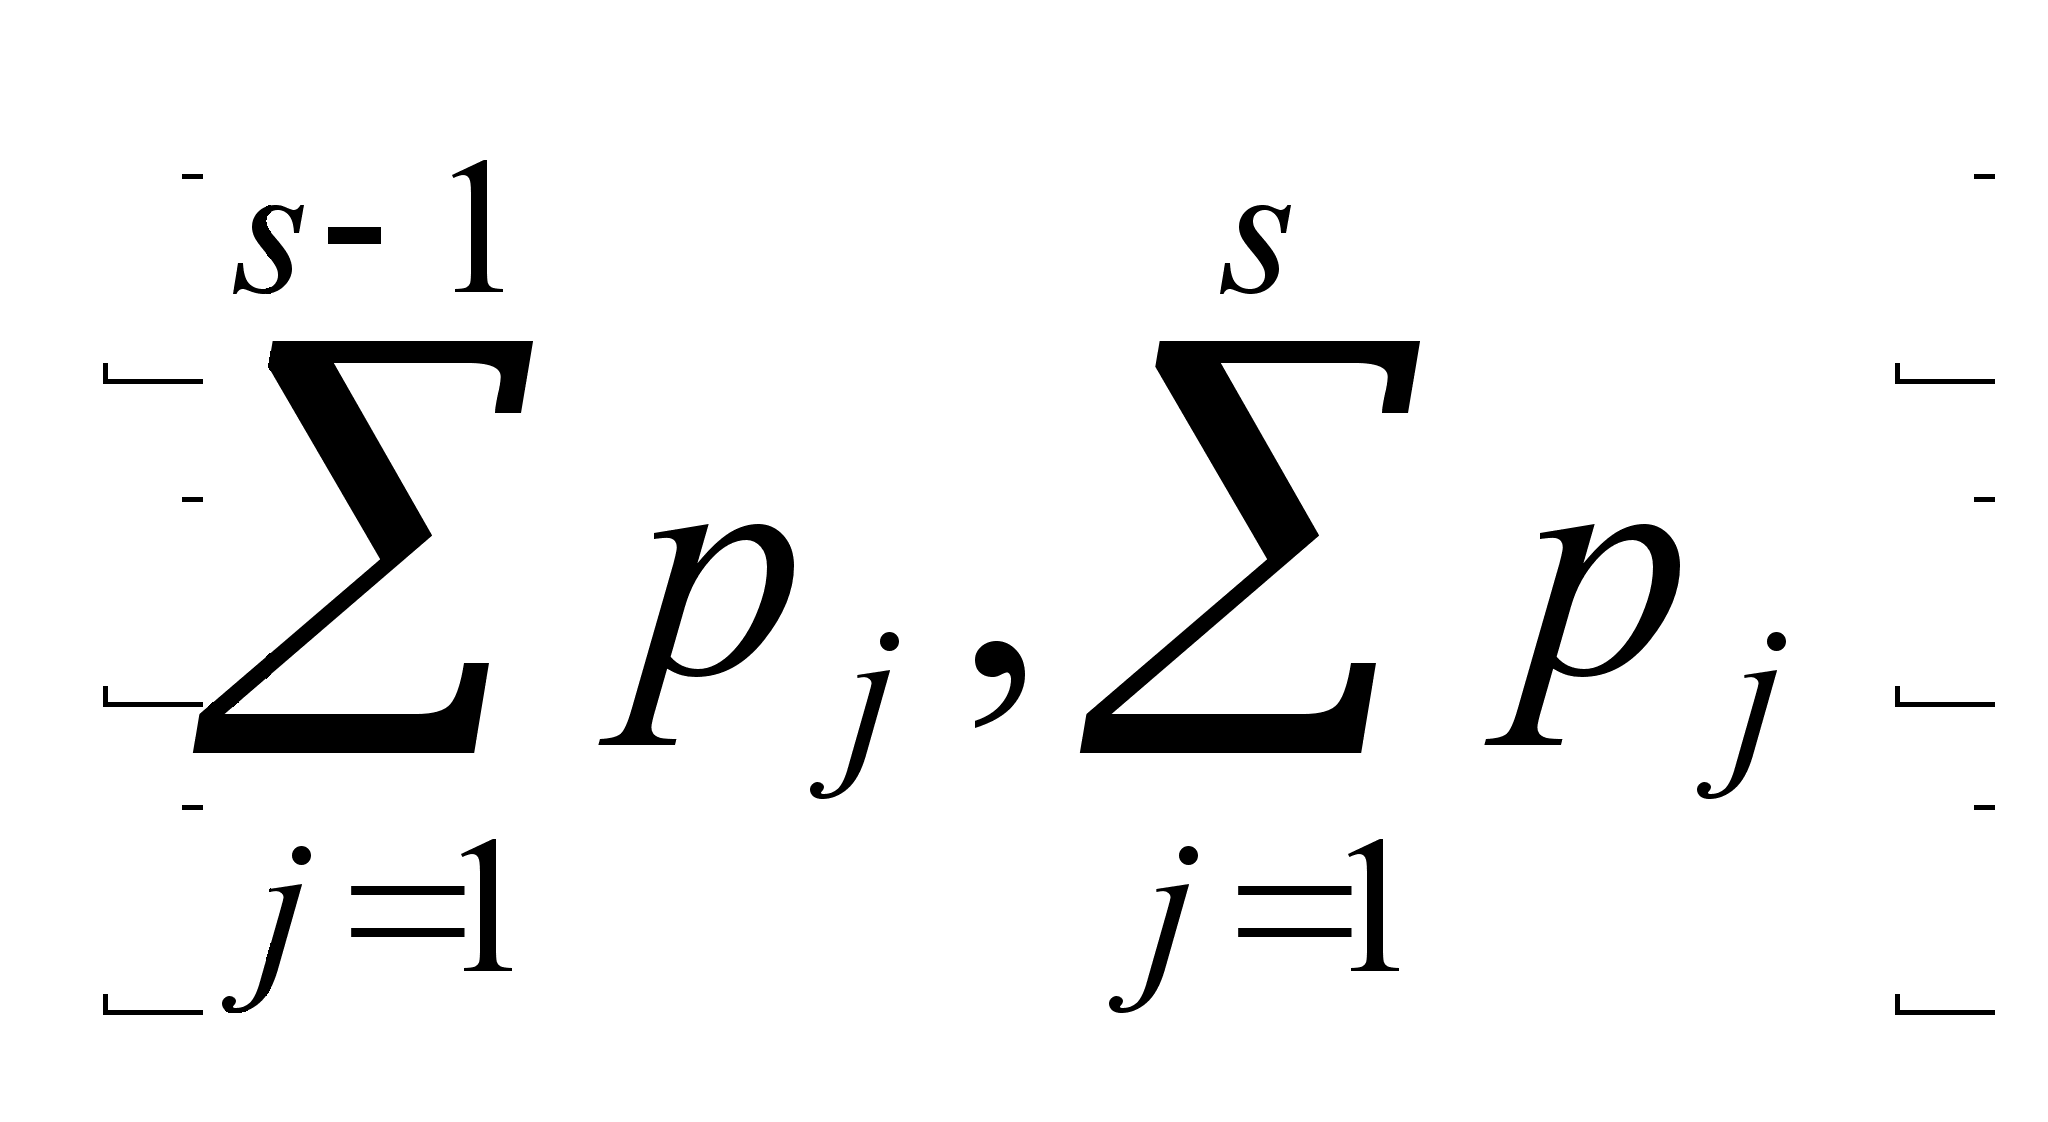
Исходом испытания при этом будет появление того события As, номеру которого соответствует выполненное неравенство, а значит интервал.
5.4.2. Способы получения случайных чисел с заданным законом распределением
Основным соотношением, связывающим случайные числа Si, имеющие заданный закон распределения f(x), и числа Ri, равномерно распределенные на интервале [0,1], является:
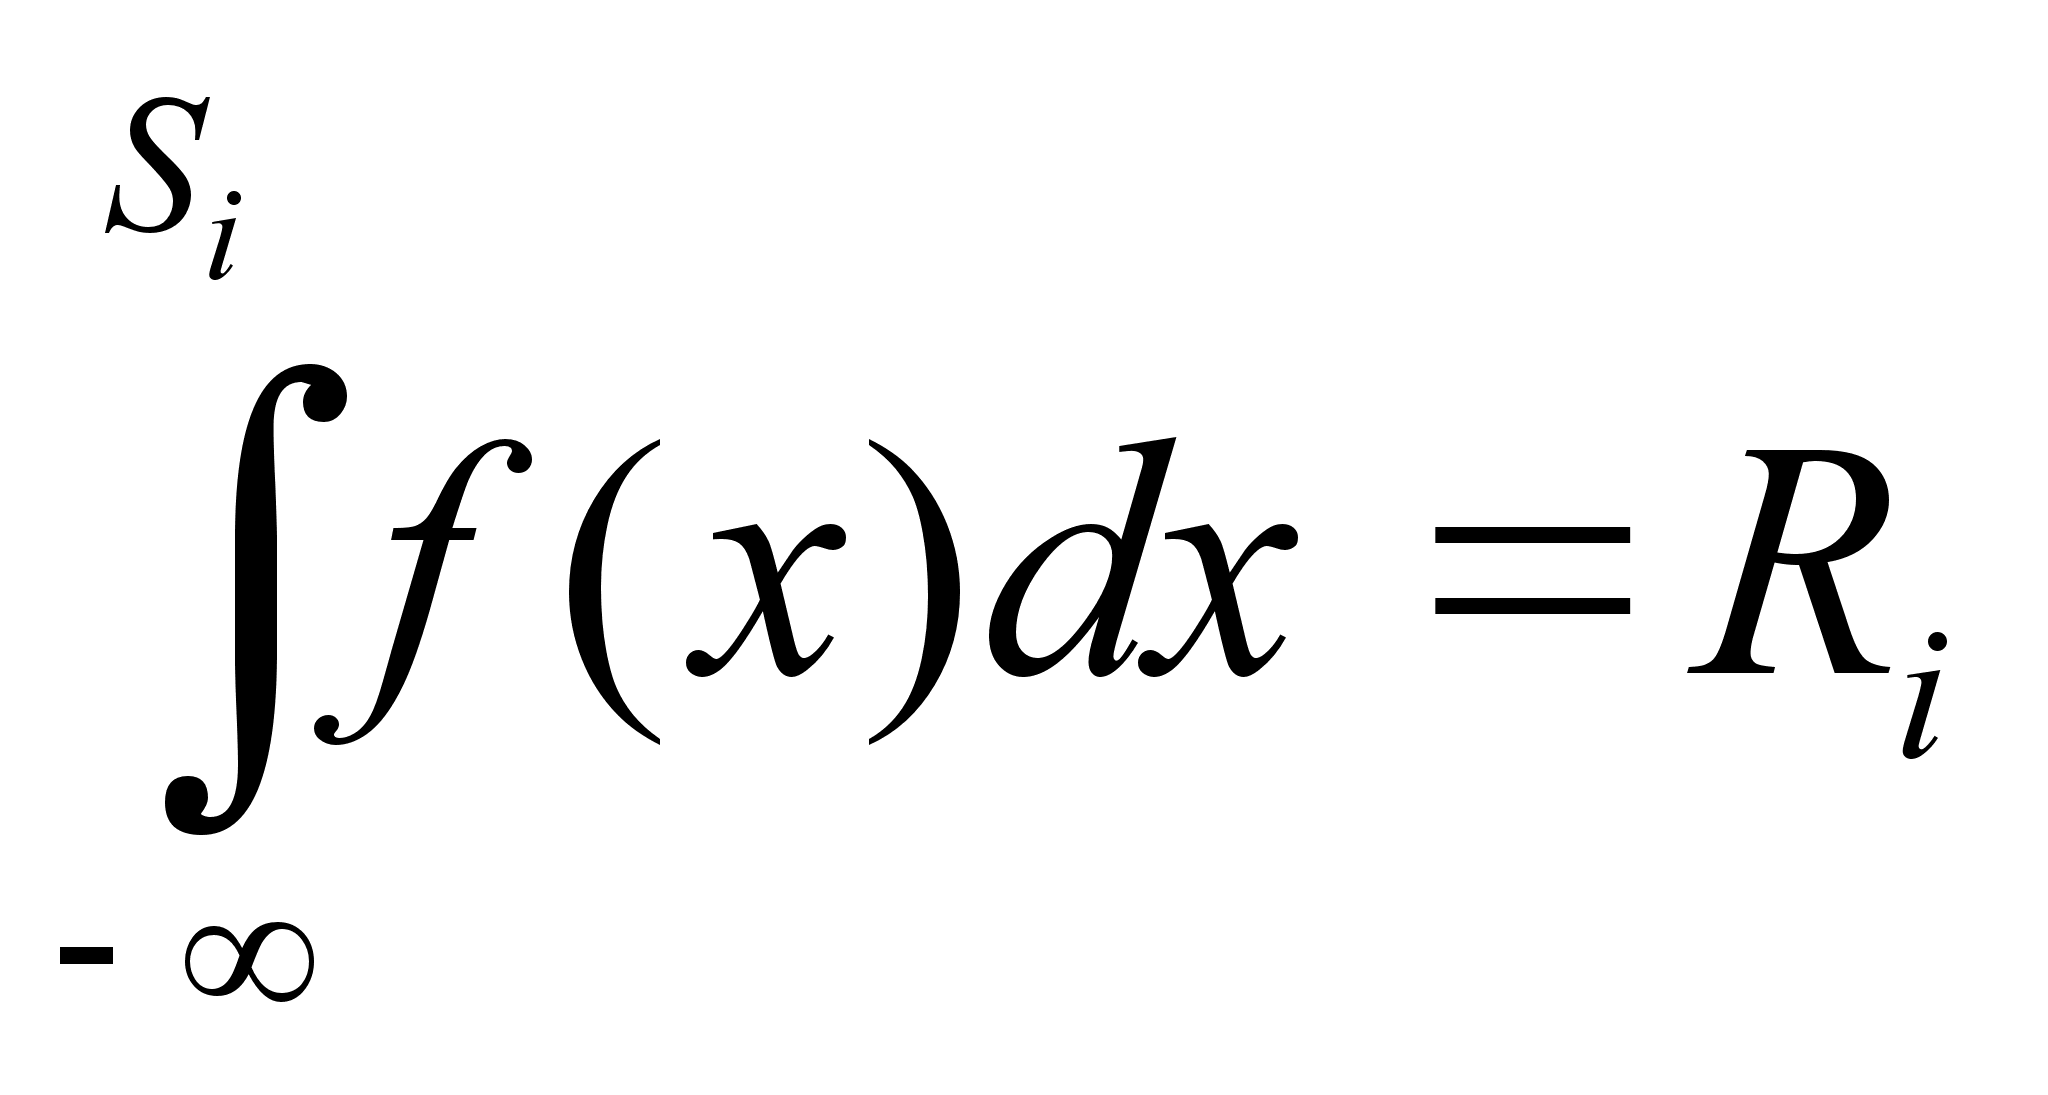
Доказательство справедливости этого соотношения следует из того факта, что
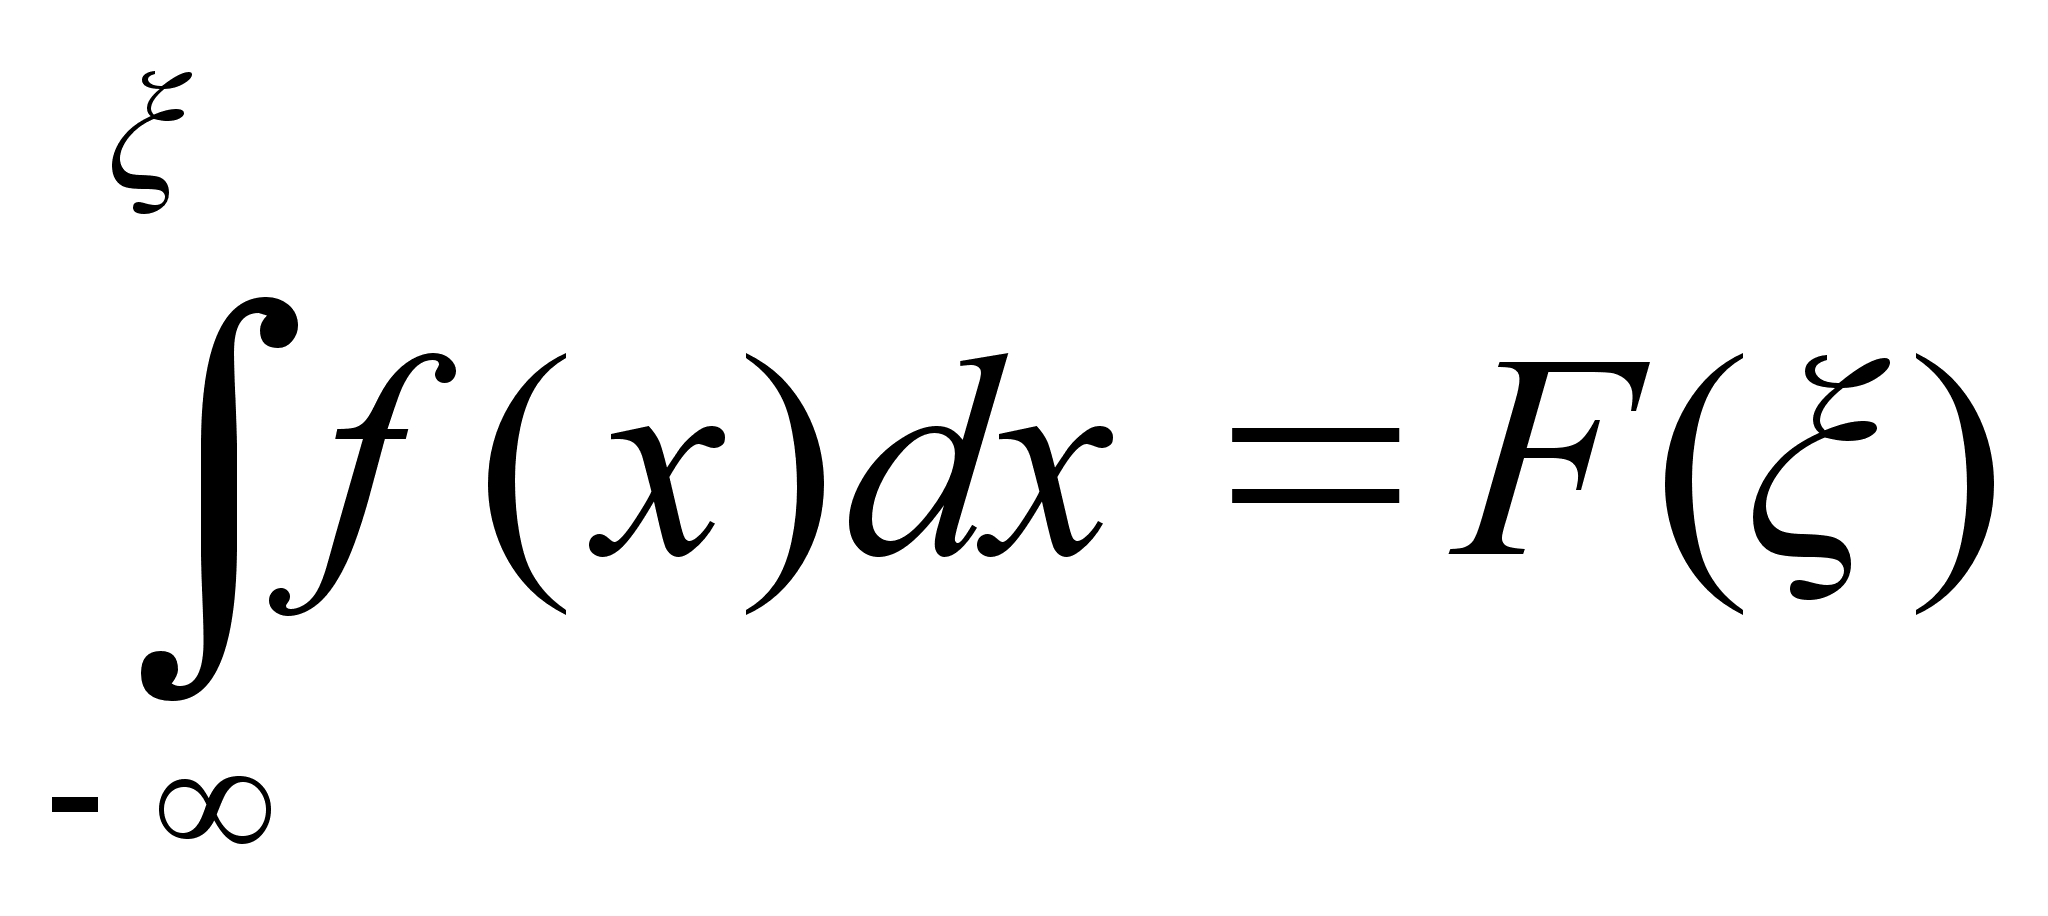
где F(x) - интегральная функция распределения вероятностей, являющаяся однозначной функцией своего аргумента.
При этом F( x) изменяется от 0 до 1 при изменении x от - Ґ до + Ґ.
Таким образом, для аргумента, лежащего в интервале - Ґ < x < + Ґ, функция 0 < F(x) < 1, что соответствует числам последовательности, равномерно распределенным на интервале [0,1].
Возвращаясь к исходному выражению
заметим, что для получения числа, принадлежащего совокупности {Si}, имеющей плотность распределения f(x), необходимо приведенное уравнение разрешить относительно Si .
Пусть, например, требуется получить случайные числа с экспоненциальным законом распределения
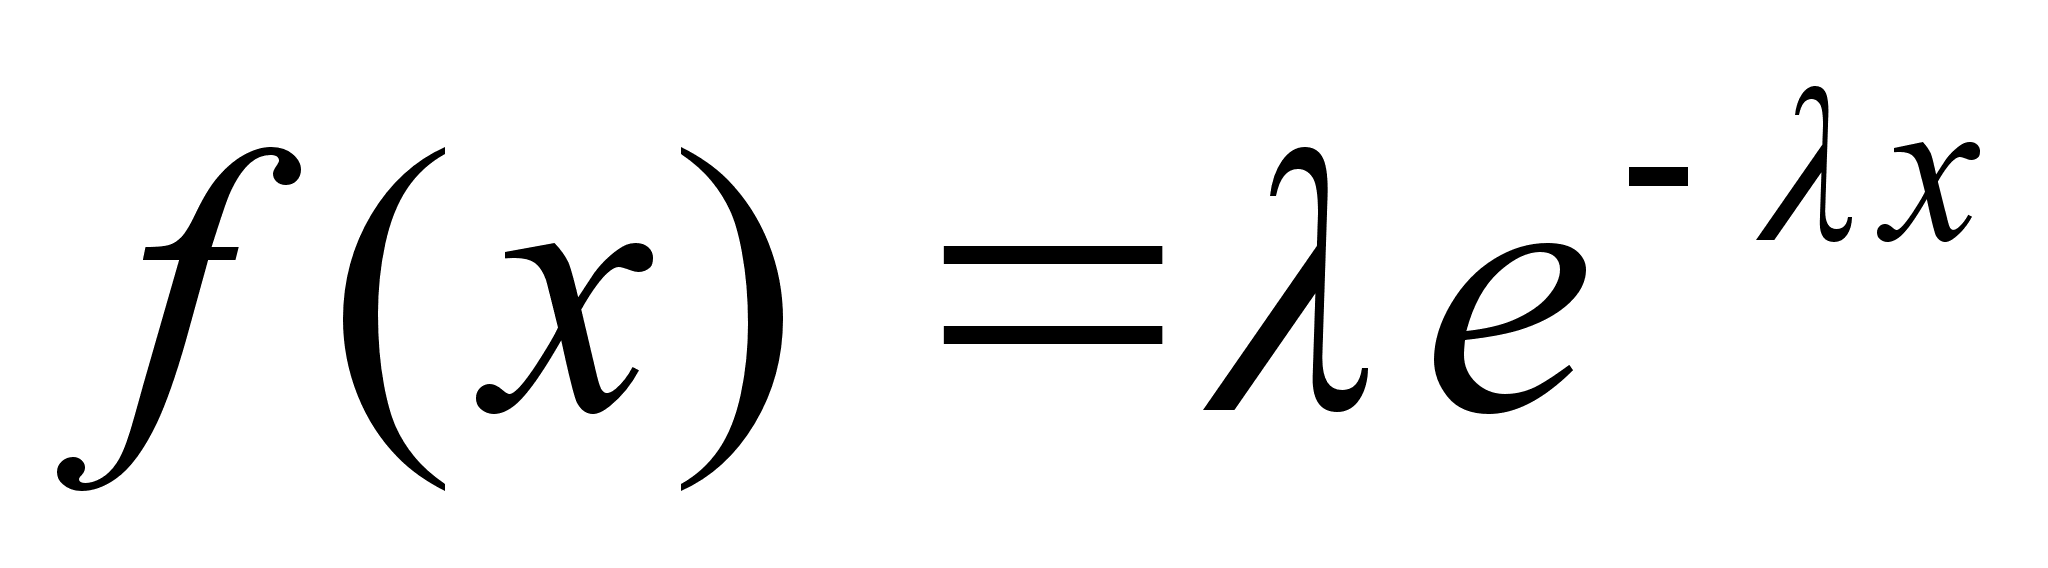
В силу приведенного соотношения преобразования имеем
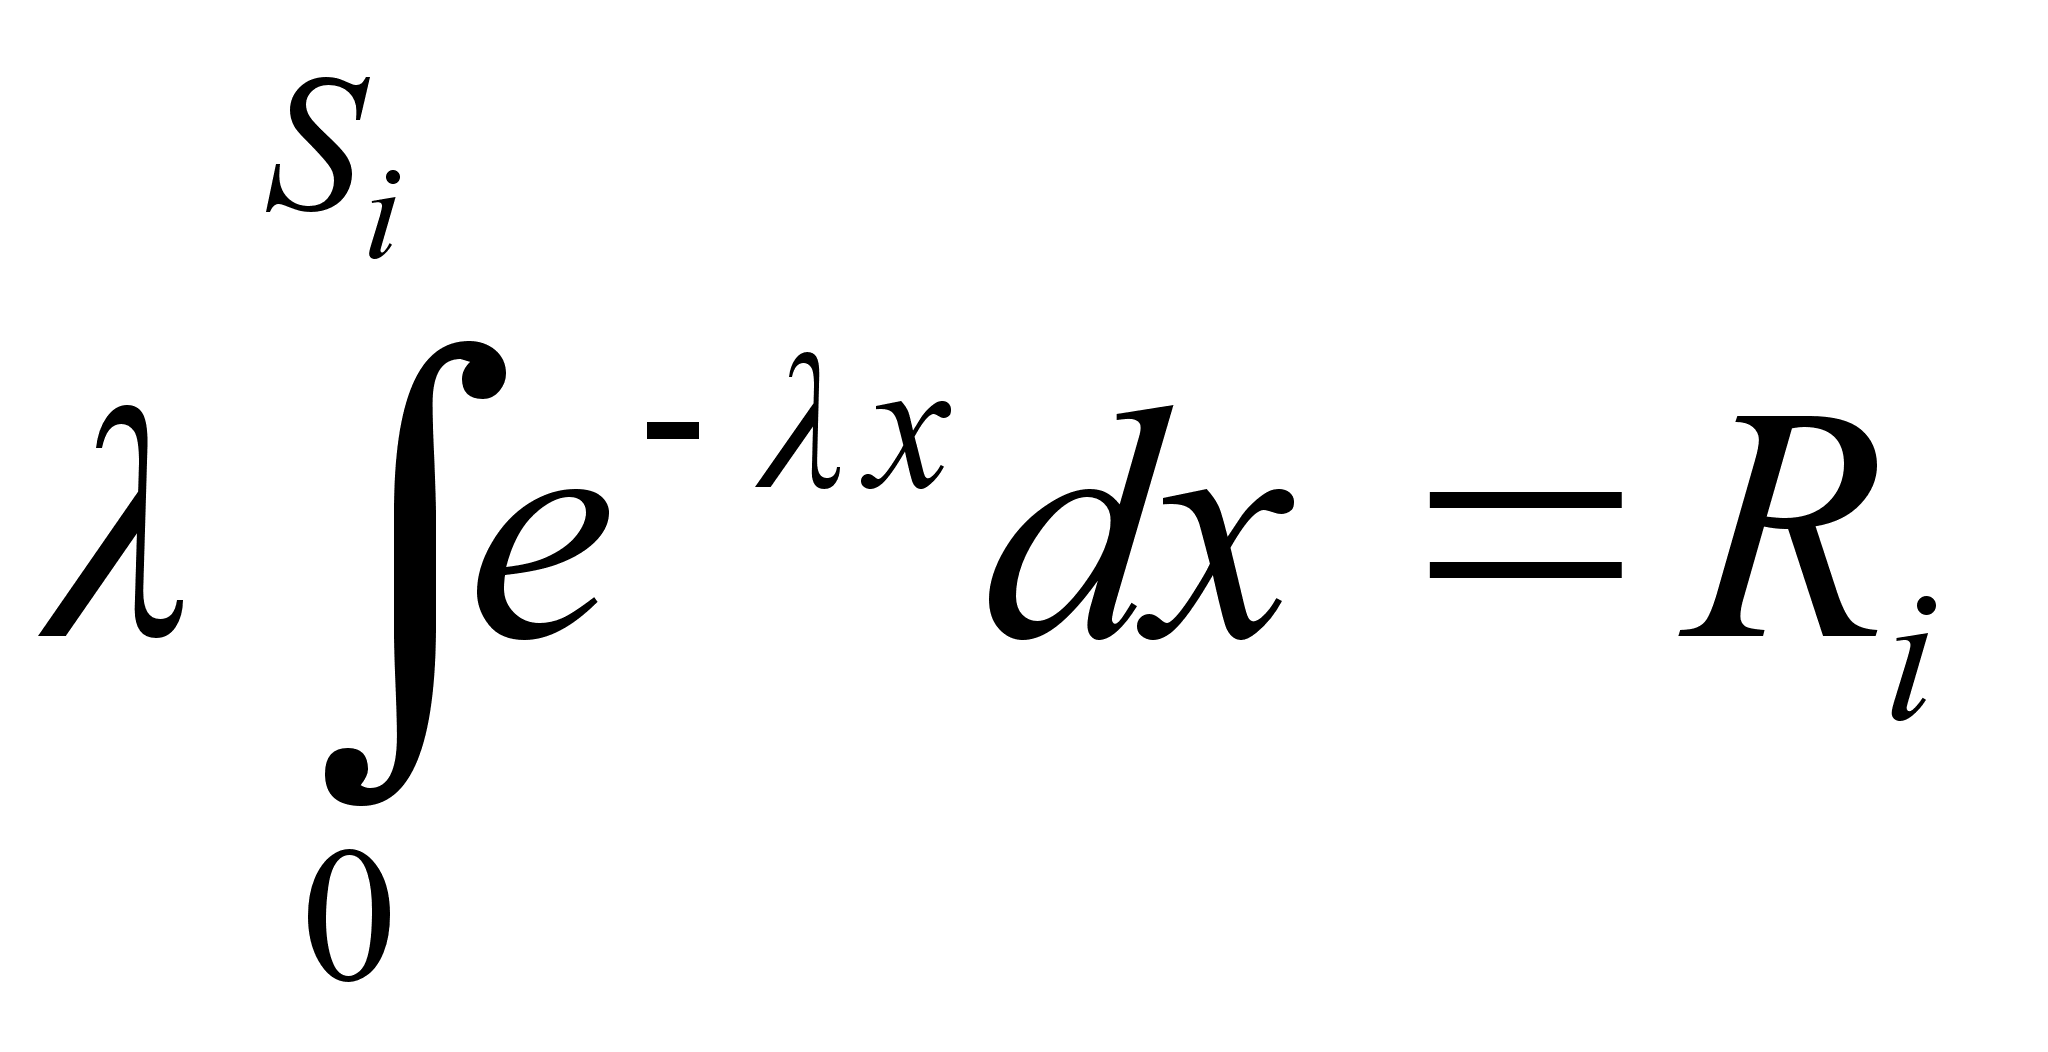
Интегрируя, получим
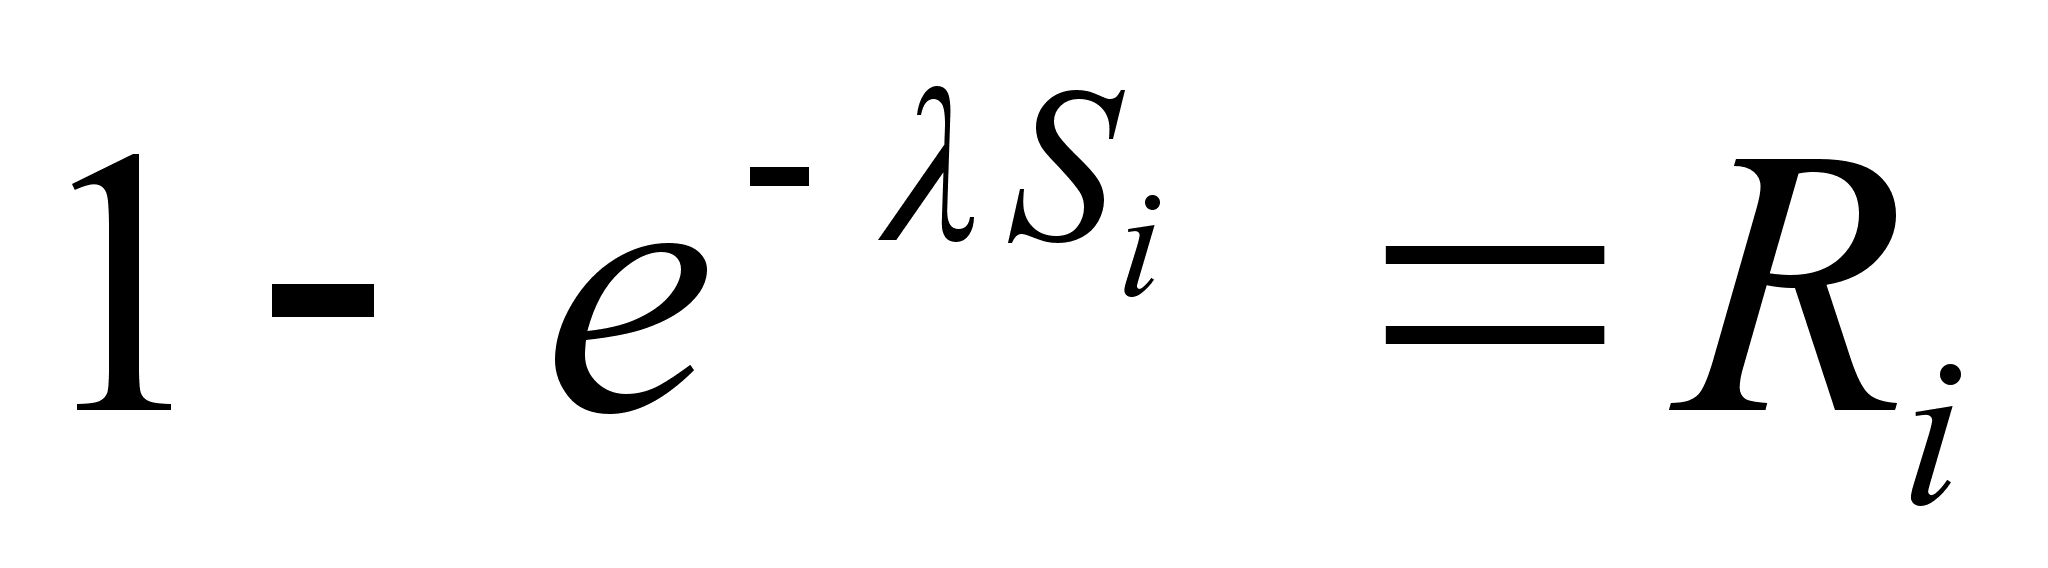
Отсюда
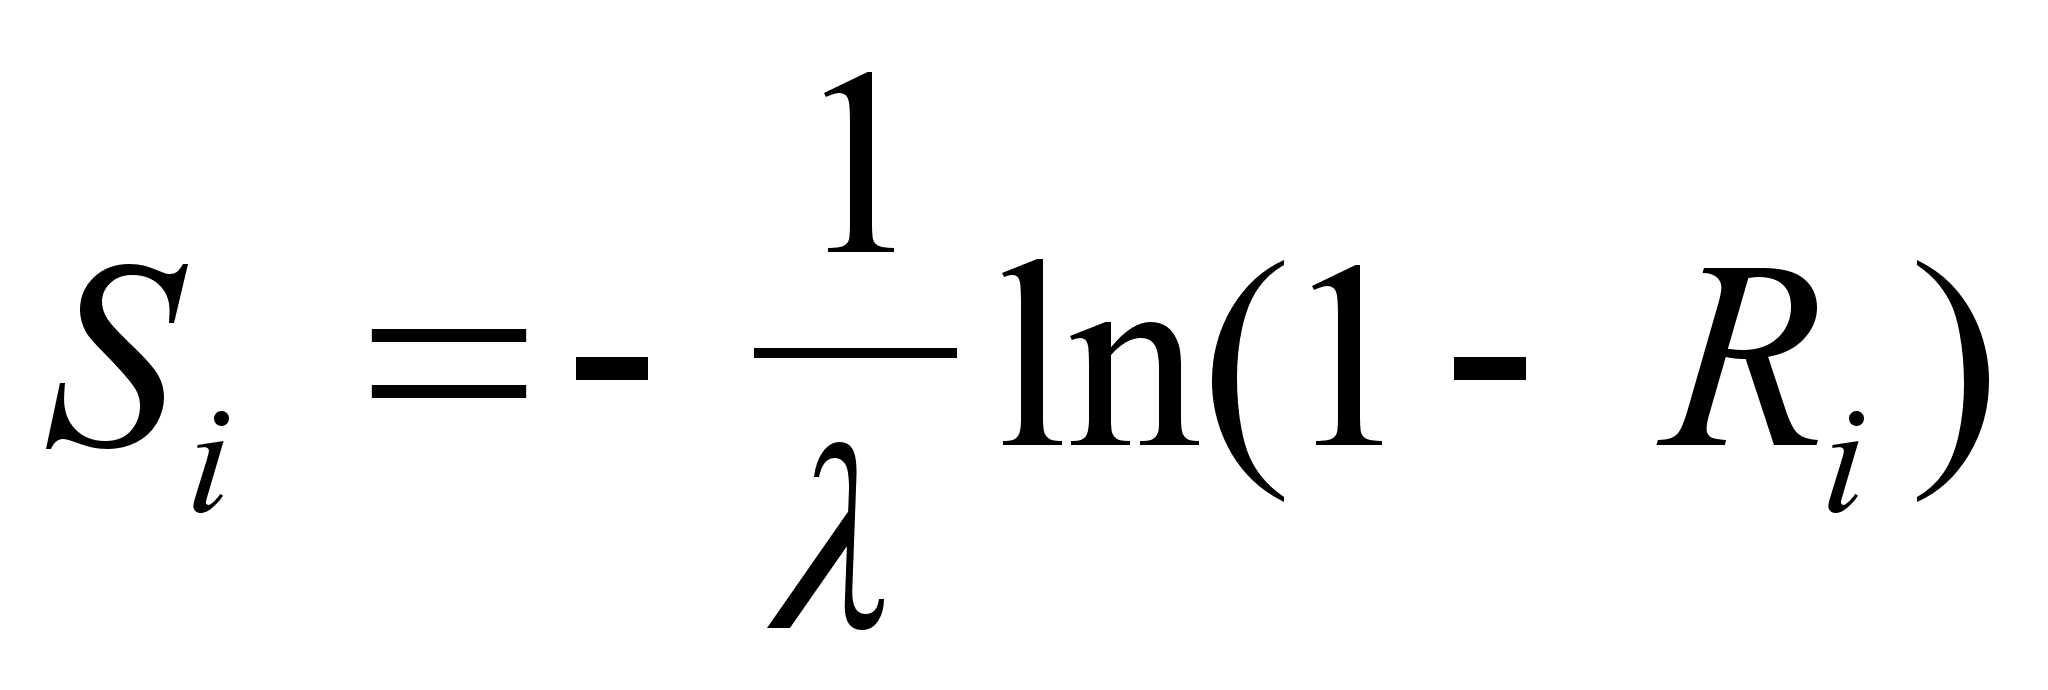
Понятно, что генерация равномерной последовательности значений в интервале [0,1] и подстановка их в полученное выражение обеспечивает генерацию случайной последовательности с экспоненциальным законом распределения вероятностей.
При попытке преобразования равномерного распределения в заданное может оказаться, что разрешить уравнение
относительно Si, как это проделано в примере, весьма трудно. Это случается, например, когда интеграл от f(x) не выражается через элементарные функции или когда плотность f(x) задана только графически.
В такой ситуации для преобразования используется метод Неймана.
Условия для его реализации:
случайная величина x может быть определена на интервале [a,b];
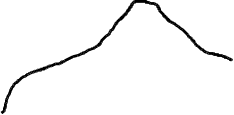
плотность распределения вероятностей f(x) на интервале [a,b] ограничена f(x) <= Mo.
Разыгрывание (генерация) значений x, распределенных с плотностью вероятностей f(x), осуществляется следующим образом:
1)Генерируем два случайных значения R1 и R2 величины равномерно распределенной на интервале [0,1] и получаем случайную точку на графике f(x) с координатами
x’ = a + R1*(b - a)
y’ = R2* Mo
 y
Mo

 y’ Г

 a x’
b x
Рис.5.4.1.
2)Если полученная точка лежит под кривой y = f(x), то полагаем, что первое значение случайной величины, соответствующей плотности распределения вероятностей f(x) равно
x1 = a + R1*(b - a) = x’
Если же полученная точка лежит над кривой y =f(x), то пара случайных чисел R1 и R2 отбрасывается, выбирается новая R3 и R4 и операции пп.1,2 повторяются.
Случайные числа xi, полученные таким образом, имеют плотность распределения вероятностей f(x).
Получение случайных величин, плотность вероятностей которых - нормальный закон, имеет свои особенности.
Основное уравнение преобразования в этом случае имеет следующий вид:
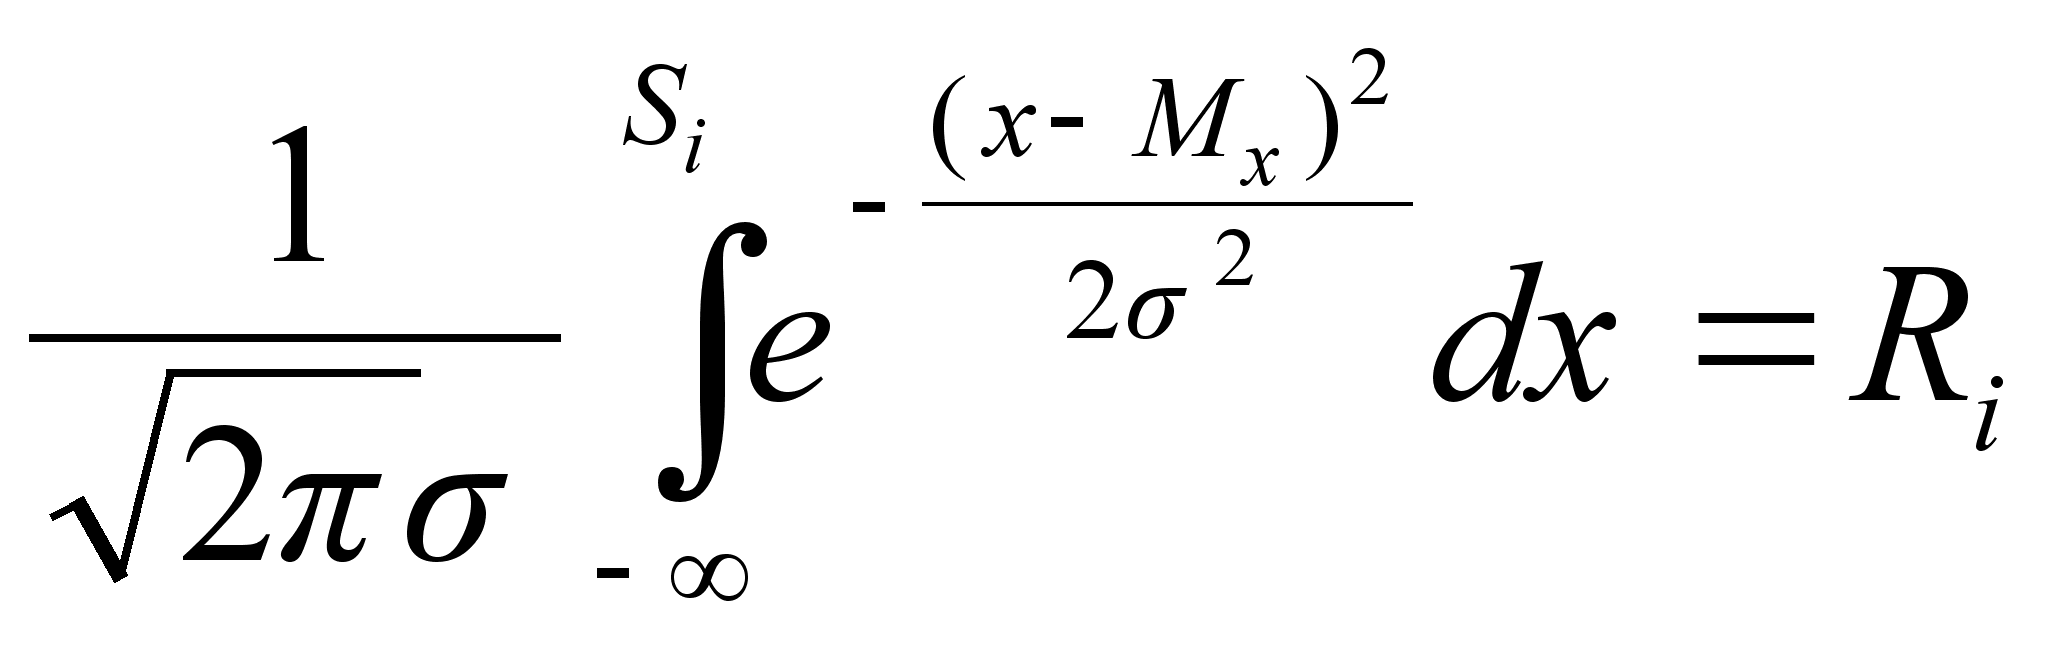
В явном виде оно неразрешимо. Поэтому приходится использовать другой путь. Так согласно центральной предельной теореме теории вероятностей известно, что нормальный закон распределения возникает во всех ситуациях, когда случайная величина может быть представлена в виде суммы достаточно большого числа независимых (или слабо зависимых) элементарных слагаемых, каждое из которых в отдельности мало влияет на сумму. Это дает возможность приближенно моделировать нормальную плотность распределения вероятностей суммированием чисел, равномерно распределенных на интервале [0,1]:
a = g1 + g2 + .....+ gn
Эта сумма
асимптотически
нормальна с
МО
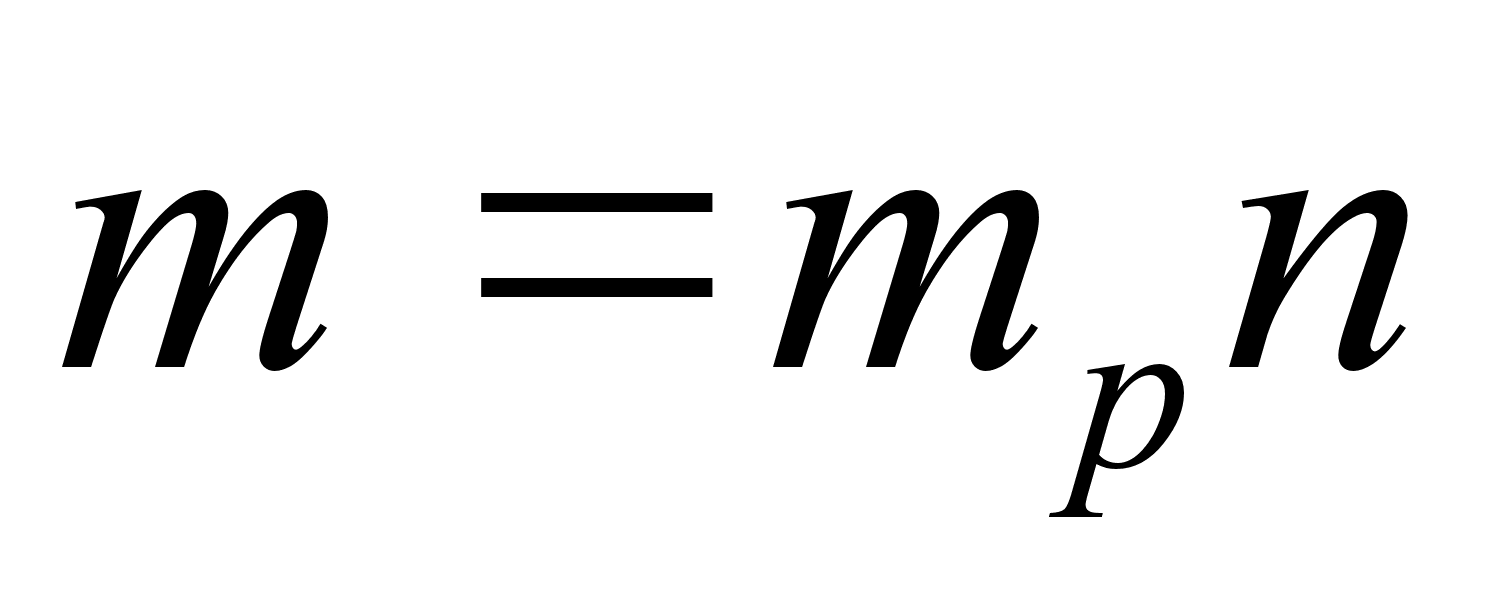 и с СКО
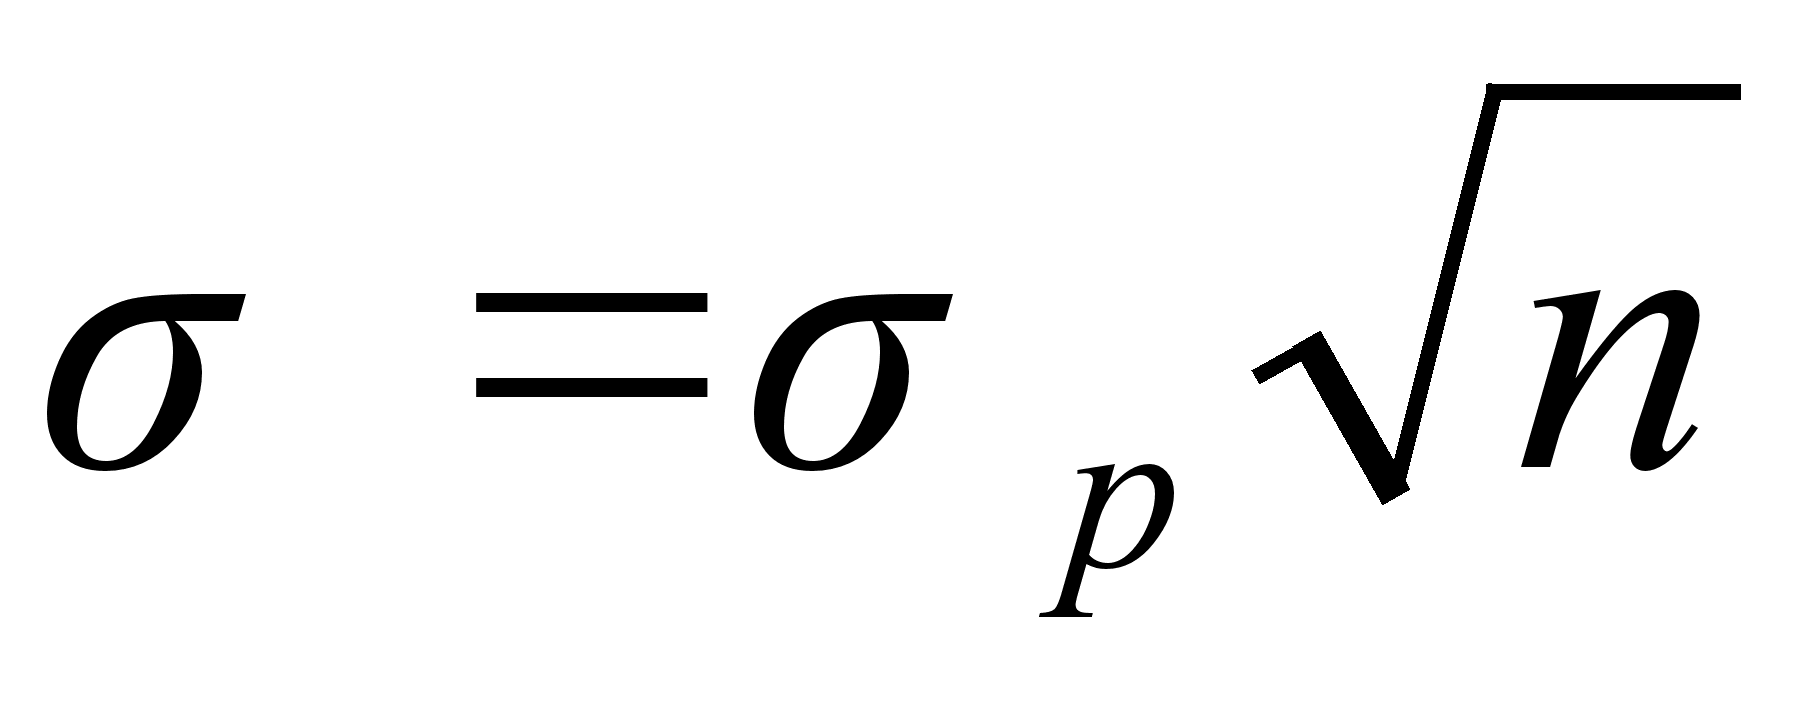
Но для равномерной плотности распределения
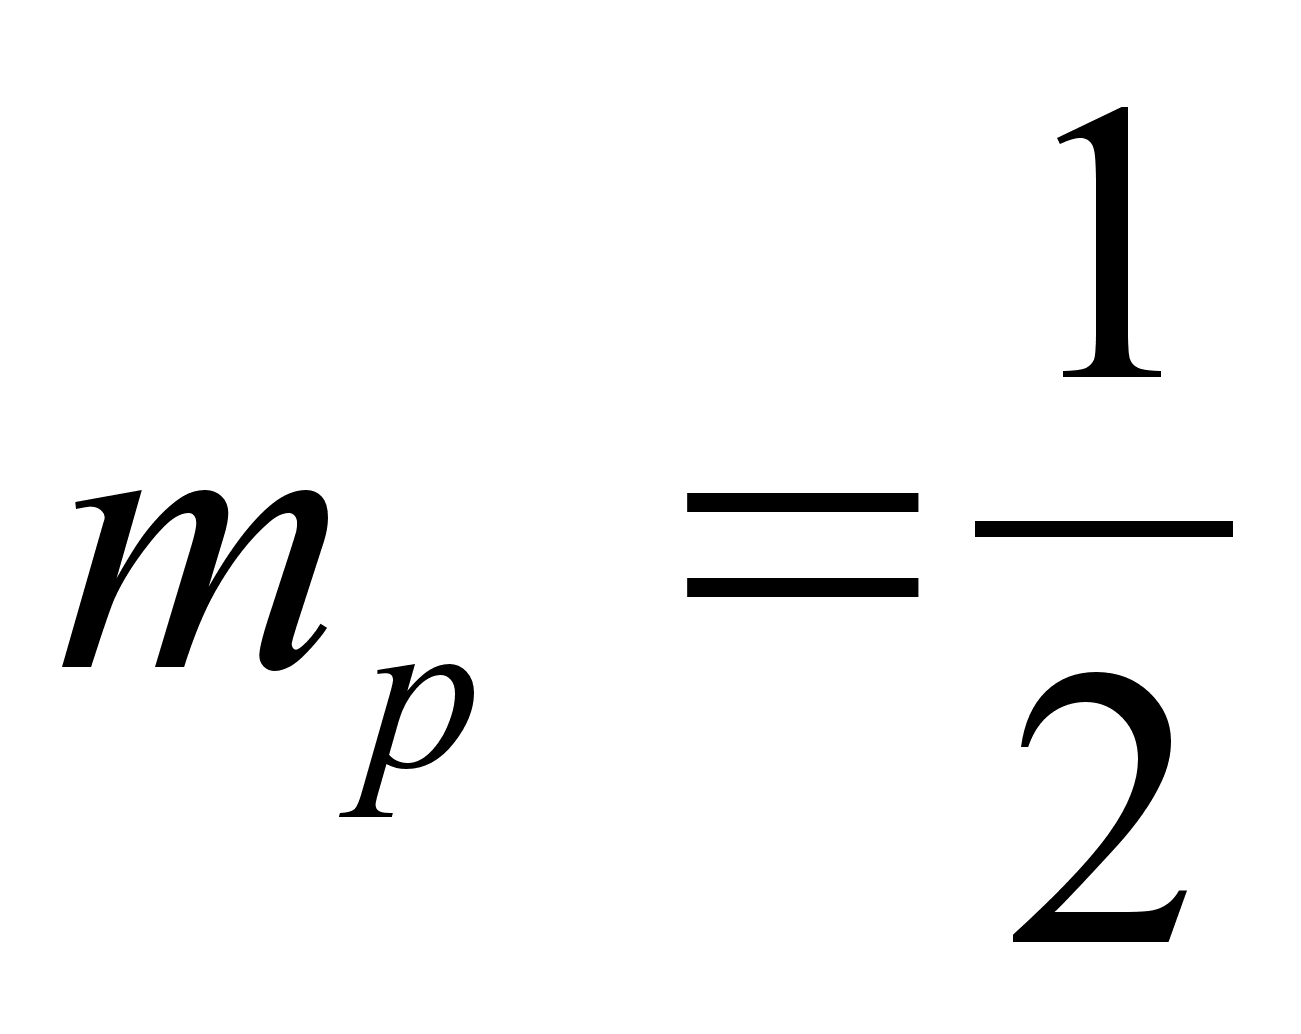 ,
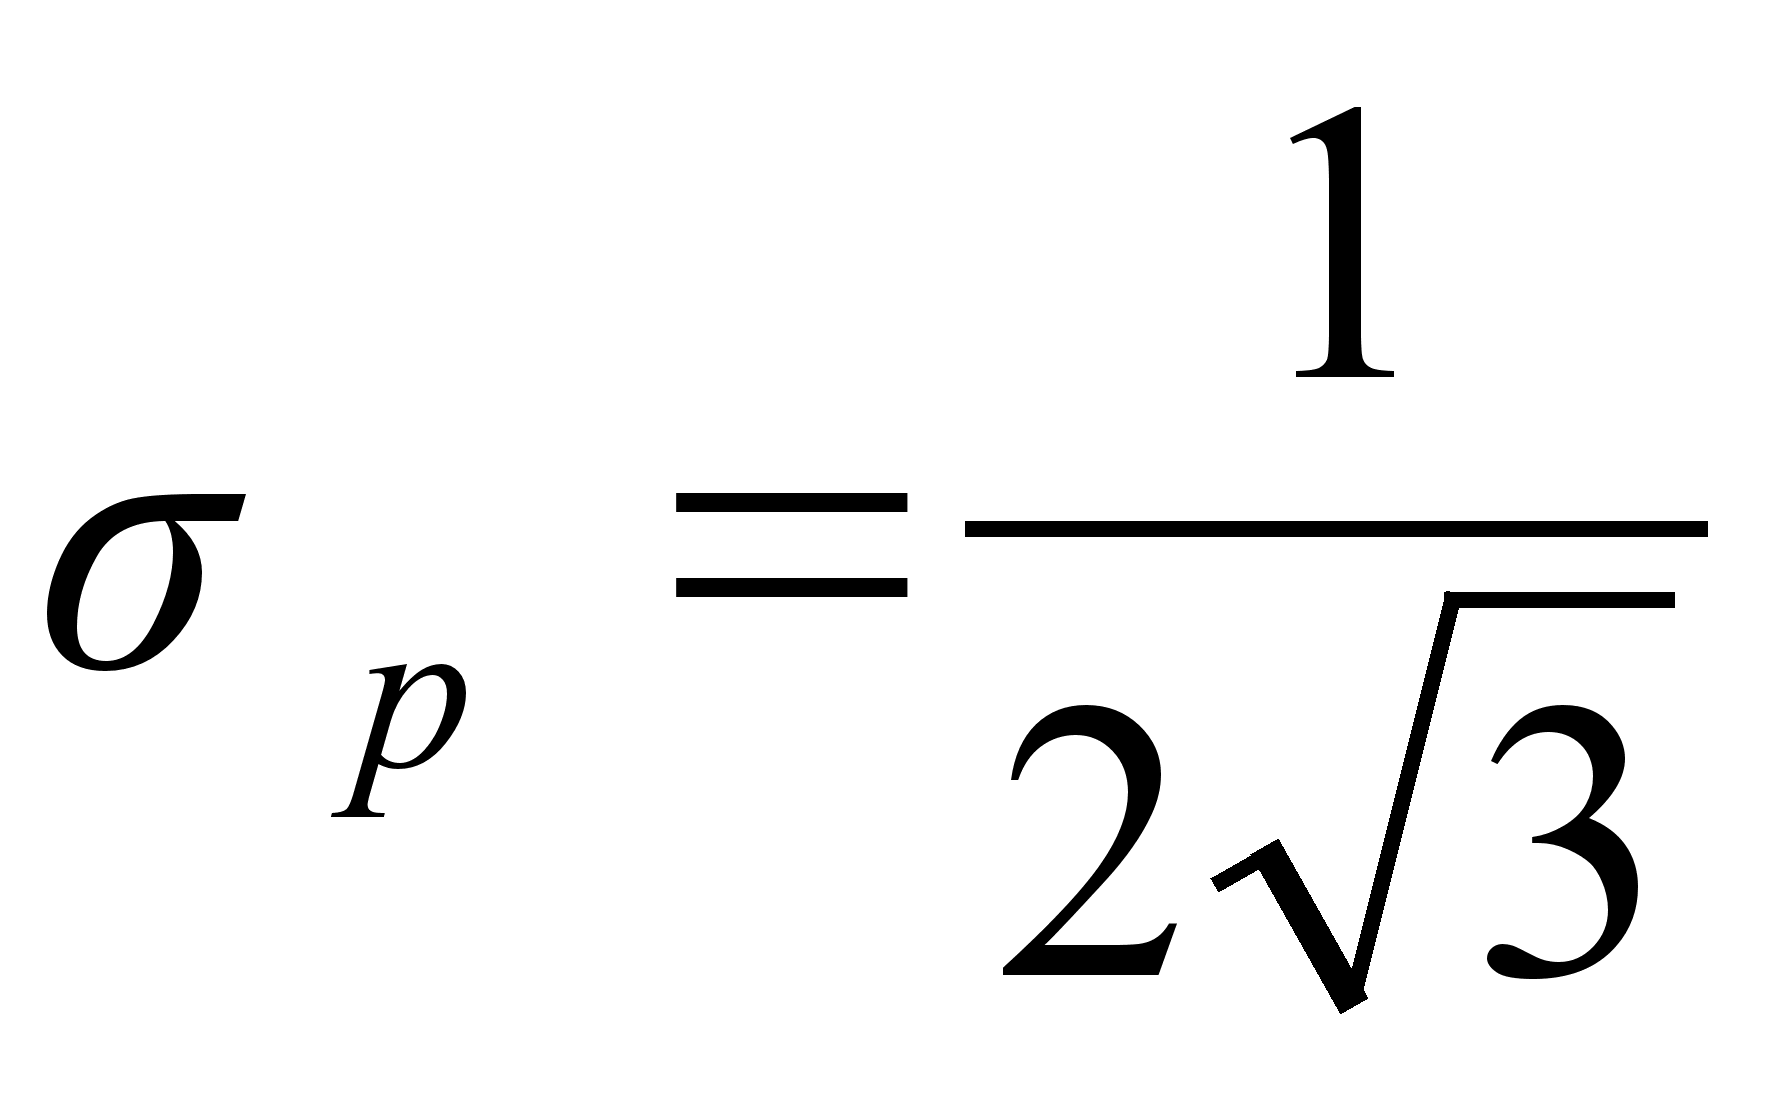
Значит
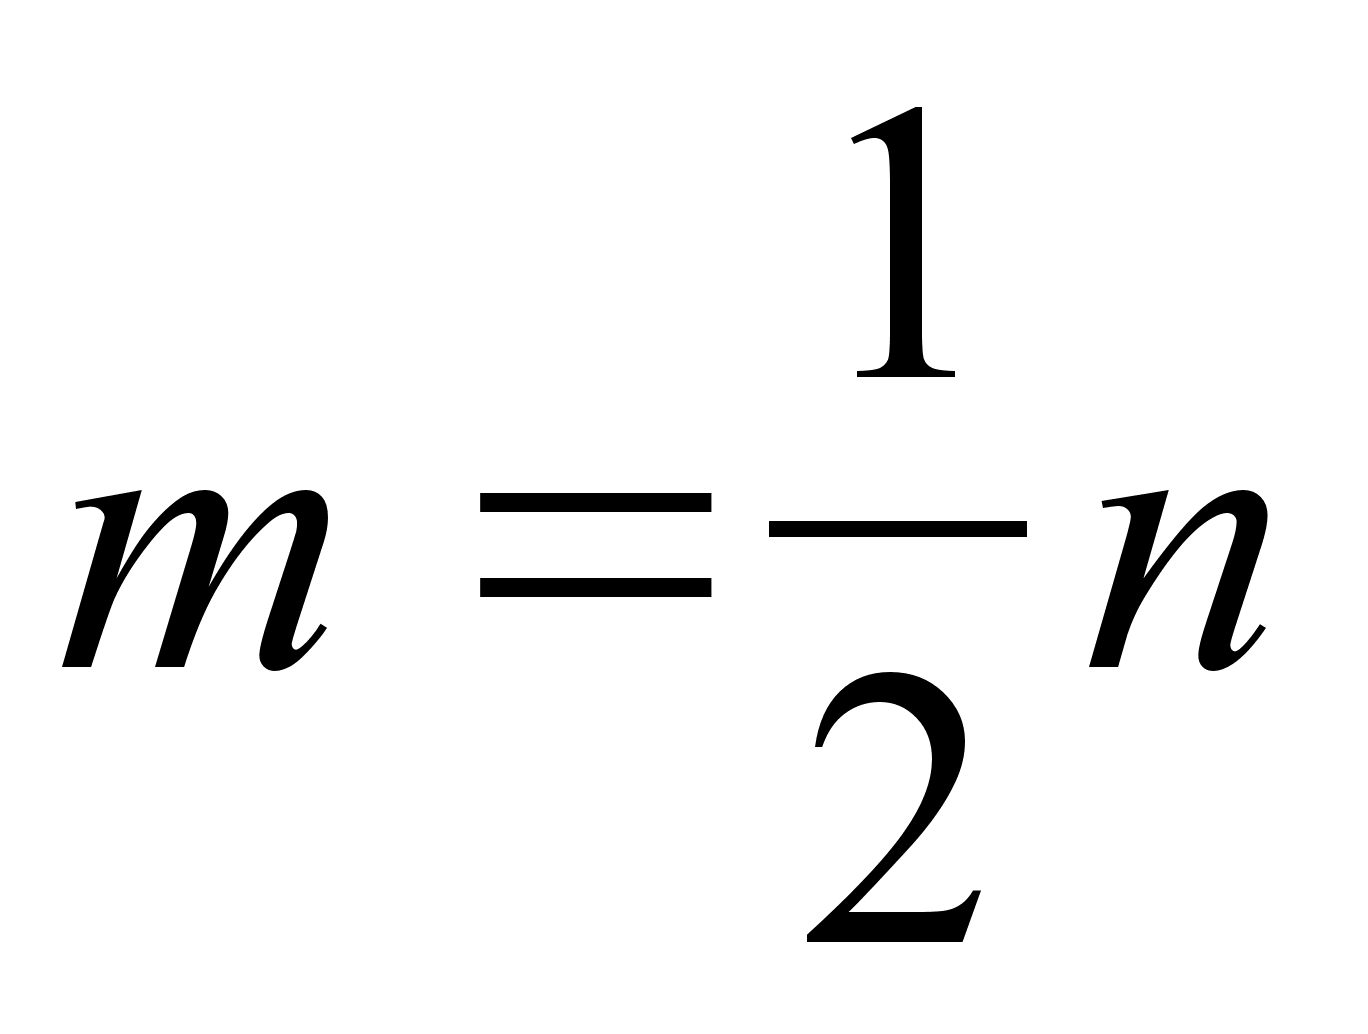 ,
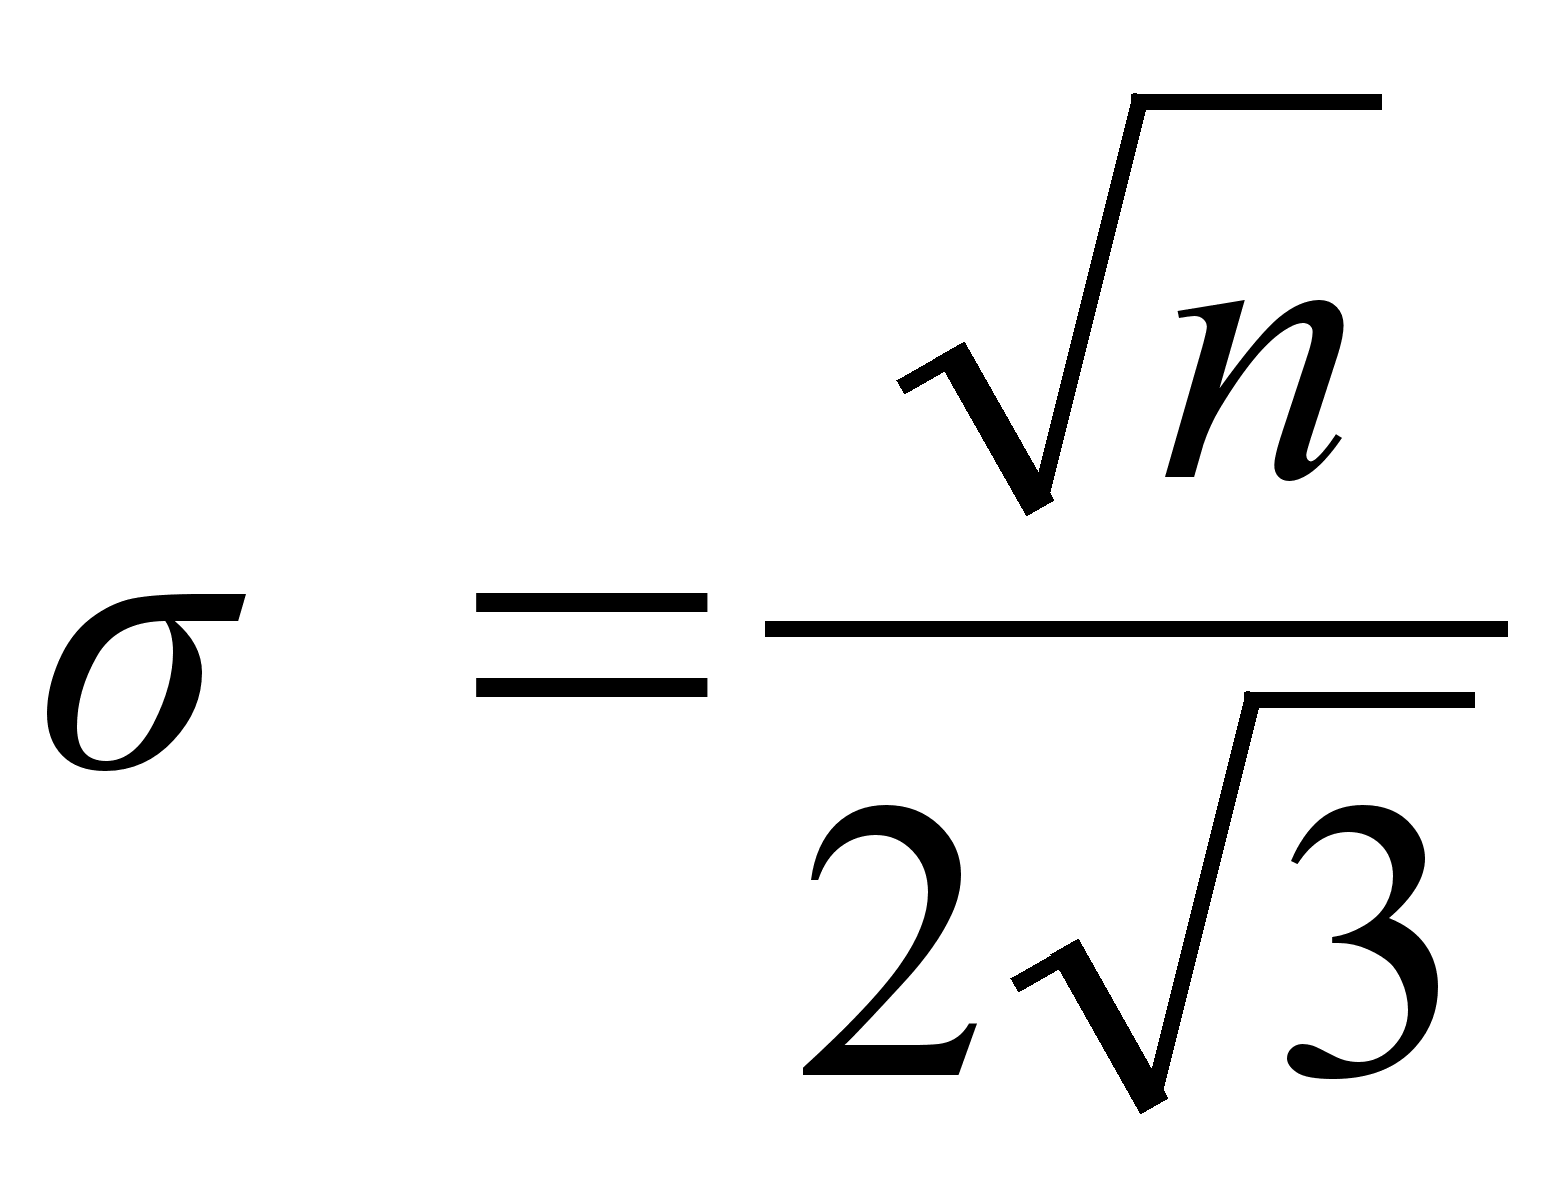
Тогда, если i-ое значение нормальной случайной величины a соответствует i-му эксперименту суммирования n равномерно распределенных чисел, то
ai = gi1 + gi2 + .....+ gin
Значит, получение нормально распределенной последовательности {Si} с математическим ожиданием mз и СКО - sз осуществимо путем нормирования и перемасштабирования последовательности {ai}, то есть, приведения ее к заданным числовым характеристикам:
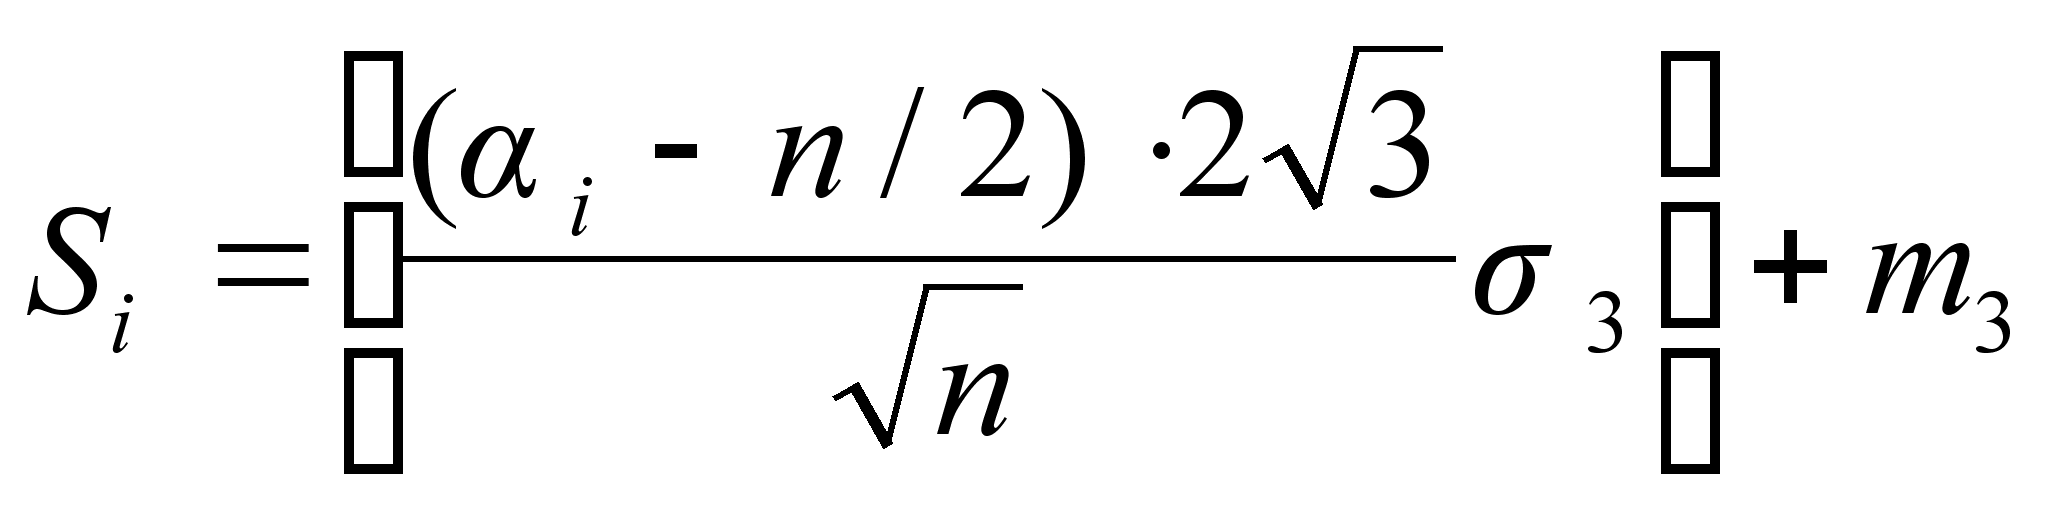
Л Е К Ц И Я 5.5
Модель системы распознавания образов
Теперь после изложения общих представлений о моделировании вообще можно перейти к построению моделей конкретных систем - систем распознавания образов. Поэтому начнем с того, что определим в первом приближении цель моделирования систем распознавания.
Цель компьютерного моделирования систем распознавания - их исследовательские испытания для оценки эффективности распознавания в приемлемые сроки и во всем факторном пространстве представления объектов (явлений, процессов) и возможностей измерителей их характеристик.
Можно было бы предположить, что такое определение касается только сложных СР, в состав которых входят многочисленные и разнородные средства измерений или на информационной основе которых строятся сами системы распознавания. Для таких систем не вызывает сомнения необходимость применения опытно-теоретического метода испытаний. Поэтому для них и должна идти речь о сроках и факторном пространстве применения СР. То есть, к компьютерному моделированию прибегают чаще всего постольку, поскольку не могут в приемлемое время провести натурные испытания СР во всем факторном пространстве поведения объектов (явлений, процессов) и измерителей их характеристик.
И далее, казалось бы, что системы распознавания, для которых натурные испытания достаточно дешевы, а способы моделирования входных воздействий достаточно сложны и неясны, не следует вообще и моделировать. Кажется, что все можно получить в эксперименте.
Если задаться целью, то можно найти настолько простые системы.
Однако в большинстве случаев кажущаяся простота и дешевизна натурных экспериментов (испытаний) при неопределенности методов построения моделей входных воздействий скрывает от испытателя характеристики факторного пространства состояния и поведения объектов распознавания. При этом не удается определить фактическую эффективность, а оцененное значение ее только успокаивает (“ведь оценка получена!”), так как, к сожалению, характеризует только какую-то неопределенную часть факторного пространства, о которой могут быть лишь качественные суждения, а чаще всего и ошибочные.
Поэтому независимо ни от чего попытка разработки изоморфной модели уже ведет к получению дополнительной информации для создания более эффективных систем или для четкого определения области применения созданной системы распознавания.
Отказ от этого подхода приводит к тому, что легко реализуемые экспериментальные применения системы часто не позволяют объяснить причины неожиданно появляющихся отрицательных результатов. И только более полный анализ поведения объектов (явлений, процессов) распознавания, измерителей их характеристик и сопутствующих искажений (что входит в задачи создания соответствующих моделей) выводит из тупиковой ситуации, если, конечно, она расценена как тупиковая.
Решение задач построения компьютерных моделей систем распознавания образов основывается на
-понимании принципов классификации и структуры систем распознавания;
-способов описания классов на языке словаря признаков;
-подходов к формализации показателей эффективности распознавания.
Начиная с декомпозиции, как одного из важнейших принципов построения моделей, можно заметить, что блочный состав моделей систем распознавания грубо уже определяют их схемы, рассмотренные при изучении принципов классификации. Поэтому модель СР первого приближения должна включать следующие основные элементы:
-распознаваемый объект (явление, процесс);
-технические средства (средства измерений);
-многоуровневая (в общем случае) система обработки измерений;
-алгоритм классификации.
Ну, а так как моделирование систем распознавания, как это было сформулировано выше, преследует целью проведение испытаний и получение оценки выполнения ими задач - эффективности -, то последним венчающим модель элементом в перечисленный состав должен быть включен блок оценки этого показателя (эффективности).
Рассмотрим более подробно все перечисленные элементы модели, стремясь к их детализации и определению принципов компьютерной реализации во взаимодействии друг с другом.
5.5.1. Моделирование распознаваемого объекта
Сложность модели распознаваемого объекта (явления, процесса) определяется полностью степенью физико-химической сложности его самого, условий его наблюдения и степенью доступности необходимых измерений.
Исходя из определения назначения системы распознавания ,- получение информации, необходимой для принятия решения о принадлежности неизвестного объекта (явления, процесса) к тому или иному классу ,- ничего другого не остается, как получить по возможности всю информацию, имеющую отношение к его распознаванию. Незнание или плохое знание описания объекта во всем диапазоне интересующих сторон, свойств, характеристик, факторов поведения не дает оснований надеяться на эффективность получаемых решений.
Заметим, что соответствующая задача (получение всей информации) не противоречит самой первой задаче, с которой начинается создание СР, - определение полного перечня признаков распознавания.
Говоря слова “модель объекта” (а равно “модель явления”, “модель процесса”) условимся, что при этом будем иметь в виду “модель объектов распознавания”, которые могут относиться к различным классам. Но так как в системе в каждом акте ее применения всегда имеют дело с одним неизвестным объектом, подлежащим распознаванию, а также имея в виду, что принципы моделирования всех объектов данной СР одинаковы (различны лишь характеристики), чаще всего используется термин “модель объекта распознавания”.
Исходя из этого определим модель объекта как цифровой имитатор совокупности его свойств, характеристик и состояний. Заметим, что, на первый взгляд, число моделируемых (имитируемых) свойств, характеристик и состояний объекта равно размерности словаря признаков распознавания. Так действительно, если в СР используется один простой признак распознавания, то и моделью соответствующего объекта должно имитироваться поведение этой одной характеристики, одного свойства, одного состояния объекта. Точно также, если СР использует несколько простых признаков, то имитатор объекта должен обеспечивать получение такого же количества характеристик (свойств, состояний) каждого моделируемого объекта. Однако если признак распознавания один, но комбинированный, то цифровой имитатор соответствующего объекта должен выдавать системе столько и таких его характеристик (свойств, состояний), сколько и каких используется для расчета этого комбинированного признака во многоуровневой системе. То есть, размерность вектора имитируемых свойств может быть больше или равна размерности вектора признаков распознавания.
Примеры.
1)Пусть в СР в качестве признака распознавания используется один - масса объекта. Значит моделью каждого из объектов, подлежащих распознаванию, будет в простейшем случае запись в банке данных каждого из них всего одного соответствующего числа в принятой размерности (тонна, килограмм, грамм и т.п.).
2)Пусть в качестве признаков распознавания в СР используются геометрические размеры объекта. Тогда модель каждого объекта, подлежащего распознаванию, будет представлять в простейшем случае три числа в соответствующем банке данных - длина, ширина, высота (м, дм, см, мм).
3)Пусть в СР метеоосадков в качестве признака дождей (а дожди бывают разными хотя бы по интенсивности) используется количество воды, попадающей на определенную поверхность земли. Тогда моделью любого класса дождей может быть всего одно число - количество мм осадков в час (месяц, год).
4)Пусть в СР распознаются звуки по высоте их тона. Тогда моделью каждого звука будет число, характеризующее частоту основного тона его и имеющее размерность - Гц.
5)Пусть в СР распознаются звуки по ряду признаков:
-высота основного тона;
-наличие низкочастотной модуляции основного тона;
-изменение интенсивности.
Тогда модель такого в данном случае сложного явления должна содержать по каждому классу, подлежащему распознаванию, по крайней мере, такие параметры как частота основного тона;
-частота модуляции;
-изменение амплитуды основного тона во времени (вид модуляции).
Чем сложнее свойства объекта, отражаемые в составе вектора признаков распознавания, тем сложнее модель этого объекта. Так, если для распознавания требуется знание геометрических характеристик объекта более полно, чем для определения длины, ширины и высоты, то такой объект должен уже представляться чертежами его в трех проекциях. Соответствующая модель - внешние контуры указанных проекций, представляемые
-либо в виде набора дискретных точек координат;
-либо в виде набора параметров сплайнов, аппроксимирующих указанные контуры;
-либо в виде радиально-круговых разверток указанных контуров, то есть , величин радиус-векторов, имеющих начало в некотором центре чертежа проекции и конец на границе контура.
Так или иначе мы имеем и здесь и в рассмотренных простейших случаях наборы числовых характеристик распознаваемых объектов, которые для каждого из объектов и представляются как его модель.
Утверждая, что чем больше размерность вектора признаков, тем сложнее модель объекта, мы как бы все и усложняем сами вполне сознательно. Действительно формирование словаря признаков, а значит размерности соответствующего вектора, - эвристическая операция. Причем эта