Построение систем распознавания образов
-P(Wi) - априорная вероятность того, что объект, случайно выбранный из общей совокупности, окажется принадлежащим к классу Wi.
Как получить ПРВ классов системы распознавания? В распоряжении разработчика СР - три способа:
-экспериментальное определение по статистическим данным;
-теоретический вывод;
-моделирование.
То же касается априорной вероятности класса P(Wi).
Если признаки распознавания - структурные, то описанием каж-дого класса должен быть набор предложений (цепочек из непроизводных элементов с правилами соединения). Каждое из предложений класса - характеристика структурных особенностей объектов этого класса. Пример - код Фримена.
ЗАДАЧА № 5
Выбор алгоритма классификации, обеспечивающего отнесение распознаваемого объекта или явления к соответствующему классу.
Непосредственное решение задачи распознавания на основе использования словаря признаков и алфавита классов объектов или явлений фактически заключается в разбиении пространства значений признаков распознавания на области D1,D2,...,Dn, соответствующие классам W1,W2,...,Wn (вспоминаем определение “образа”).
Указанное разбиение должно быть выполнено таким образом, чтобы обеспечивались минимальные значения ошибок отнесения классифицируемых объектов или явлений к “чужим” классам.
Результатом такой операции является отнесение объекта, имеющего набор признаков X1,X2,....,Xn (точка в n-мерном пространстве), к классу Wi, если указанная точка лежит в соответствующей классу области признаков - Di.
Разбиение пространства признаков можно представлять как построение разделяющих функций fi(x1,x2,....,xn) между множествами (областями) признаков Di, принадлежащим разным классам.
Упомянутые функции должны обладать следующим свойством:
-если
объект, имеющий
вектор признаков
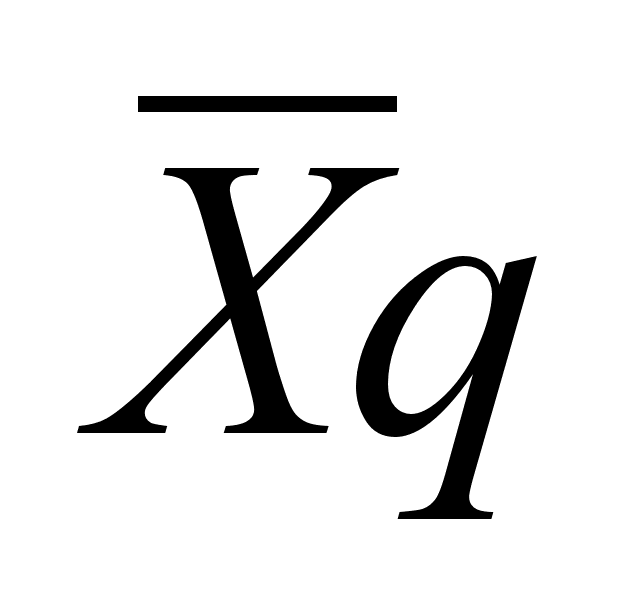 фактически
относится
к классу
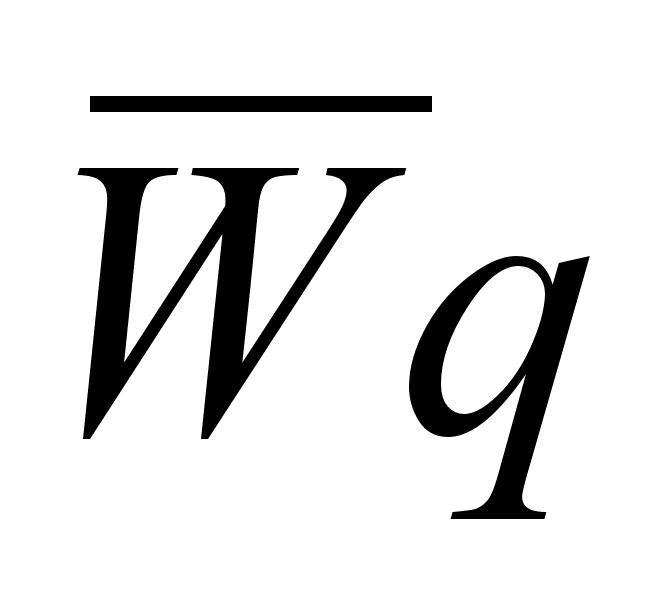 ,
то значение
разделяющей
функции
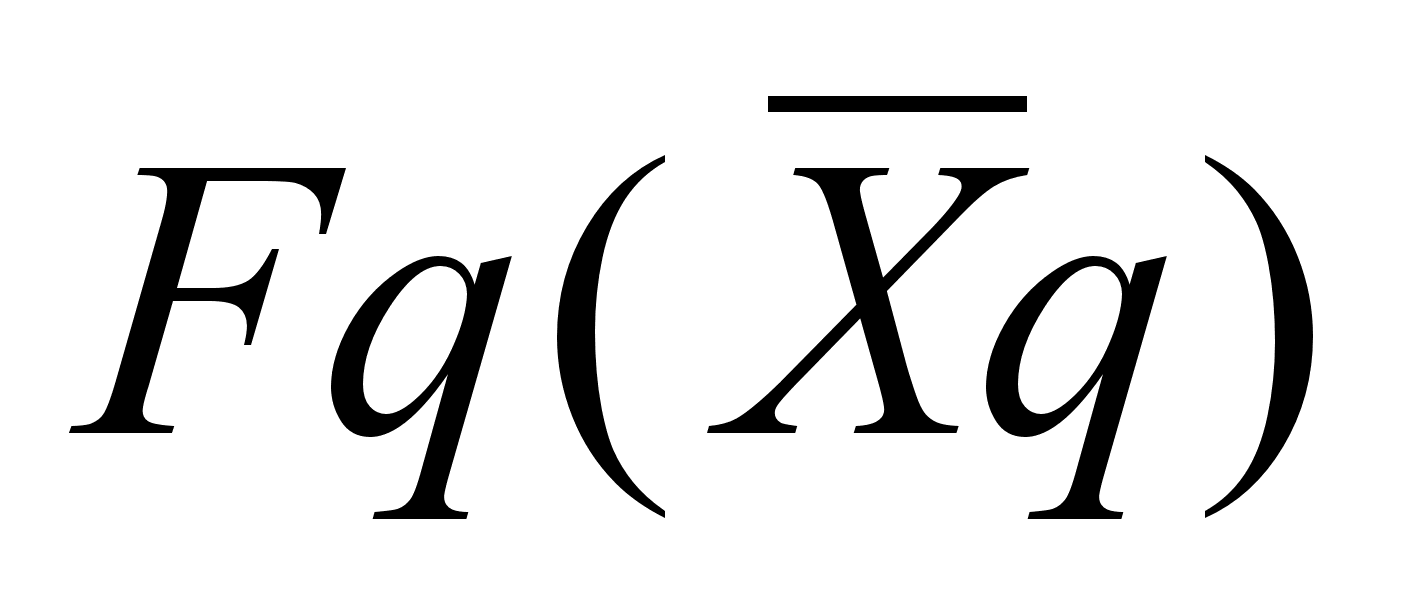
должно
быть большим,
чем значение
ее для класса
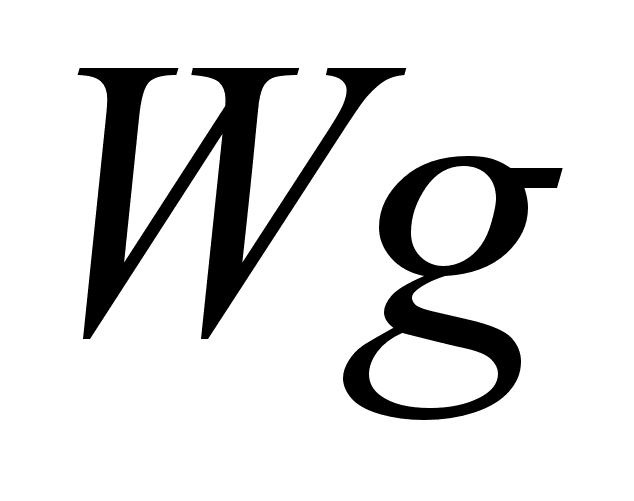 -
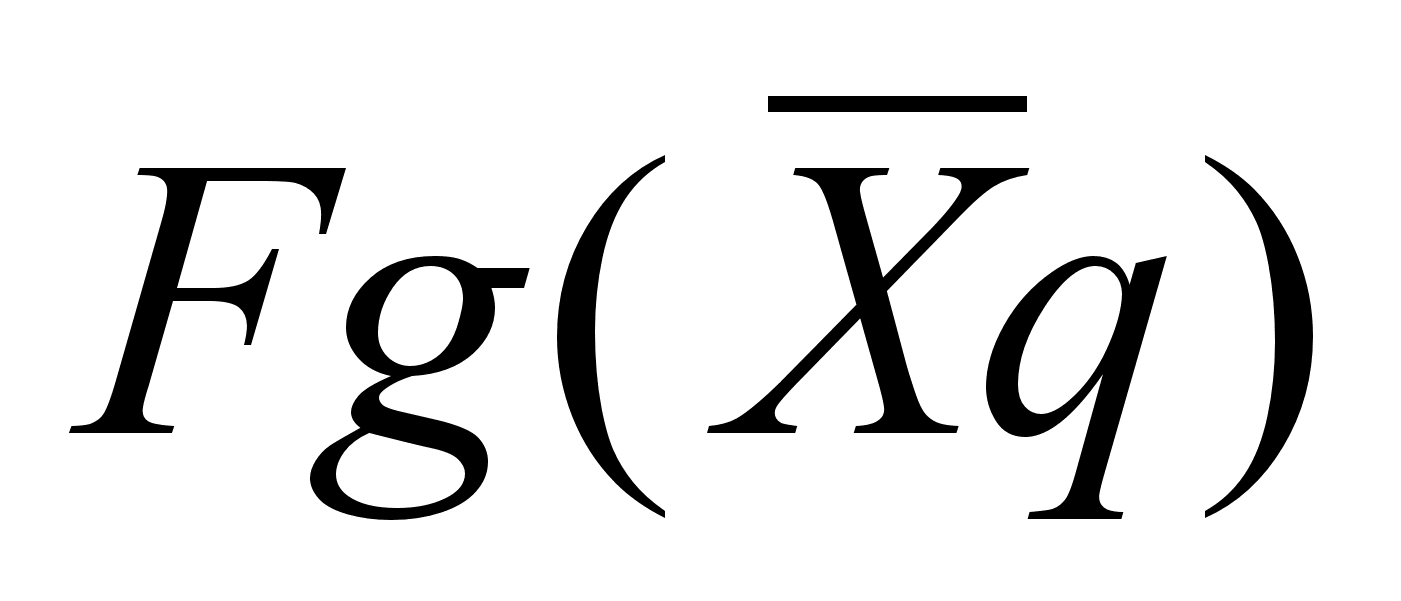 (здесь индекс
q - означает
номер класса,
к которому
принадлежит
вектор признаков).
Отсюда легко определить выражение решающей границы между областями Di, соответствующим классам Wi:
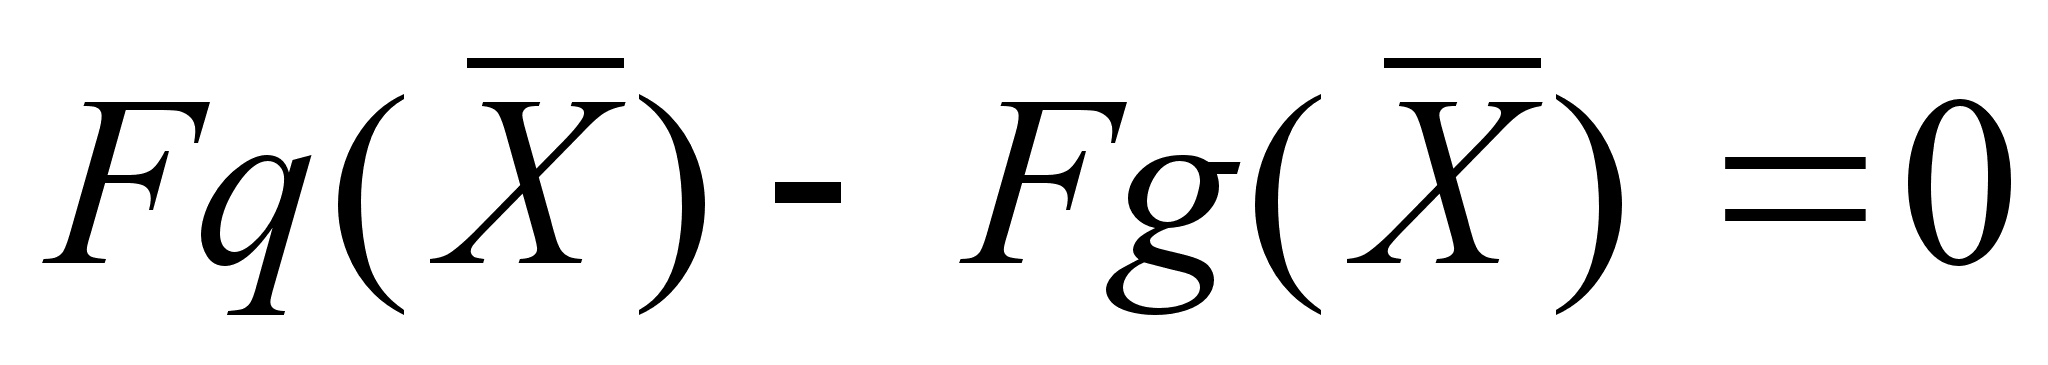
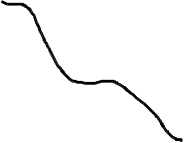
Для двух распознаваемых классов разбиение двумерного пространства выглядит так (рис 2.2). Физически распознавание основывается на сравнении значений той или иной меры близости распознаваемого объекта с каждым классом. При этом если значение выбранной меры близости (сходства) L данного объекта w с каким-либо классом Wg достигает экстремума относительно значений ее по другим классам, то есть
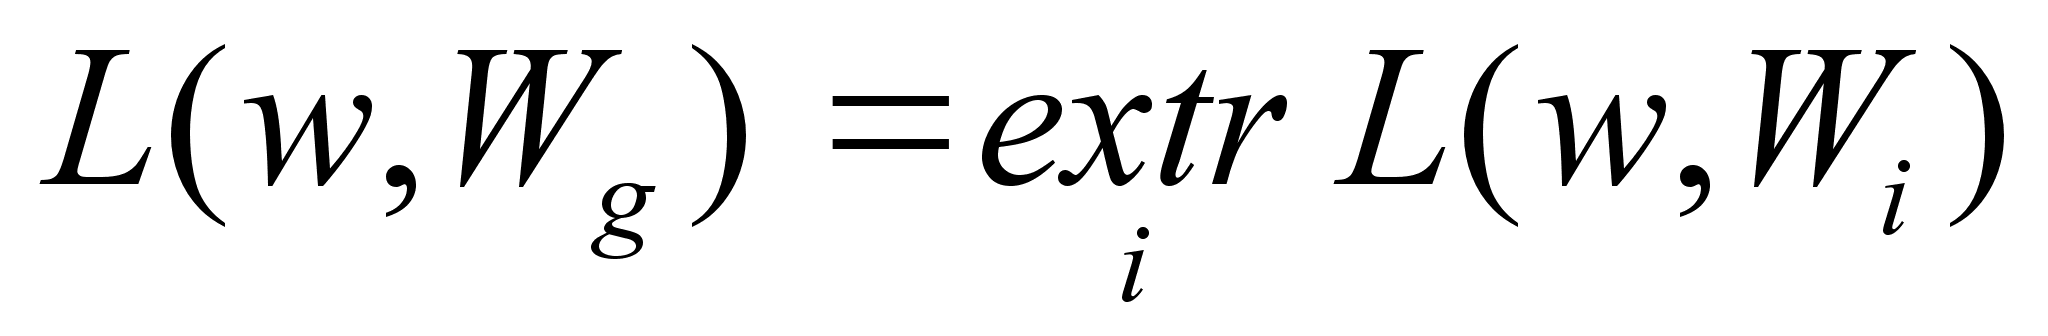
то
принимается
решение о
принадлежности
этого объекта
классу Wg,
то есть w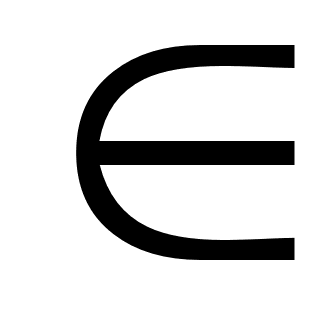 Wg.
Надеюсь понятно, что если мера близости не имеет экстремума, то мы находимся на границе, где не можем отдать предпочтение ни одному из классов.
 X1
o o o o
xx x o o o
x o o F2(X1,X2) > F1(X1,X2)
x x x o o o o
x o o o o o
x x x x x o o o o o
F1(X1,X2)>F2(X1,X2) x o
x x x x x x x o o
x x x x x x
x x x x x
 X2
Рис.2.2
В алгоритмах распознавания, использующих детерминированные признаки в качестве меры близости, используется среднеквадратическое расстояние между данным объектом w и совокупностью объектов (w1,w2,....,wn), представляющих (описывающих) каждый класс. Так для сравнения с классом Wg это выглядит так
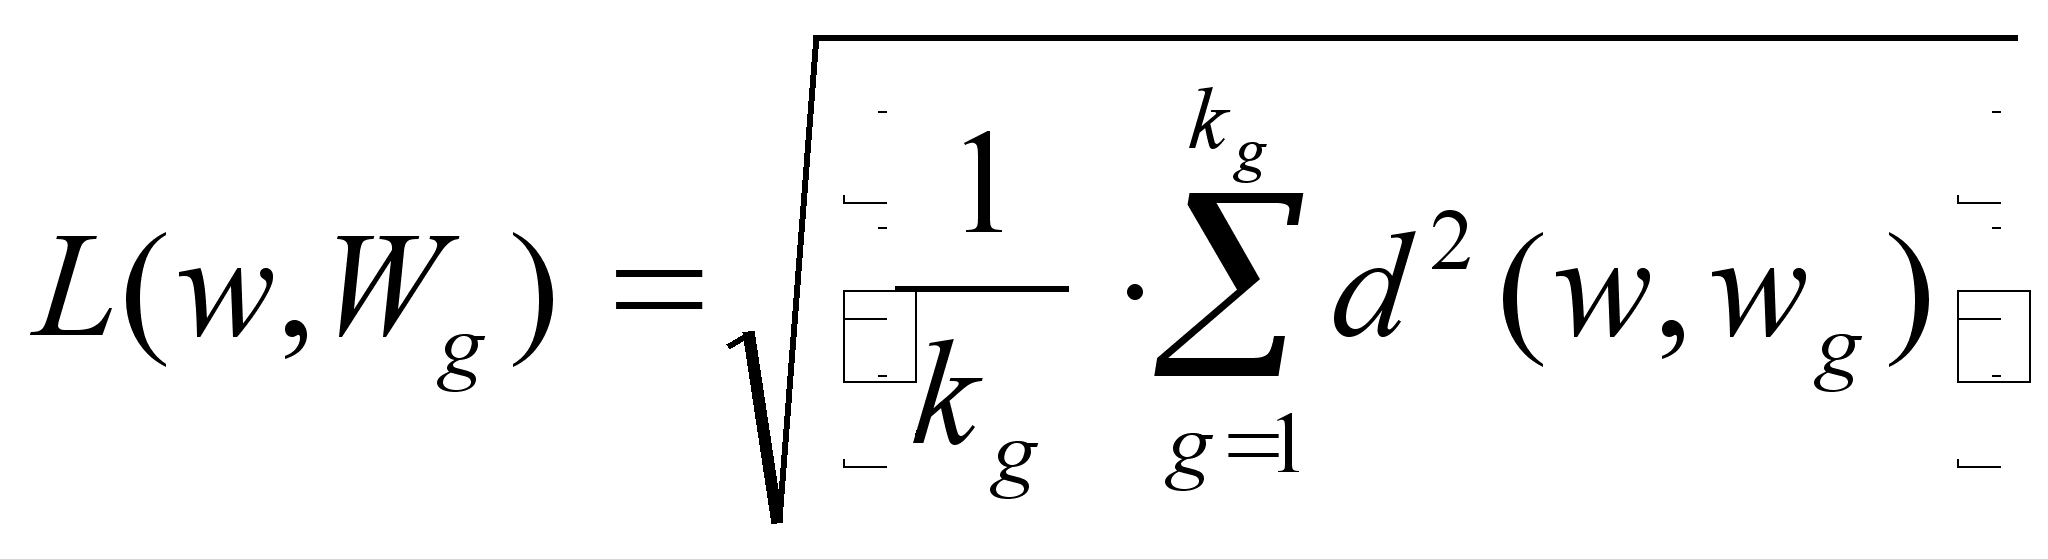
где kg - количество объектов, представляющих Wg-й класс.
При этом в качестве методов измерений расстояния между объектами d(w,wg) могут использоваться любые методы (творческий процесс здесь не ограничивается).
Так, если сравнивать непосредственно координаты (признаки), то
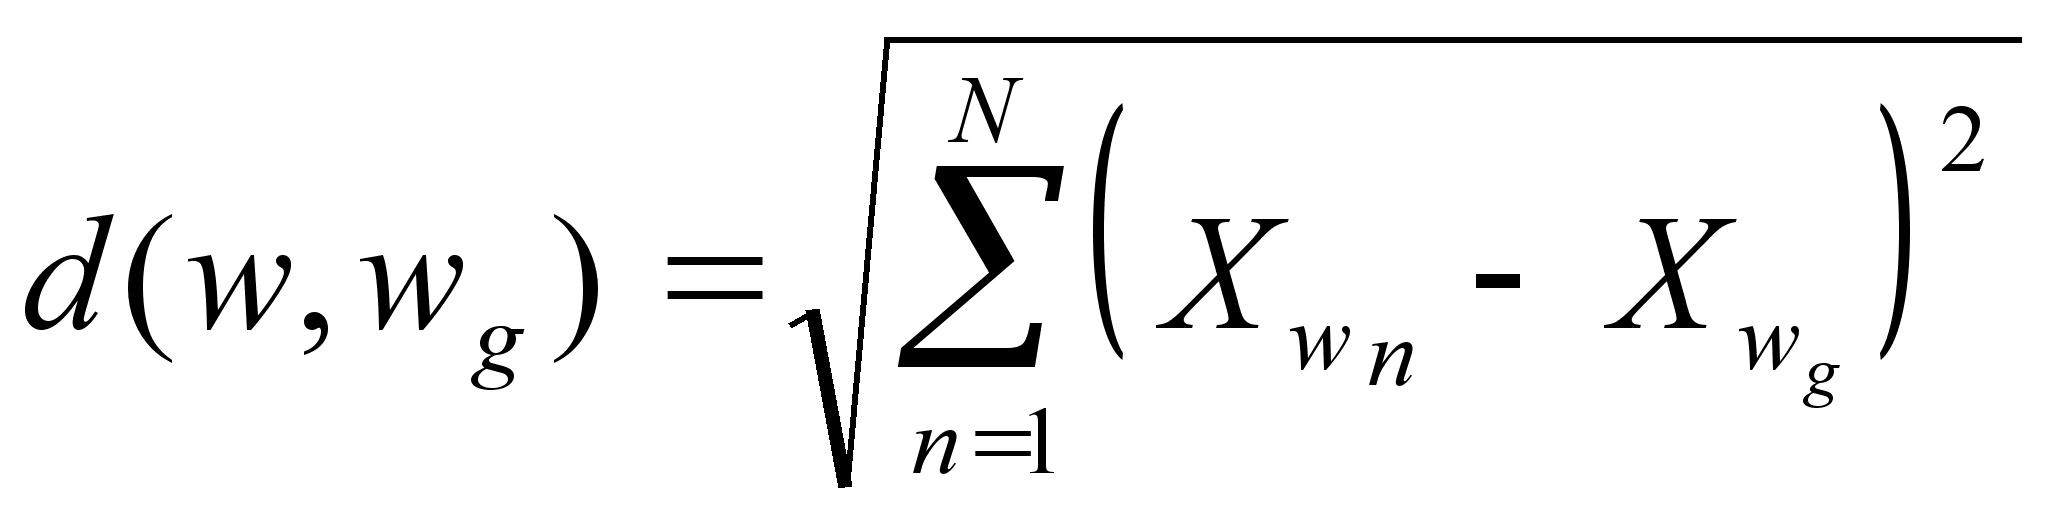
где N - размерность признакового пространства.
Если сравнивать угловые отклонения, то рассматривая вектора, составляющими которых являются признаки распознаваемого объекта w и класса wg, будем иметь:
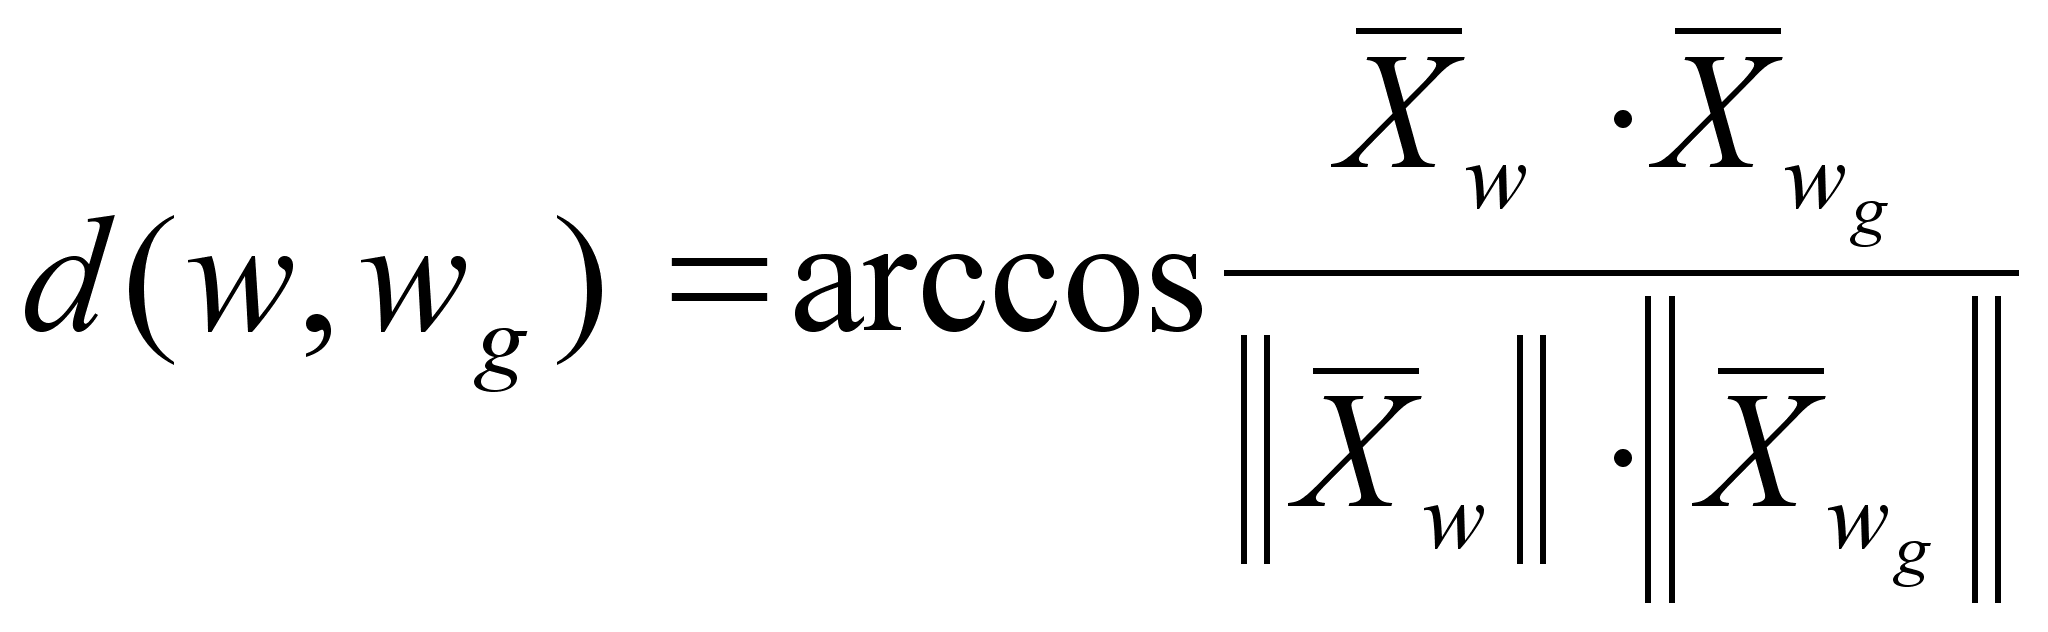
где ||Xw|| и ||Xwg|| - нормы соответствующих векторов.
В алгоритме распознавания, использующем детерминированные признаки можно учитывать и их веса Vj (устанавливать степень доверия или важности). Тогда рассмотренное среднеквадратическое расстояние принимает следующий вид:
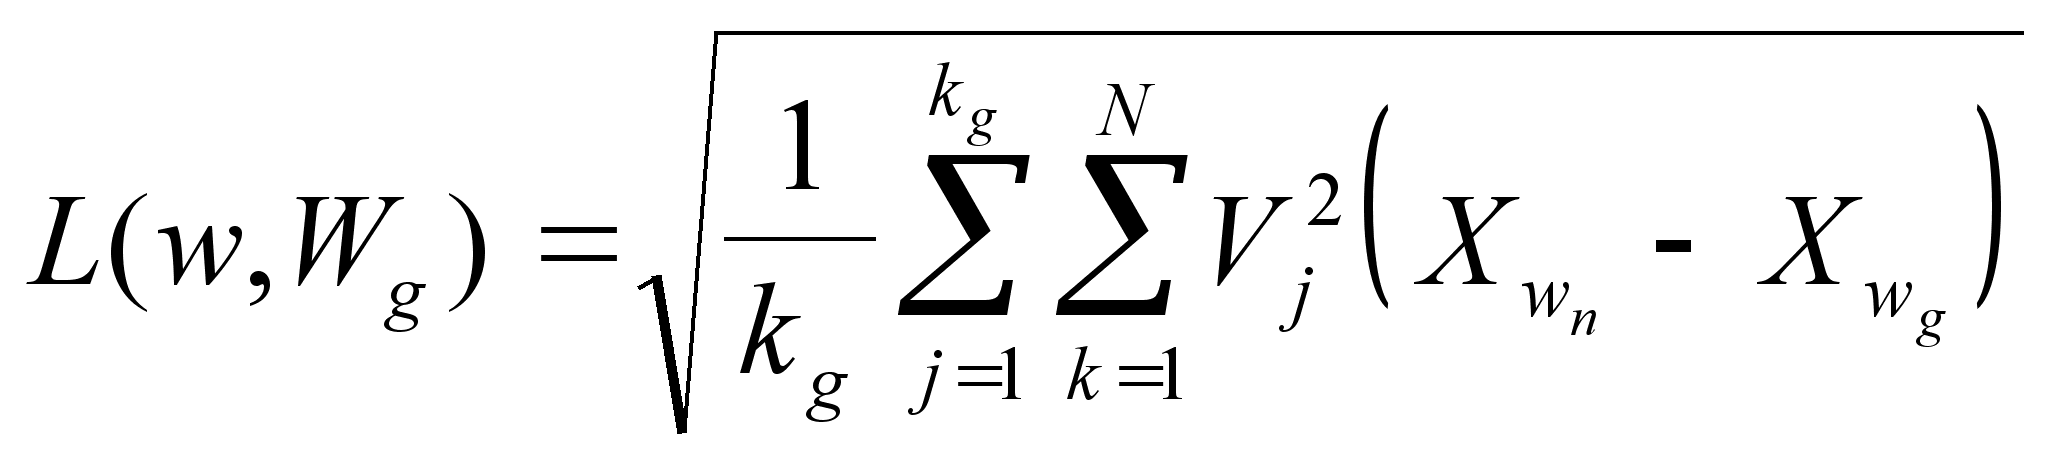
В алгоритмах распознавания, использующих вероятностные признаки, в качестве меры близости используется риск, связанный с решением о принадлежности объекта к классу Wi, где i - номер класса. (i=1,2,..,m.).
Описания классов, как мы недавно рассмотрели
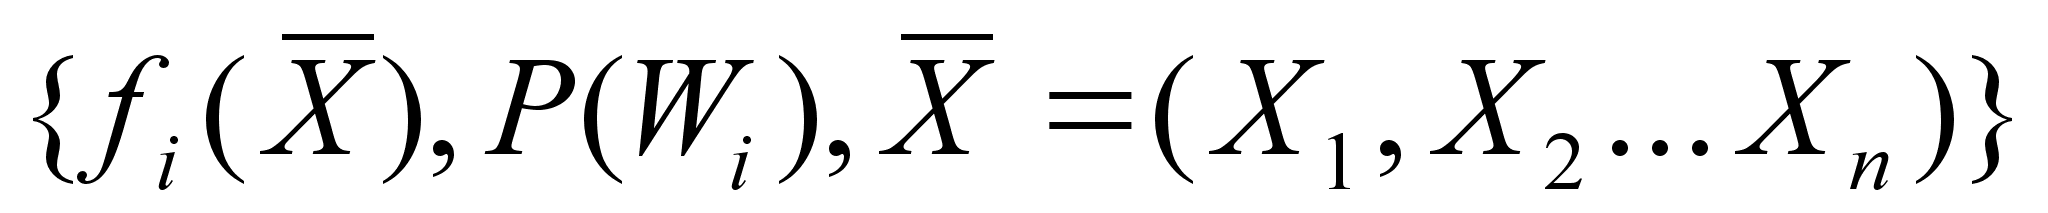
В рассматриваемом случае к исходным данным для расчета меры близости относится платежная матрица вида:
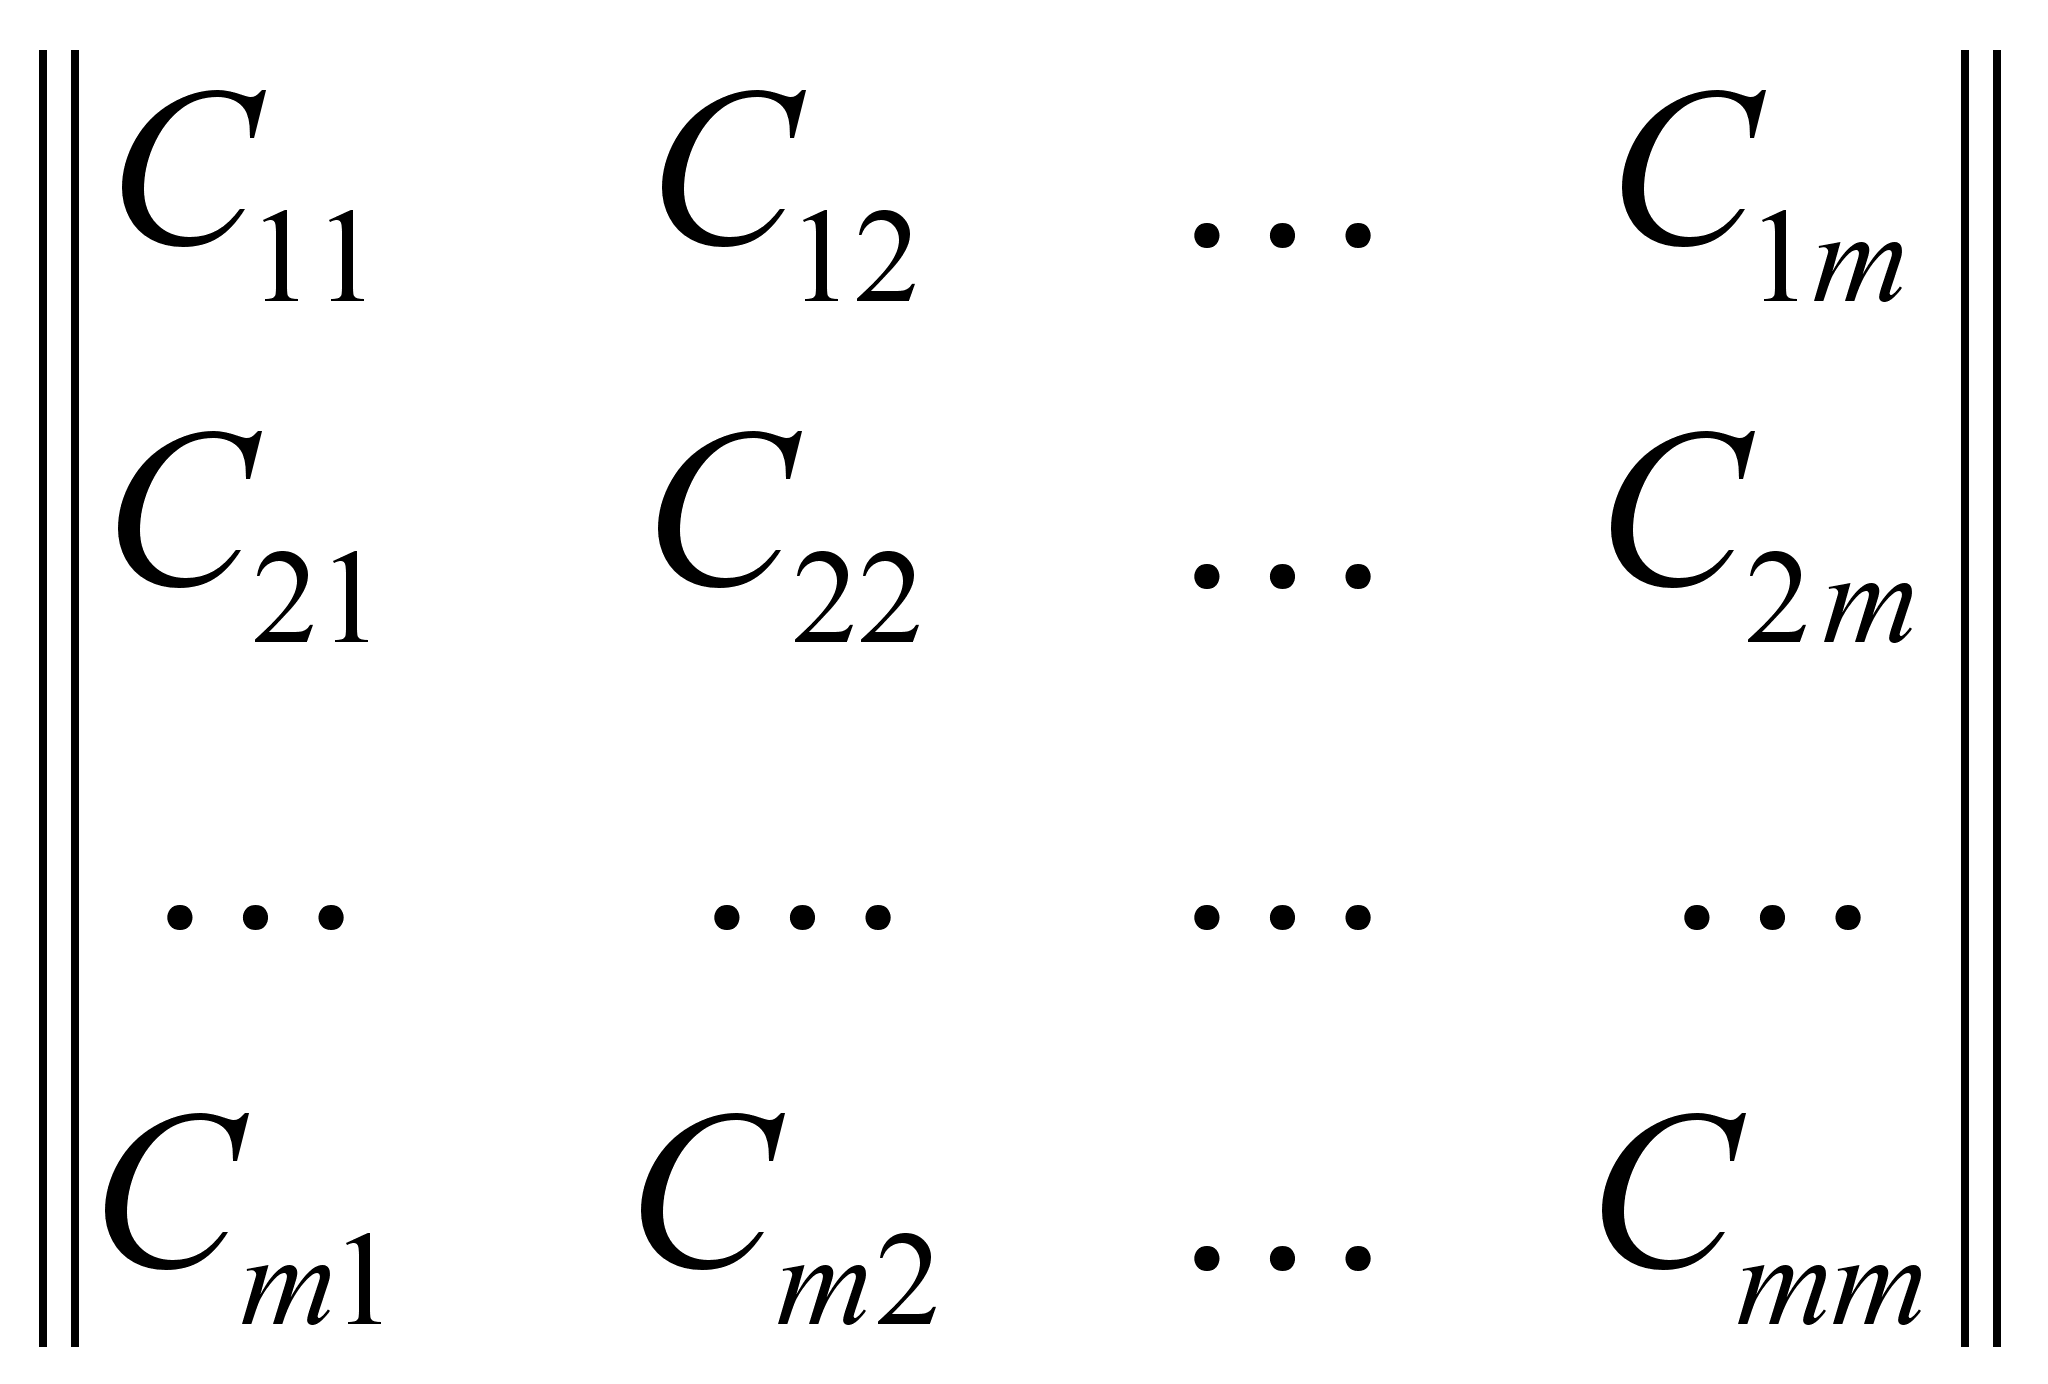
Здесь на главной диагонали - потери при правильных решениях. Обычно принимают Сii=0 или Cii<0.
По обеим сторонам от главной диагонали - потери при ошибочных решениях. В каждой системе эти потери свои, свойственные только ей. Однако назначение их - творчество разработчика системы распознавания.
Если вектор
признаков
распознаваемого
объекта w -
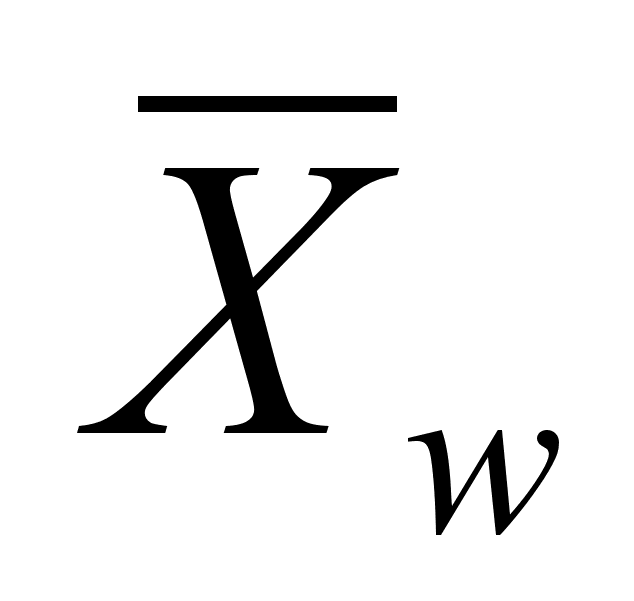 ,
то
риск, связанный
с принятием
решения о
принадлежности
этого объекта
к классу Wg,
когда на самом
деле он может
принадлежать
классам W1,W2,...,Wm,
наиболее
целесообразно
определять как
среднее значение
потерь
С1g, C2g,...,Cmg ,
то есть, потерь, стоящих в g-ом столбце платежной матрицы.
Тогда этот средний риск можно записать как определение МОЖ
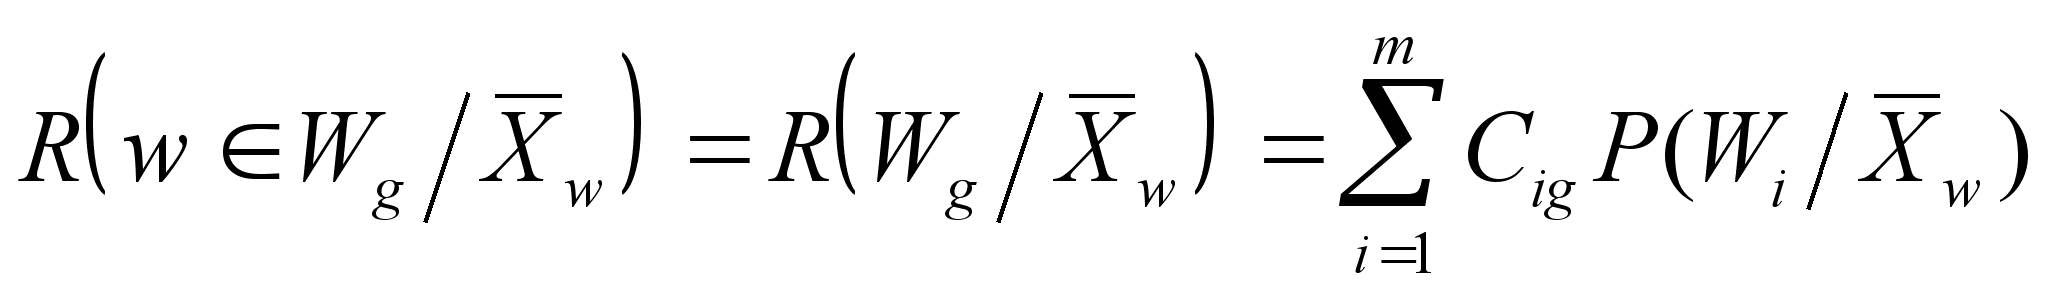
Здесь
P(Wi/Xw) -
апостериорная
вероятность
того, что wWi.
Для исходных данных, а именно описаний классов эта вероятность легко может быть определена в соответствии с теоремой гипотез или по формуле Байеса
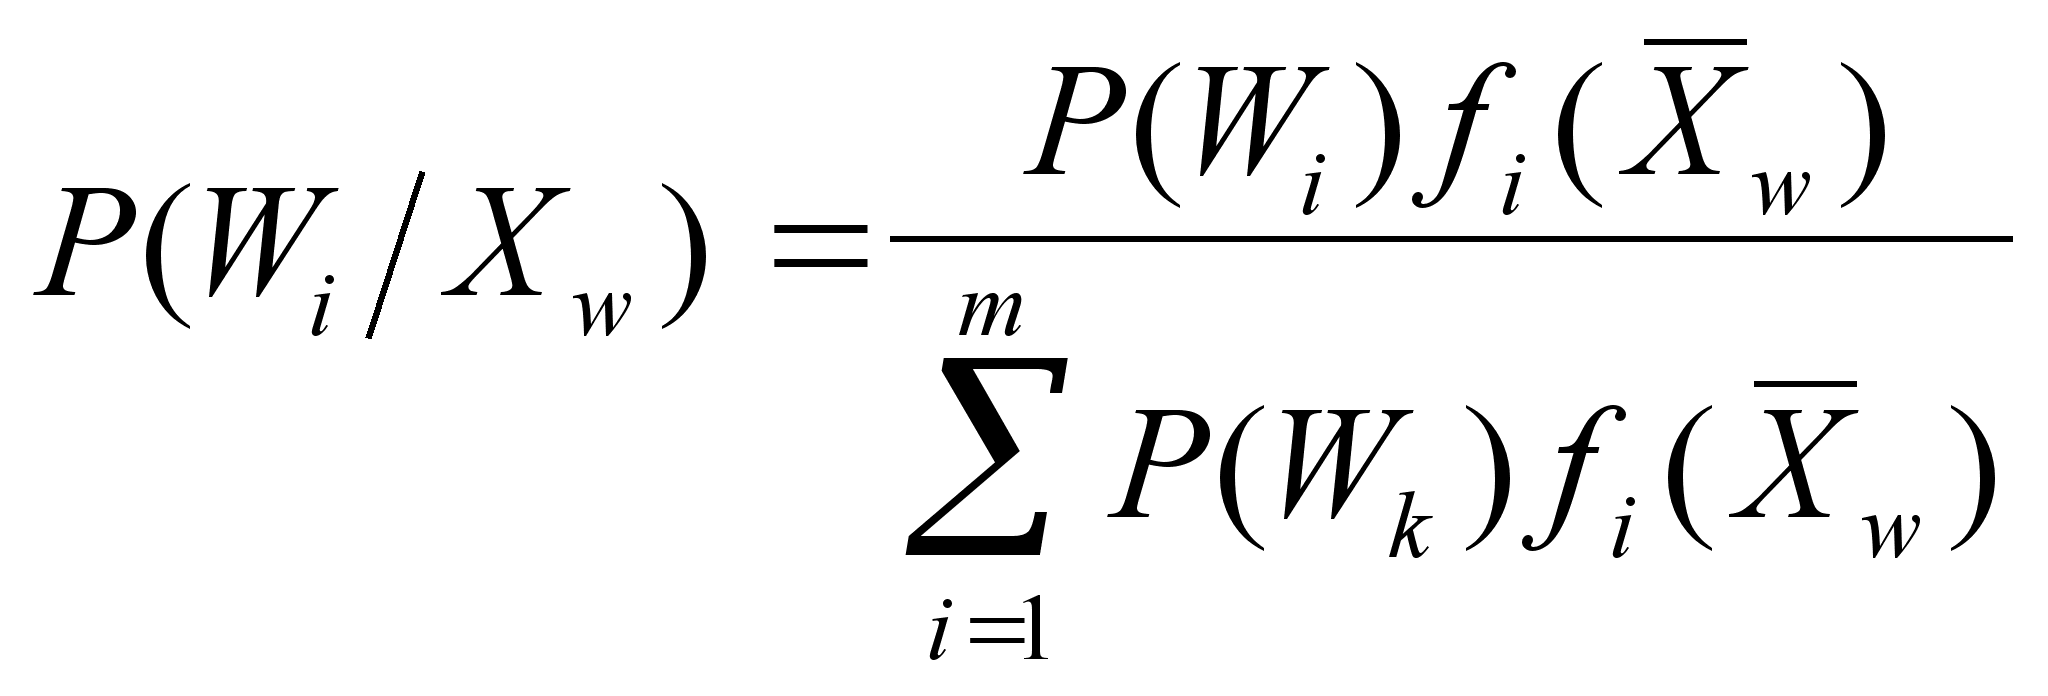
Вероятности и плотности, входящие в формулу - ни что иное как характеристики описания классов в вероятностной системе.
Для алгоритмов, основанных на логических признаках, понятие “мера близости” не имеет смысла. Вспомним упрощенный пример, рассмотренный нами для логических признаков заболеваний (простой простуды и ангины).
Имея значения признаков А,B,C, достаточно подставить их в булевы соотношения между классами и признаками, чтобы сразу получить результат как истинность или ложность булевой функции описания того или иного класса.
Действительно, пусть признаки приняли следующие значения:
-Повышенная температура: A=1
-Насморк: B=0
-Нарывы в горле: C=1
Тогда подстановка их в булевы соотношения даст следующий результат:
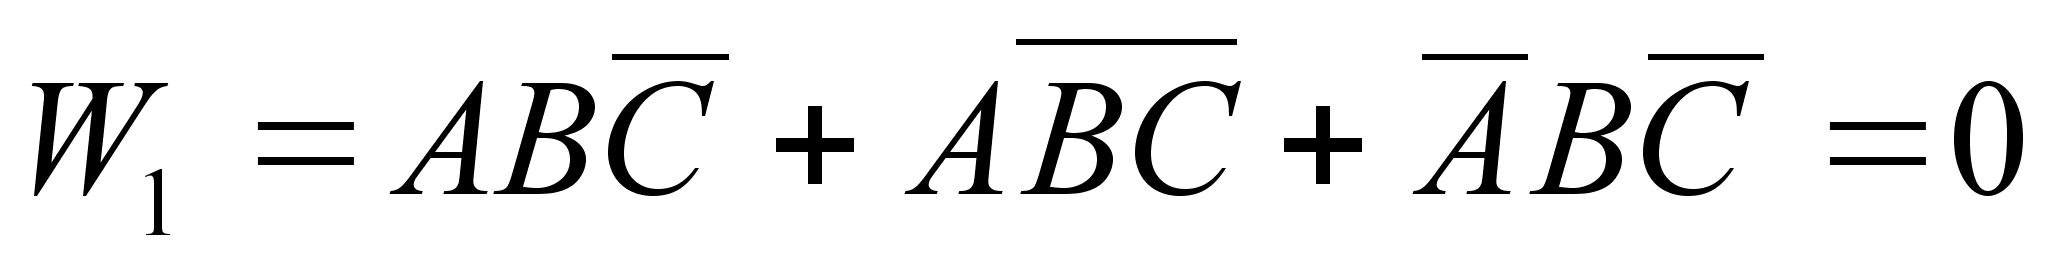
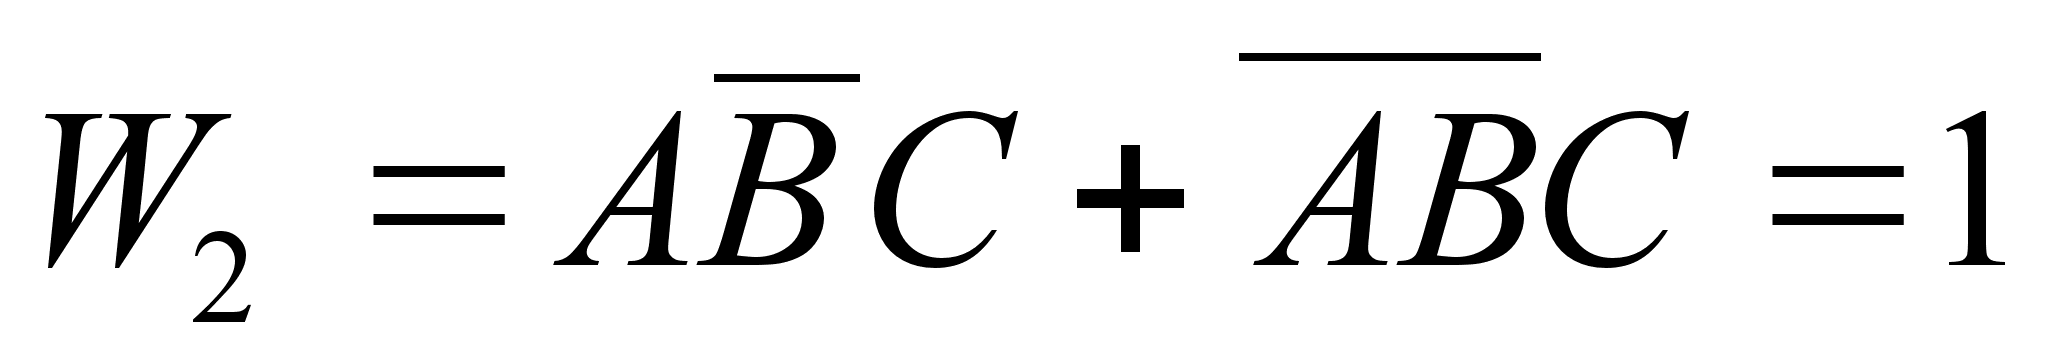
То есть, истинным является второе соотношение, соответствующее распознаванию ангины как диагностируемого класса из двух заболеваний.
Для алгоритмов, основанных на структурных (лингвистических) признаках, понятие “меры близости” более специфично.
С учетом того, что каждый класс описывается совокупностью предложений, характеризующих структурные особенности объектов соответствующих классов, распознавание неизвестного объекта осуществляется идентификацией предложения, описывающего этот объект, с одним из предложений в составе описания какого-либо класса.
При этом идентификация может подразумевать наибольшее сходство предложения, описывающего распознаваемый объект с предложениями из наборов описания каждого класса.
Рассмотрев задачу №5 , мы фактически завершили рассмотрение круга задач создания СР. В то же время уже отмечалось, что создание СР осуществляется последовательными приближениями по мере получения дополнительной информации. В этом ряду последовательных приближений главную роль играют признаки распознавания. От эффективности их набора зависит, эффективность системы в целом. В процессе совершенствования системы указанный набор пополняется, неэффективные признаки исключаются. Поэтому одной из задач создания СР должна быть и задача перехода от априорного словаря признаков к рабочему. То же касается и априорного алфавита классов.
ЗАДАЧА № 6
Определение рабочего алфавита классов и рабочего словаря признаков системы распознавания.
Настоящая задача на уровне разработки, прошедшей этапы решения задач 1 - 5, по крайней мере уже может быть поставлена, так как в результате выполнения предшествующих задач создана система распознавания первого приближения (априорный алфавит классов и априорный словарь признаков, выбран алгоритм распознавания).
Суть стоящей задачи - разработка такого (рабочего) алфавита классов и такого (рабочего) словаря признаков, которые обеспечили бы максимальное значение показателя эффективности распознавания. То есть, из априорного словаря мы должны выбрать признаки, позволяющие при всех имеющихся ограничениях на их получение (измерение) доставить максимум вероятности правильной классификации объектов (явлений) и (или) минимальные вероятности ошибочных классификаций создаваемой системой. Такой выбор не может не предполагать оценку указанных показателей до того, как создана система.
Указанное существо задачи заставляет снова обратить внимание на возможность получения оценки эффективности системы распознавания путем ее моделирования. Об этом мы говорили при создании априорного словаря признаков. К этому мы вернемся при специальном рассмотрении вопросов моделирования систем распознавания.
Что же касается приемов, обеспечивающих отбор в процессе оптимизации систем распознавания, то они являются также предметом отдельного рассмотрения.
Т е м а 3
Классификация систем распознавания
Л Е К Ц И Я 3.1
Принципы классификации и типы систем распознавания
При рассмотрении задач, решаемых в процессе создания систем распознавания (тема 2) , мы говорили о признаках объектов (явлений), о способах их получения в процессе работы СР, об использовании априорной информации, не затрагивая вопросов взаимосвязей в системе. Иногда только упоминали об этом .
В то же время, чтобы легче, сознательнее решать задачу выбора признаков (а это, как мы помним, - процесс эвристический), а также для планирования использования как априорной информации (описание классов), так и апостериорных данных (измерения по данному неизвестному подлежащему классификации объекту) эти взаимосвязи необходимо хорошо представлять.
Однако, как оказывается, упоминаемые взаимосвязи могут принимать различные формы, иметь свои особенности. Простое перечисление здесь не подходит. Поэтому представляется необходимым классифицировать сначала сами системы распознавания. Это позволит понять взаимосвязи в них и решать те задачи, о которых мы сейчас говорили.
Начнем с уточнения того, что такое классификация. Классификация - это распределение предметов, явлений по классам, отделам, разрядам в зависимости от их общих свойств.
В основе классификации лежат определенные принципы.
Для классификации СР будем использовать следующие принципы:
1.Однородность информации для описания распознаваемых объектов или явлений.
2.Способ получения апостериорной информации.
3.Количество первоначальной априорной информации.
4.Характер информации о признаках распознавания.
А. Рассмотрим 1-й принцип.
(Однородность информации)
Здесь под однородностью следует понимать - различную или единую физическую природу информации (признаков).
По этому принципу СР делятся на:
-простые;
-сложные.
Простые СР характеризуются единой физической природой признаков. Например:
1) только масса - для систем распознавания жетонов, монет в автоматах таких, как междугородный телефон, турникет метро;
2) геометрические размеры - для таких СР, как всякого рода замки.
Ясно, что для простых систем распознавания не обязательно иметь компьютер. Достаточно их реализовать в виде механических или электромеханических устройств. Хотя компьютерные реализации в принципе не противопоказаны, если наряду с этой в системе решаются и другие более достойные задачи.
Сложные СР характеризуются физической неоднородностью признаков.
В рассмотренном нами в теме № 2 перечне признаков самолетов такая неоднородность просматривается невооруженным глазом. Там имели:
-и численность экипажей;
-и высоты полета;
-и взлетный вес;
-и геометрические размеры и т.д.
Точно также в медицинской практике для диагностики может оказаться необходимым привлекать:
-и температуру;
-и данные анализа крови;
-и данные кровяного давления;
-и кардиограммы и т.п.
Конечно, простота всегда предпочтительнее. Хорошо иметь всего 1 - 2 признака и при этом желательно однородных, чтобы решать задачу компьютерного распознавания, например, заболеваний печени. Но не всегда, как и в этом случае, так получается. Сравните распознавания ключа замком и распознавание преступника по словесному портрету (набору признаков).
Б. Второй принцип классификации СР.
(Способ получения апостериорной информации).
По этому принципу сложные системы ( а мы уже знаем, что они собой представляют) распознавания делятся на:
-одноуровневые;
-многоуровневые.
На рис. 1 изображена одноуровневая система распознавания.
Здесь:
И1, И2,.....,Иn - разнородные по физической природе измерители.
АО - априорное описание классов распознаваемых объектов;
АК - алгоритм классификации;
САУ- система автоматического управления (алгоритм) распознаванием.
Многоуровневые сложные системы распознавания отличаются от одноуровневых тем, что не все признаки от разнородных физических измерителей используются непосредственно для решения задачи распознавания.
Здесь на основе объединения признаков нескольких измерителей и соответствующей обработки могут быть получены вторичные признаки, которые могут как использоваться в АК, так и сами в свою очередь служить основой для объединения. То есть, получаем 2-й, 3-й и др. уровни признаков, определяющие многоуровневость СР. Причем подсистемы, которые осуществляют объединение признаков, в свою очередь могут представлять собой также устройства распознавания (локальные СР).
Схема здесь в целом подобна предыдущей (для одноуровневой системы), а отличается лишь усложнением связей от признаков к АК.(Рис.2)
