Построение систем распознавания образов
Заметим, что те же действия предпринимались и для измерения признаков самолетов стороны В.
4-й шаг - на языке отобранных признаков описывается аналогично самолетам каждый класс заболеваний сердца, то есть, составляется перечень значений признаков каждого класса.
При этом для каждого класса должны быть выделены сведения:
-о наличии или отсутствии признаков качественного характера;
-о диапазонах или законах распределения признаков, имеющих количественное выражение.
Здесь также следует заметить, что все выбранные признаки должны получить соответствующее содержание (свое) для каждого класса.
Теперь, если с помощью выбранных средств диагностики состояний сердца оценены признаки, характеризующие его деятельность, то сопоставление полученных апостериорных данных (по результатам опытных измерений) с априорными (доопытным описанием классов) позволяет произвести распознавание конкретного класса заболеваний или отсутствие заболеваний вообще.
Эти два примера показали, что подходы к построению систем распознавания практически ничем не отличаются, несмотря на специфику самих создаваемых систем.
В результате мы получили общие представления о последовательности решения и составляющих задачи создания системы распознавания. В результате отмечаем, что несмотря на различие предметных областей подходы к построению СР - одинаковы. Система распознаваний заболеваний сердца строилась также, как и система распознавания самолетов, но заменить ее она не позволяет. Точно также СР самолетов не может применяться для решения задач распознавания заболеваний сердца.
Системы распознавания объектов (явлений), создаваемые человеком всегда узко специализированы в отличии от его собственных природных возможностей.
Что же касается общего подхода к построению любой системы, то теперь, если у нас имеется некоторая совокупность объектов или явлений, которые необходимо распознавать (классифицировать), на основе обобщения действий при создании СР в 2-х рассмотренных примерах мы знаем, что последовательность решения соответствующих задач следующая:
-в соответствии с выбранным принципом совокупность объектов или явлений подразделяется на ряд классов (говорят: назначается алфавит классов);
-разрабатывается совокупность признаков (говорят: словарь);
-на языке словаря признаков описывается каждый класс;
-выбираются и (или) создаются средства определения признаков;
-на вычислительных средствах реализуется алгоритм сопоставления апостериорных и априорных данных и принимается решение о результатах распознавания.
В то же время, несмотря на выполненное определение последовательности действий, проведенное рассмотрение не позволяет ответить на следующие вопросы:
-как лучше производить разбиение объектов (самолеты, заболевания и пр.) по классам;
-как накапливать и обрабатывать априорную информацию;
-из каких соображений выбирать признаки;
-как описывать классы на языке признаков;
-на основе каких методов сравнивать априорную и апостериорную информацию;
-когда и как появляется вся система распознавания.
Все эти вопросы являются предметом рассмотрения в пределах читаемого курса. Мы будем их детализировать все более глубоко по мере освоения предмета.
На последний вопрос следует дать предварительный ответ до того, как мы проведем упомянутое углубленное изучение. Система должна появляться с самого начала изучения вопроса. Этот вариант ее должен представлять собой модель-прообраз будущей системы распознавания. Сейчас мы должны понять только одно - без такой модели создание СР чаще всего невозможно вообще. Без нее мы не сможем выбрать ни набор классов, ни перечень признаков, ни средства измерений их, ни решающие правила, обеспечивающие в комплексе, во взаимосвязи требуемое качество решений о принадлежности. Это обусловлено тем, что полная информация для создания СР на момент начала ее создания всегда отсутствует и без экспериментальной отработки всего процесса принятия решений не всегда ясно, какая информация может вообще потребоваться. Поэтому модель должна позволить методом последовательных приближений внутренней структуры системы к требуемой достигнуть желаемого результата. В то же время вопросы моделирования СР не могут быть рассмотрены на нынешнем уровне полученных знаний. Поэтому моделирование СР - предмет дальнейшего изучения курса "Основ построения систем распознавания образов"
Итак, главные выводы:
1. Задачи, решаемые в процессе создания систем распознавания, инвариантны относительно предметной области, имеют много общего, основываются на едином методологическом подходе.
2. Каждая система распознавания индивидуальна и предназначается только для одного вполне конкретного вида объектов или явлений.
Если найдена сфера применения распознавания, то соответствующая система должна разрабатываться заново с учетом новых специфических свойств объектов (явлений), определяющих как систему измерений характеристик, так и словарь признаков, алфавит классов и алгоритм принятия решений.
3. СР должна создаваться методом последовательных приближений внутренней структуры на ее математической модели по мере накопления необходимой информации.
Теперь, после того как мы на качественном уровне рассмотрели проблематику распознавания, можно провести дополнительную детализацию и определить последовательность задач создания соответствующих систем.
Л Е К Ц И Я 2.2
Формулировка задач создания систем
распознавания и методы их решения
ЗАДАЧА № 1
Определение полного перечня признаков (параметров), характеризующих объекты или явления, для которых данная система разрабатывается.
В решении этой задачи - главное найти все признаки, характеризующие существо распознаваемых объектов (явлений). Любые ограничения, любая неполнота, как мы в последующем убедимся, приводят к ошибкам или полной невозможности правильной классификации объектов (явлений).
Можем себе представить такую неполноту в уже рассмотренной нами задаче распознавания самолетов как использование одного признака - потолок высоты полета самолетов. В результате - бомбардировщики не удастся отличать от истребителей ( при создании бомбардировщиков стремятся к обеспечению максимально возможной высоты полета, а при создании истребителей добиваются, чтобы они могли уничтожать бомбардировщики).
Реально даже целая группа признаков может оказаться неэффективной.
Поэтому для решения 1-ой задачи создания СР необходимо найти все возможные признаки, описывающие объекты распознавания, с тем, чтобы при оценке эффективности решений системы не возвращаться к этой задаче, обнаружив ограниченность выбранных признаков на последующих этапах разработки.
Но чтобы назначать признаки распознавания, необходимо, во-первых, понять, что не существует способов их автоматической генерации. На сегодня это под силу только человеку. Поэтому говорят, что выбор признаков - эвристическая операция. Во-вторых, выбор признаков можно осуществлять, имея представление об их общих свойствах. С этих позиций достаточно принять, что признаки могут подразделяться на:
-детерминированные;
-вероятностные;
-логические;
-структурные.
А. Детерминированные признаки - это такие характеристики объектов или явлений, которые имеют конкретные и постоянные числовые значения.
Примерами детерминированных признаков могут быть, например, ТТХ бомбардировщиков и истребителей США (таблицы № 1, 2).
Числовые значения признаков по каждому из самолетов можно интерпретировать как координаты точек, представляющих каждый самолет в 11-мерном пространстве признаков.
Необходимо иметь в виду, что в задачах распознавания с детерминированными признаками ошибки измерения этих признаков не играют никакой роли, если, например, точность измерений такого признака, как размах крыльев самолета значительно выше (например, 1 мм), чем различие этого признака у разных классов самолетов (например, 10 м).
Представить такую систему, где используются детерминированные признаки не так трудно:
-распознавание принадлежности самолета, данные которого получены разведкой или из открытой печати и не привязаны к классам (бомбардировщик- А1, истребитель-А2 и т.п.);
-распознавание на конвейере деталей по отличию геометрических характеристик, если ошибки измерений существенно меньше разметов этих деталей.
Распознавание осуществляется путем сравнения полученных размеров с имеющимися в базе данных характеристиками деталей.
Б. Вероятностные признаки - это характеристики объекта (явления), носящие случайный характер.
С такими признаками в основном и имеют дело в природе и технике.
Отличаются эти признаки тем, что в силу случайности соответствующей величины признак одного класса может принимать значения из области значений других классов, каждый из которых подлежит распознаванию в системе.
Таблица № 1
| Характеристики | Т и п ы с а м о л е т о в | |||
| В-1А | В-52 | В-57А |
FB-111 |
|
| Экипаж (чел.) | 4 | 6 | 2 | 2 |
|
Vmax (кмч) при H=15 км |
2330 | 1020 | 935 | 2330 |
|
Vmin (кмч) при H=0.3 км |
1200 |
500 |
500 | 1350 |
| Потолок (м) | 15240 | 15000 | 13750 | 20000 |
| Бомб.нагрузка (т) | 22 | 34 | 14 | 16 |
| Макс.взлетная масса (т) | 180 | 221 | 25 | 45 |
| Размах крыльев (м) | 42 | 56 | 19 | 21 |
| Длина самолета (м) | 44 | 48 | 20 | 22 |
| Кол-во двигателей | 4 | 8 | 2 | 2 |
| Тяга двигателей (т) | 13.6 | 7.7 | 3.3 | 9.2 |
| Дальность полета (км | 11000 | 20000 | 4380 | 6600 |
Таблица № 2
| Характериcтики | Т и п ы с а м о л е т о в | ||||
|
F - 4 E Фантом |
F - 105 E Тандер-чиф |
F - 15 Игл |
F - 100 D Супер-сейбр |
Хантер | |
| Экипаж (чел.) | 2 | 2 | 1 | 1 | 1 |
|
Vmax (кмч) при H =15 км |
2330 | 2230 | 2655 | 1400 | 1000 |
|
Vmin (кмч) при H =0.3 (км) |
1470 | 1400 | 1470 | 1220 | 1150 |
| Потолок (м) | 19000 | 15000 | 21000 | 15000 | 17000 |
| Бомб.нагр. (т) | 7.2 | 6.4 | - | 3.4 | 0.9 |
| Макс.взлетн. масса (т) | 26 | 24 | 25 | 18 | 11 |
| Размах крыльев (м) | 12 | 11 | 14 | 11 | 10 |
| Длина самолета (м) | 18 | 21 | 19 | 12 | 13 |
| Кол-во двигателей | 2 | 1 | 2 | 1 | 1 |
| Тяга двигателей (т) | 5.4 | 12 | 10.9 | 5.3 | 4.5 |
| Дальность полета (км) | 885 | 760 | 1100 | 860 | 560 |
Если признак не может принять значений в области соответствующих значений для других классов, то, следовательно, имеем дело не с вероятностным, а с тем же детерминированным признаком. Это как раз подчеркивает, почему вероятностные системы являются системами более общего порядка.
Для того, чтобы можно было в условиях случайности говорить о возможности распознавания, следует потребовать, чтобы вероятности наблюдения значений признака в своем классе были как можно больше, чем в чужих. В противном случае данный признак не позволит построить СР, использующую описание классов на его основе. Эффективность его недостаточна для достоверного решения и необходимо искать другие признаки, имеющие большую разделительную способность.
Вспомним из теории вероятностей, чем характеризуется случайная величина - законом распределения вероятностей. То есть, точно так же законом распределения должен характеризоваться каждый вероятностный признак.
Вспомним и то, что в качестве законов распределения вероятностей в теории вероятностей выступают интегральная функция F(x) - интегральный закон или плотность распределения вероятностей (ПРВ) - дифференциальный закон f(x). При этом связь между ними:
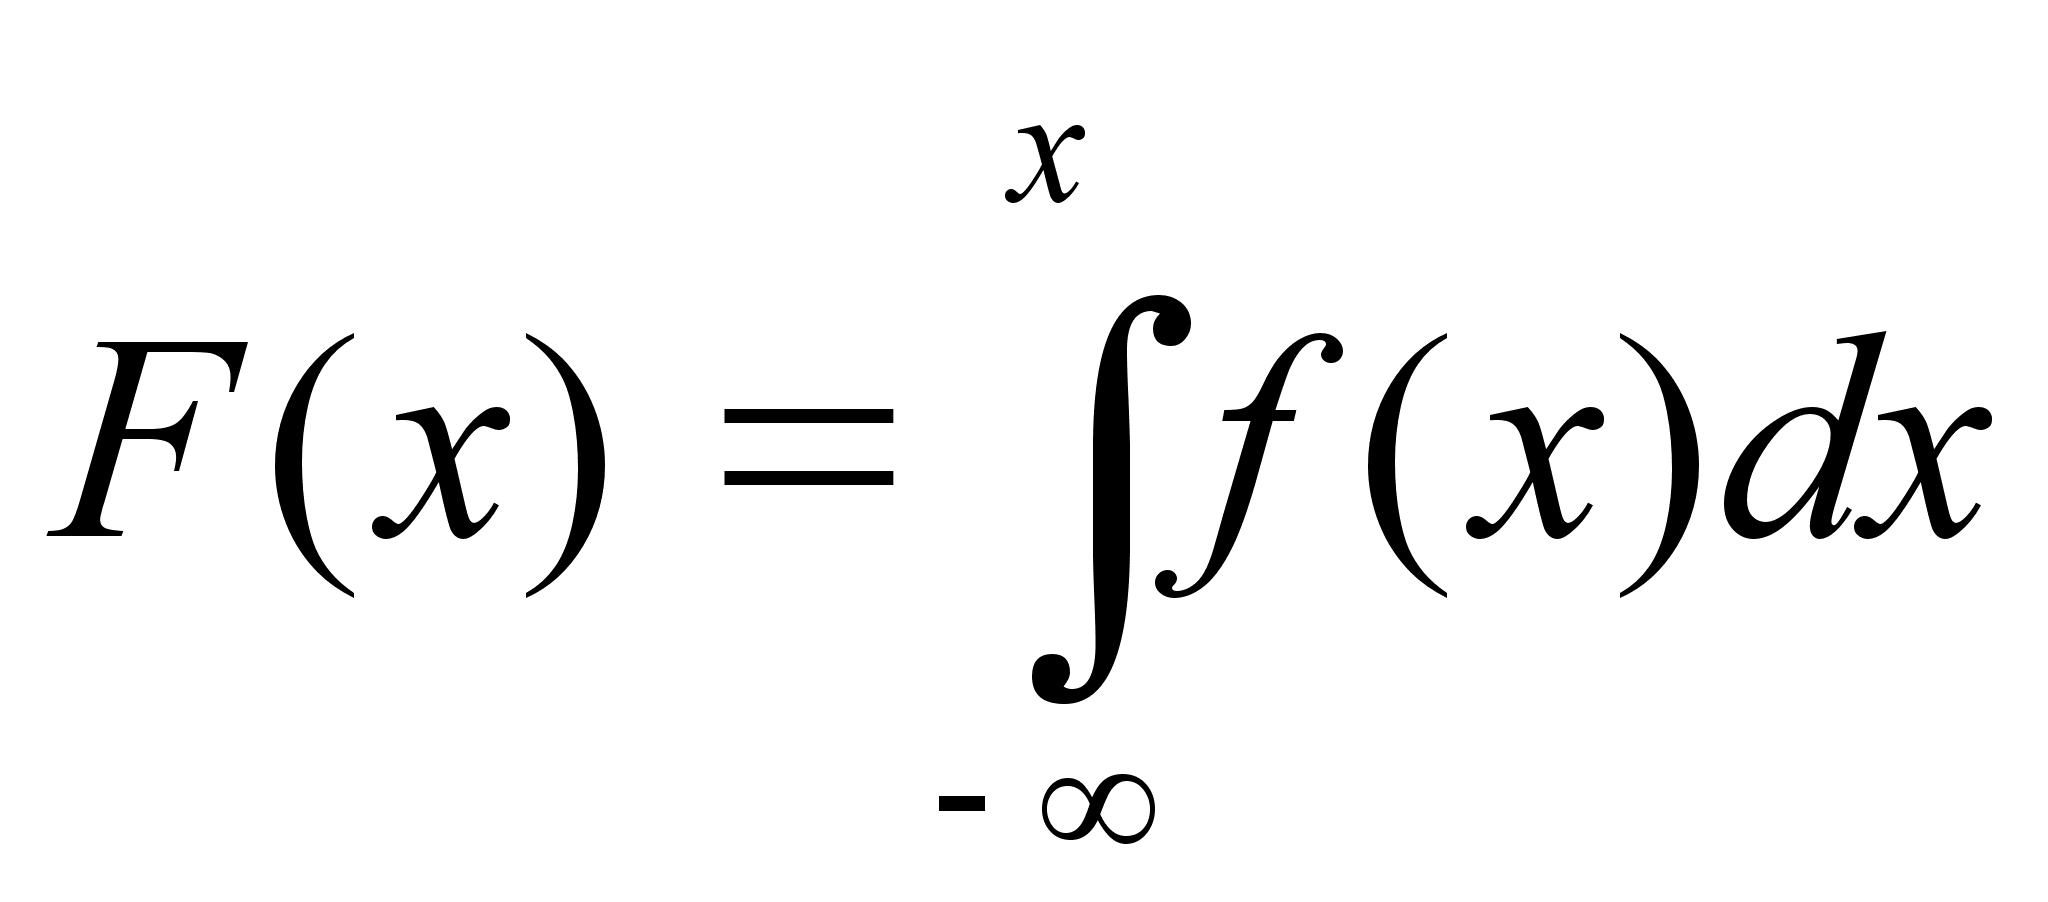
Вспомним, что самый распространенный в природе закон распределения - нормальный или Гауссов - имеет ПРВ
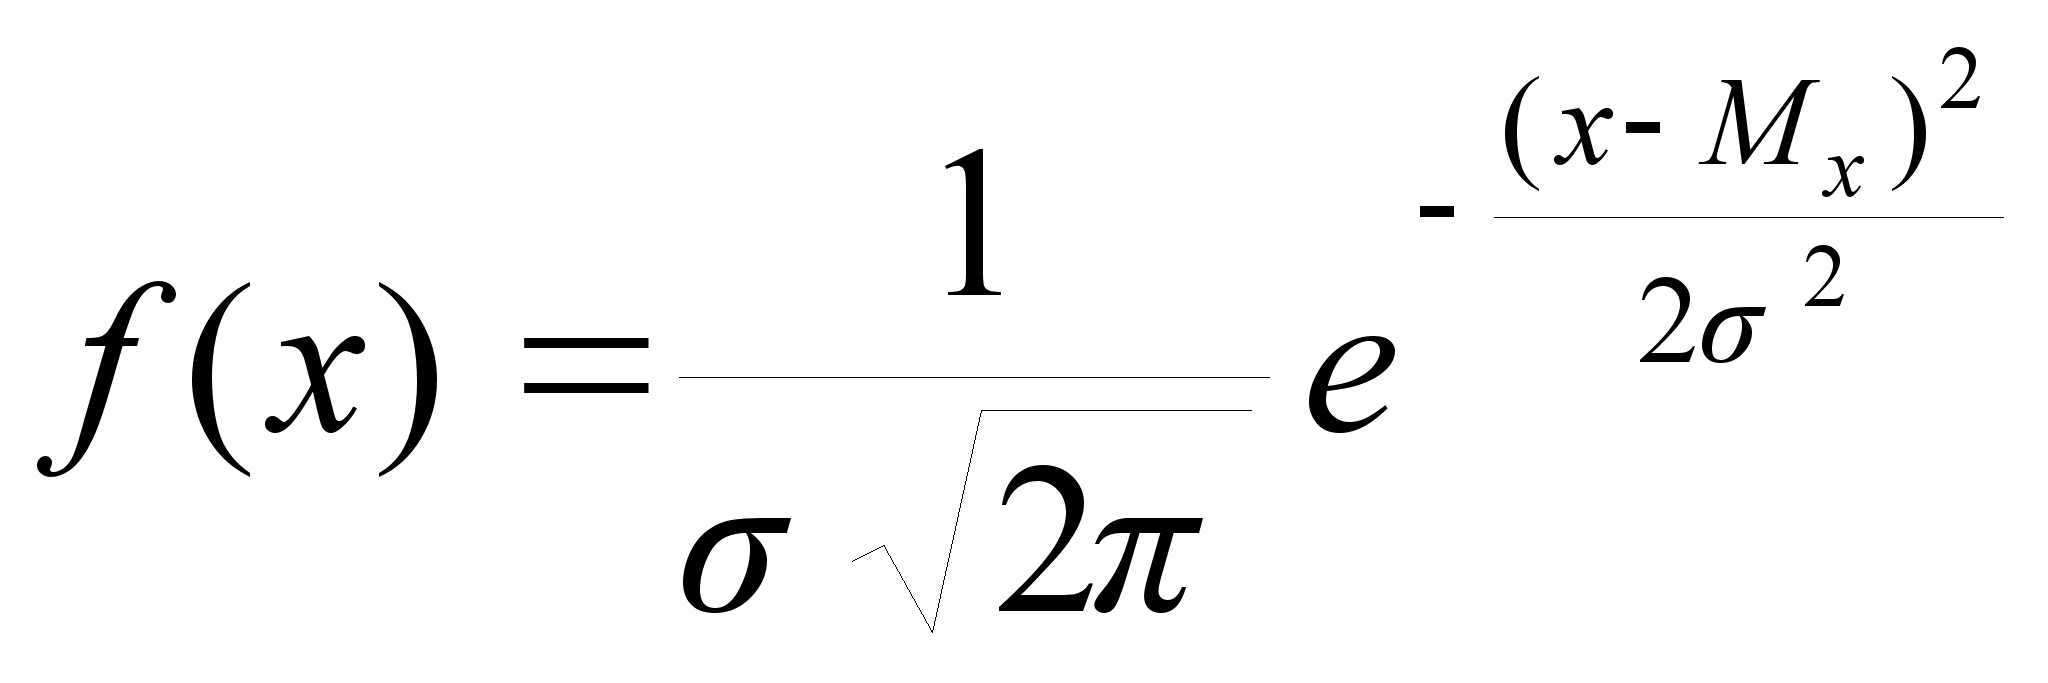
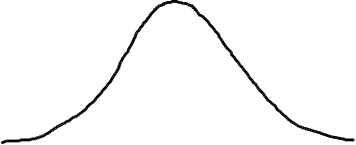
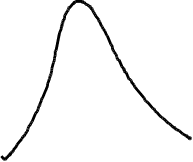
Если предположить, что какой-либо вероятностный признак (например, размах крыльев, измеренный каким-либо средством измерений с ошибками) распределен по нормальному закону, то для 3-х условных классов, отличающихся размахами крыльев, распределения этого параметра будут выглядеть, как показано на рис.2.1.
Из рис. 2.1 видно, что если для неизвестного самолета мы с помощью упомянутого средства измерений определили размах крыльев Lкр с естественной случайной ошибкой , то с определенной вероятностью это измерение может быть отнесено к каждому из классов. Однако, легко заметить, что если это значение лежит ближе к одному из центров рассеяния (например, Mx1), то вероятность отнесения его к соответствующему распределению, а значит и классу, максимальная.
 f(Lкр)
Mx1 Mx2 Mx3 Lкр
Рис.2.1
Примеры вероятностных признаков распознавания:
-среднее значение мощности сигнала радиолокатора, отраженного от самолета (причина - изрезанность круговой диаграммы рассеяния сигнала радиолокатора самолетом и электронные и атмосферные шумы в том же радиолокационном диапазоне);
-размер листа растения (причины - отличия в питании, освещенности, влаги и т.п.);
-размер патологического изменения какого-либо органа человека (причины - различные стадии заболевания при его обнаружении, различные ракурсы и сечения наблюдений образования и т.п.) и т.д.
В. Логические признаки распознавания - это характеристики объекта или явления, представленные в виде элементарных высказываний об истинности (“да”, "нет” или “истина”, “ложь”).
Эти признаки, как мы понимаем, не имеют количественного выражения, то есть являются качественными суждениями о наличии, либо об отсутствии некоторых свойств или составляющих у объектов или явлений.
Примеры логических признаков:
-наличие ТРД на самолете ;
-боль в горле пациента ;
-кашель ;
-насморк ;
-растворимость реактива и т.д.
Здесь по каждому признаку можно сказать только то, что он есть, либо его нет.
К логическим можно отнести также такие признаки, у которых не важна величина, а лишь факт попадания или непопадания ее в заданный интервал. (например, крейсерская скорость самолета больше или меньше 2000 км/ч).
Г. Структурные признаки - непроизводные (то есть, элементарные, не производимые из других элементарных признаков) элементы (символы), примитивы изображения объекта распознавания.
Появление структурных признаков обязано возникновению проблемы распознавания изображений с ее специфическими особенностями и трудностями.
Примеры структурных признаков:
а)для изображения прямоугольника:
- горизонтальный отрезок прямой;
- вертикальный отрезок прямой.
б) для любого изображения на экране дисплея:
-пиксел.
Забегая далеко вперед в изложении материала, следует отметить, что традиционно для описания изображений использовались разложения его в ряды по ортогональным функциям (ряды Фурье, полиномы Эрмита, Лежандра, Чебышева, разложения Карунена-Лоэва и др.).
Структурное описание в отличии от разложений:
-понятнее (физичнее) для человека, решающего задачу распознавания объекта;
-приемлемо и для компьютерной реализации при распознавании;
-свободно от трудоемкости вычислений и потерь информации, свойственных разложениям.
Оказывается, что оперируя ограниченным числом атомарных (непроизводных) элементов (примитивов), можно получить описание разнообразных объектов. То есть, для отличающихся объектов можно иметь набор одинаковых непроизводных элементов. Но для того, чтобы описание можно было бы выполнить, наряду с определением непроизводных элементов должны вводиться правила комбинирования, определяющие способы построения объекта из упомянутых непроизводных элементов. В результате два одинаковых непроизводных элемента различных объектов могут быть соединены друг с другом по разным правилам. Это и будет их отличать.
В целом для описания какого-либо объекта непроизводные элементы объединяются в цепочки (предложения) по своему, характерному только для этого объекта, набору правил.
В результате связей из непроизводных элементов (структурных признаков) образуется объект, аналогично тому, как предложения языка строятся путем соединения слов, в свою очередь состоящих из букв. В этом структурные методы проявляют аналогию с синтаксисом естественного языка. Отсюда структурные признаки носят еще название лингвистических или синтаксических.
( Пример - код Фримена).
* * *
Таким образом, мы рассмотрели очень подробно 1-ую задачу создания систем распознавания - определение полного перечня признаков (параметров), характеризующих объекты или явления, для которых данная система разрабатывается. Главные выводы:
1) Выбор, назначение признаков распознавания - эвристическая операция, зависящая от творчества, изобретательности разработчика.
2) Состав признаков , выбираемых на этом этапе, должен быть как можно более разносторонним и полным, независимым от того, можно или нельзя эти признаки получить.
3) Выбор признаков должен осуществляться в группах детерминированных, вероятностных, логических и структурных.
Л Е К Ц И Я 2.3
Формулировка задач создания систем
распознавания и методы их решения
( продолжение)
ЗАДАЧА № 2
Первоначальная классификация объектов (явлений), подлежащих распознаванию, составление априорного алфавита классов.
Нам уже знакома на описательном уровне эта задача: необходимо выбрать (назначить) классы объектов (явлений) распознавания. Решение ее осуществляется наиболее часто эвристически, как и выбор признаков распознавания, а логика ее решения следующая:
1-е - определяется, какие решения могут приниматься по результатам распознавания либо человеком, либо автоматической системой управления объектом (цель распознавания).
2-е - на основе определенной выше цели формулируются требования к системе распознавания, позволяющие выбрать принцип классификации.
3-е - составляется априорный алфавит классов объектов (явлений).
Предположим по результатам некоторого метода медицинской диагностики состояния печени человека необходимо принимать решения о методе лечения (см.1-й пункт в рассмотренной последовательности решения задачи априорной классификации - цель). Насколько серьезно принятие такого решения, учитывая возможность хирургического вмешательства, я надеюсь, понятно.
Тогда, очевидно, что требованием к системе (см.2-й пункт последовательности) - надежное (с высокой вероятностью) диагностирование каждого заболевания печени.
Следовательно, в априорный алфавит классов (см.3-й пункт рассмотренной последовательности) необходимо включить все возможные заболевания печени, а их - 11. То есть, классов распознаваемых заболеваний печени, диагностируемых некоторой гипотетической системой распознавания должно быть 11. Для более четкого понимания назовем эти классы:
1.Острый гепатит.
2.Хронический гепатит.
3.Жировая инфильтрация.
4.Цирроз.
5.Киста простая.
6.Киста паразитарная.
7.Абсцесс.
8.Опухоль.
9.Метастазы.
10.Гематома.
11.Конкременты.
Заметим, что, кроме ситуации, предложенной рассмотренной задачи, возможны и другие, когда количество классов, по которым надежно распознаются некоторые объекты (явления), заранее неизвестно и должно определяться самой системой распознавания. Эта задача называется задачей кластеризации, в которой можно отказаться уже от эвристического подхода. Однако решение здесь достигается при выборе некоторых общих правил кластеризации, которые задает разработчик системы.
ЗАДАЧА № 3
Разработка априорного словаря признаков распознавания.
Решая задачу №1, мы должны были найти все возможные признаки распознавания заданных объектов или явлений. Точно также при решении задачи №2 определился состав классов.
Теперь, располагая соответствующим перечнем и априорным алфавитом классов, необходимо провести анализ возможностей измерения признаков или расчета их по данным измерений, выбрать те из них, которые обеспечиваются измерениями, а также в случае необходимости разработать предложения и создать новые средства измерений для обеспечения требуемой эффективности распознавания.
Таким образом, главное содержание рассматриваемой задачи построения СР - создание словаря, обеспечиваемого реально возможными измерениями.
Однако, хороший или плохой набор признаков распознавания, получился в результате указанных действий разработчика СР, можно понять, выполнив испытания системы распознавания в целом и оценив эффективность распознавания. Но системы распознавания на указанном этапе разработки еще не существует. В то же время, как мы заметили, появилась необходимость оценки эффективности. И рассматривая очередные задачи создания СР, мы обнаружим, что рассматриваемая задача остается актуальной на протяжении всех последующих этапов создания системы распознавания (описание классов, выбор алгоритма распознавания). Только методом последовательных приближений удается добиться выбора словаря признаков, обеспечивающего желаемое качество решений.
Выходом из создавшегося положения является возможность создания на данном этапе математической модели системы. Математические модели СР и используются для реализации указанных последовательных приближений, о чем упоминалось на описательном уровне при рассмотрении задач построения систем распознавания.
ЗАДАЧА № 4
Описание классов априорного алфавита на языке априорного словаря признаков.
Априорное описание классов - наиболее трудоемкая из задач в процессе создания системы распознавания, требующая глубокого изучения свойств объектов распознавания, а также и наиболее творческая задача.
В рамках этой задачи необходимо каждому классу поставить в соответствие числовые параметры детерминированных и вероятностных признаков, значения логических признаков и предложения, составленные из структурных признаков-примитивов.
Значения этих параметров описаний можно получить из совокупности следующих работ и действий:
-специально поставленные экспериментальные работы или --экспериментальные наблюдения;
-результаты обработки экспериментальных данных;
-математические расчеты;
-результаты математического моделирования;
-извлечения из литературных источников.
Что же такое описание класса на языке признаков? Рассмотрим это отдельно для детерминированных, вероятностных, логических и структурных признаков.
Если признаки распознаваемых объектов - детерминированные, то описанием класса может быть точка в №-мерном пространстве детерминированных признаков из априорного словаря, сумма расстояний которой от точек, представляющих объекты данного класса, минимальна.
Легко себе представить такой эталон, вернувшись к рассмотренным нами таблицам ТТХ самолетов. Здесь мы имеем дело с 11-мерным пространством признаков. Каждая координата - это одна какая-нибудь характеристика, например “экипаж”. Если рассматривать только одну координату “экипаж”, то точкой эталона для истребителей будет - 1, для бомбардировщиков - 4. Это точки, суммы расстояний которых от всех истребителей и всех бомбардировщиков, представляющих эти два класса, минимальны.
Точно также это можно сделать по всем 11 координатам (т.е. “потолок”, “размах крыльев”, ”бомбовая нагрузка “ и т.д.), в результате чего будем уже иметь дело с точками эталонов в 11-мерном пространстве.
Если признаки распознавания - логические, то для описания каждого класса необходимо прежде всего иметь полный набор элементарных логических высказываний A,B,C, входящих в состав априорного словаря. Но это только признаки. Для описания классов этого недостаточно. Еще необходимо установить соответствие между набором значений приведенных признаков A,B,C и классами W1, W2,...Wm.
Так для простоты понимания и без притязаний на медицинскую достоверность возьмем такой пример: необходимо распознавать два заболевания - обычная простуда и ангина (W1,W2), а в качестве логических признаков выберем
А - повышенная температура (А=0 - нет, А=1 - да);
В - насморк (В=0 - нет, В=1 - да);
С - нарывы в горле (С=0 - нет, С=1 - да).
Тогда так называемое булево соотношение между классом W1 (обычное простудное заболевание) и значениями признаками (а эти значения - бинарные) выглядит так
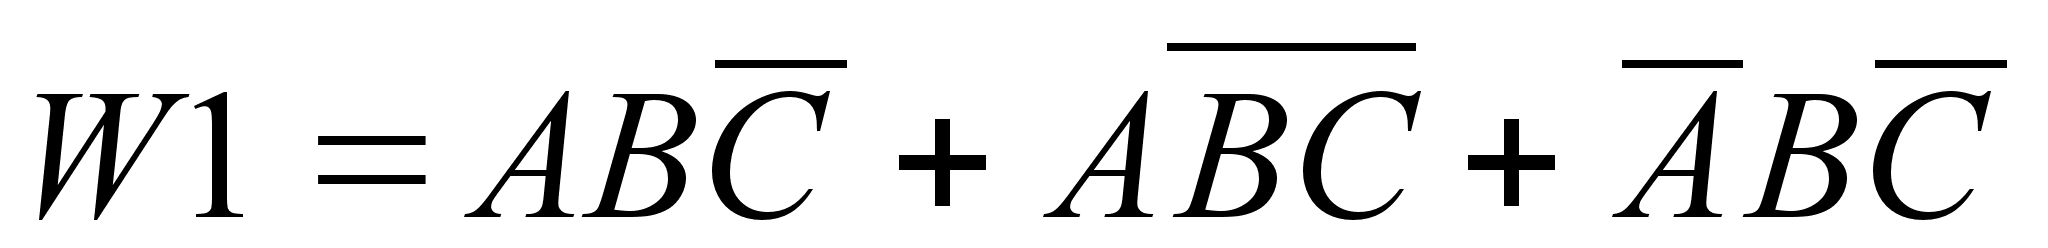
Здесь умножение, как вы знаете, соответствует логическому “И”, а сложение - “ИЛИ”.
Точно также для второго класса заболеваний получим следующее описание
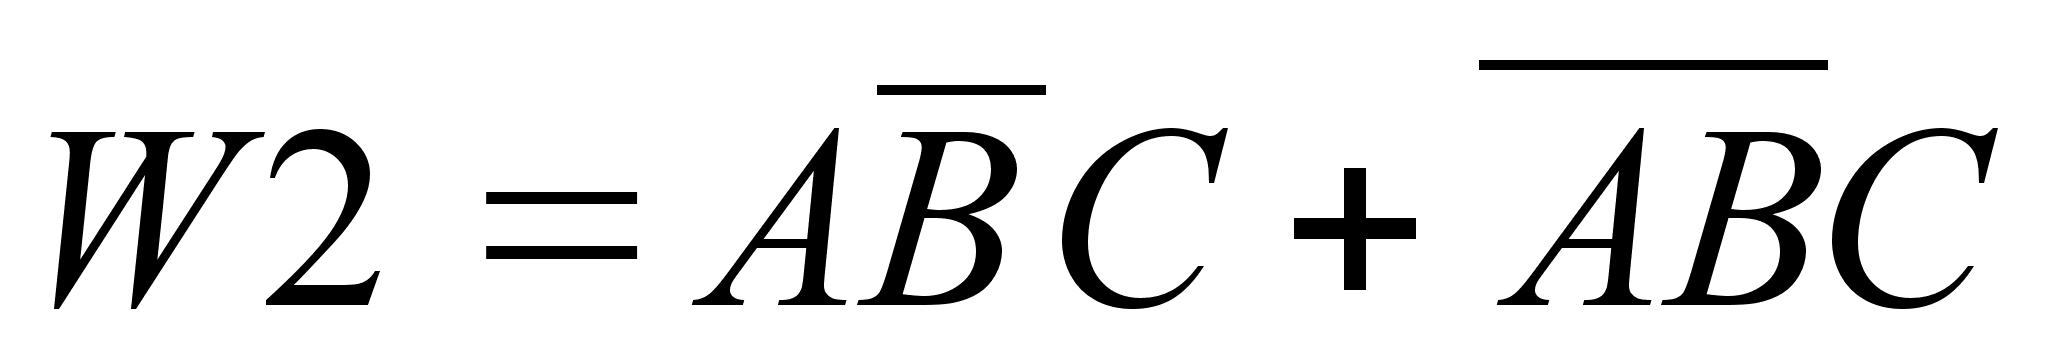
Подробнее здесь мы эти вопросы не рассматриваем, так как логическим системам в дальнейшем курсе уделим достаточное внимание.
Если распределение объектов распознавания, представляемых числовыми значениями их признаков по областям соответствующего пространства вероятностное, то для описания классов необходимо определить характеристики этих распределений. А из теории вероятности известно, что это
-функции ПРВ fi (x1,x2,....,xn),