Построение систем распознавания образов
Для решения таких задач приведенные схемы СР должны быть дополнены соответствующими функциональными связями дообучения.
* * *
Классификация СР была бы неполной, если бы мы не коснулись экспертных систем, стоящих несколько в стороне от приведенной методологии построения изучаемых нами классических СР.
Как вы уже знаете, эти системы основываются на методах искусственного интеллекта.
Классические решения задач распознавания основываются на моделировании математико-алгоритмических функций (уравнения, системы уравнений) детерминированных или стохастических систем с точным определением области применения, значений параметров, диапазонов сигналов, интервалов времени, частотных диапазонов и т.п. Эти задачи опираются на надежные, точно научно обоснованные знания. В них реализуются новые и оригинальные достижения высококвалифицированных специалистов, имеющих в то же время узкую специализацию. Однако такие специалисты достаточно редки. Это и побуждает создавать экспертные системы, основанные на представлении неалгоритмического, логического, декларативного характера, нечеткого и слабо формализованного знания в виде множества фактов и правил, причинно-следственных связей.
Указанные знания при этом могут быть как заслуживающими доверия и опробированными многочисленными независимыми применениями, так и сомнительными.
Экспертные системы распознавания - это специализированные автоматы обработки знаний для интерактивного и кооперативного решения проблем распознавания на естественном профессиональном языке со способностями приобретения, хранения и представления знаний в форме алгоритмических программ с одной стороны и неалгоритмических фактов и правил, с другой стороны.
Изучение экспертных систем - это отдельный предмет с его методами и подходами.
Т е м а 4
Оптимизация эвристических выборов при создании систем распознавания образов
Л е к ц и я 4.1
Оптимизация алфавита классов и словаря признаков
4.1.1. Уточнение назначения и цели создания СР
Как нами уже установлено, процесс распознавания включает такую последовательность операций:
- прием на входе СР образа распознаваемого объекта;
-cопоставление апостериорной информации поступившего объекта с имеющимся в СР априорным описанием классов всех объектов, подлежащих распознаванию (объектов, на которые рассчитана система);
- принятие решения об отнесении объекта, образ которого был принят, к одному из классов.
Правило, согласно которому объекту, образ которого принят, ставится в соответствие наименование класса, называется решающим правилом.
В литературе широко распространено мнение, что суть проблемы распознавания и состоит в определении такого решающего правила. То есть, центральной задачей часто считается нахождение в признаковом пространстве таких границ, которые некоторым оптимальным образом (например, по критерию минимума ошибок распознавания) разделяют это пространство на области, соответствующие классам.
При этом нами четко установлено, что в зависимости от объема априорной информации возможно два подхода к определению решающих правил (границ между классами в признаковом пространстве):
1. Непосредственное предварительное определение при достаточном количестве априорной информации (СР без обучения).
2.Постепенное уточнение в ходе работы СР по назначению при наборе достаточного количества информации (обучающиеся СР).
Каждый их подходов основан на том, что априорный словарь признаков и алфавит классов известны. При отсутствии априорного алфавита классов применяется подход, реализуемый в самообучающейся СР. Однако при этом заранее должны быть известны словарь признаков и , кроме
того, набор некоторых правил назначения классов в процессе самообучения. Решающие правила здесь определяются как итог нахождения алфавита классов.
Исторически сложилось, что первые теоретические и прикладные работы в области распознавания основывались на полной определенности алфавита классов и словаре признаков. При этом проблема распознавания сводилась обычно к проблеме оптимального в некотором смысле определения решающих правил , решающих границ между классами.
Широкая практика создания СР в последующие годы (особенно в военных приложениях) и дальнейшее развитие теории распознавания убедительно показали, что приведенное отношение устарело. При построении реальных СР даже при известных признаках и классах приходится решать сложную и дорогостоящую задачу разработки, ввода и использования специальных измерительных средств и комплексов таких средств с ЭВМ. Эти средства и комплексы оказываются главным элементом в получении признаков распознавания.
При этом реализация решающего правила - это алгоритмическая задача, решение которой отодвигается на второй план сложностью и ценой задачи создания измерительных средств.
Кроме того, для логических и структурных СР о поиске решающих правил вообще не может быть и речи. Они известны. В логических СР - это правила определения неизвестных в булевых уравнениях, в структурных - правила определения правильности конструкции предложения. Этот факт поэтому и является дополнительным доказательством первостепенной важности задачи определения признаков и классов.
В результате представляется возможным сформулировать назначение любой СР.
Назначение СР - получение информации, необходимой для принятия решения о принадлежности неизвестных объектов (явлений) к тому или иному классу.
Такое определение наиболее плодотворно для сложных систем.
Оно заставляет сосредоточить усилия в создании СР на главном направлении.
(Примером главенства информации могут служить медицинские СР, геологические, метеорологические, криминалистические, системы контроля космического пространства страны).
Но и принятие решений о принадлежности - не самоцель. Поэтому второй момент, на который нам необходимо обратить внимание до перехода к теоретическим описаниям рассматриваемых в этой теме задач, - это необходимость понимания того, что любая СР является частью какой-либо системы управления ( автоматической или автоматизированной).
Отсюда легко формируется цель создания СР.
Цель создания СР - обеспечение высокой эффективности принимаемых решений в управлении.
Приведенные определения позволяют более критично отнестись к тому факту, что информация, которая лежит в основе принятия решений и обеспечивает достижение цели распознавания, основывается на эвристическом методе ее получения.
Из рассмотрения содержания задач построения СР следует, что словарь признаков распознавания и алфавит классов формируются человеком на основе его знаний, опыта, интуиции. В то же время ответственность за решения может быть очень велика.
Поэтому очень важно найти объективные методы оценки такого рода человеческой деятельности.
На это мы и направим последующий анализ.
- Взаимосвязь размерности алфавита классов и эффективности СР
Мы пока еще не затрагивали вопросов такой взаимосвязи, хотя как алфавит классов, так и словарь признаков определили и имеем представление о их выборе. Однако, обсуждение вопросов составления словаря признаков и выбора алфавита классов никак не затрагивало их взаимосвязи. В то же время мы понимаем, что наличие связей двух явлений, объектов, процессов вообще достаточно часто позволяет выяснить некоторые ограничения составляющих. Попытаемся их поискать для таких объектов, как словарь признаков и алфавит классов.
Оказывается, что отмеченные особенности и приведенные определения назначения и цели создания СР уже определяют взаимосвязи между классами и принимаемыми решениями.
Рассмотрим, какие же это взаимосвязи, в чем их существо. Очевидно, главное, что накладывает на них отпечаток - это необходимость достижения высокой эффективности решений.
Отсюда можно утверждать, что в управлении высокая эффективность решений достигается:
1)Увеличением числа классов в принятом алфавите, то есть, повышением степени детализации распознаваемых объектов (явлений) по назначению и характеру. При этом чем детальнее классификация, тем легче предпринять адекватное управление. ( Вполне понятно, что распознать просто отказ двигателя автомобиля менее привлекательно, чем указать на выход из строя клапана или масляного насоса).
2)Повышением точности определения признаков распознавания, а значит снижением возможности ошибочных решений, часто опасных для управления (снижение ошибок классификации).
Так, если ошибки измерения координат падающего КО большие, то можно как ошибочно самоуспокоиться, предполагая точку падания за пределами интересующей нас зоны ответственности, так и ошибочно объявить тревогу и даже вызвать панику.
В то же время увеличение числа классов в любой задаче, как можно понять только из соображений здравого смысла
( в дальнейшем мы это опишем более строго математически) не всегда просто, а иногда оказывается и невозможно.
Но существует одна ситуация, когда это увеличение всего на один класс бесспорно важно. Так для того, чтобы результаты распознавания были более приемлемы для последующего управления, приходится дополнительно к имеющимся m классам вводить (m+1)-ый, когда отказываются от распознавания, а значит и от управления. Отказ от управления лучше, чем управление при ошибочности распознанной ситуации (если это возможно по назначению системы).
Теперь постараемся понять имеющиеся связи, рассматривая отношения между числом классов и ошибками распознавания. Для удобства рассматриваем одномерный случай (вместо вектора признаков без ущерба для задачи, но для ясности физических представлений, имеем один признак.
Пусть заданы три класса объектов W1, W2, W3
- распределениями вероятностей f(x/W1), f(x/W2 ), f(x/W3 ), где x - вероятностный признак распознавания ;
- априорными вероятностями P(W1), P(W2), P(W3);
- матрицей потерь при решениях
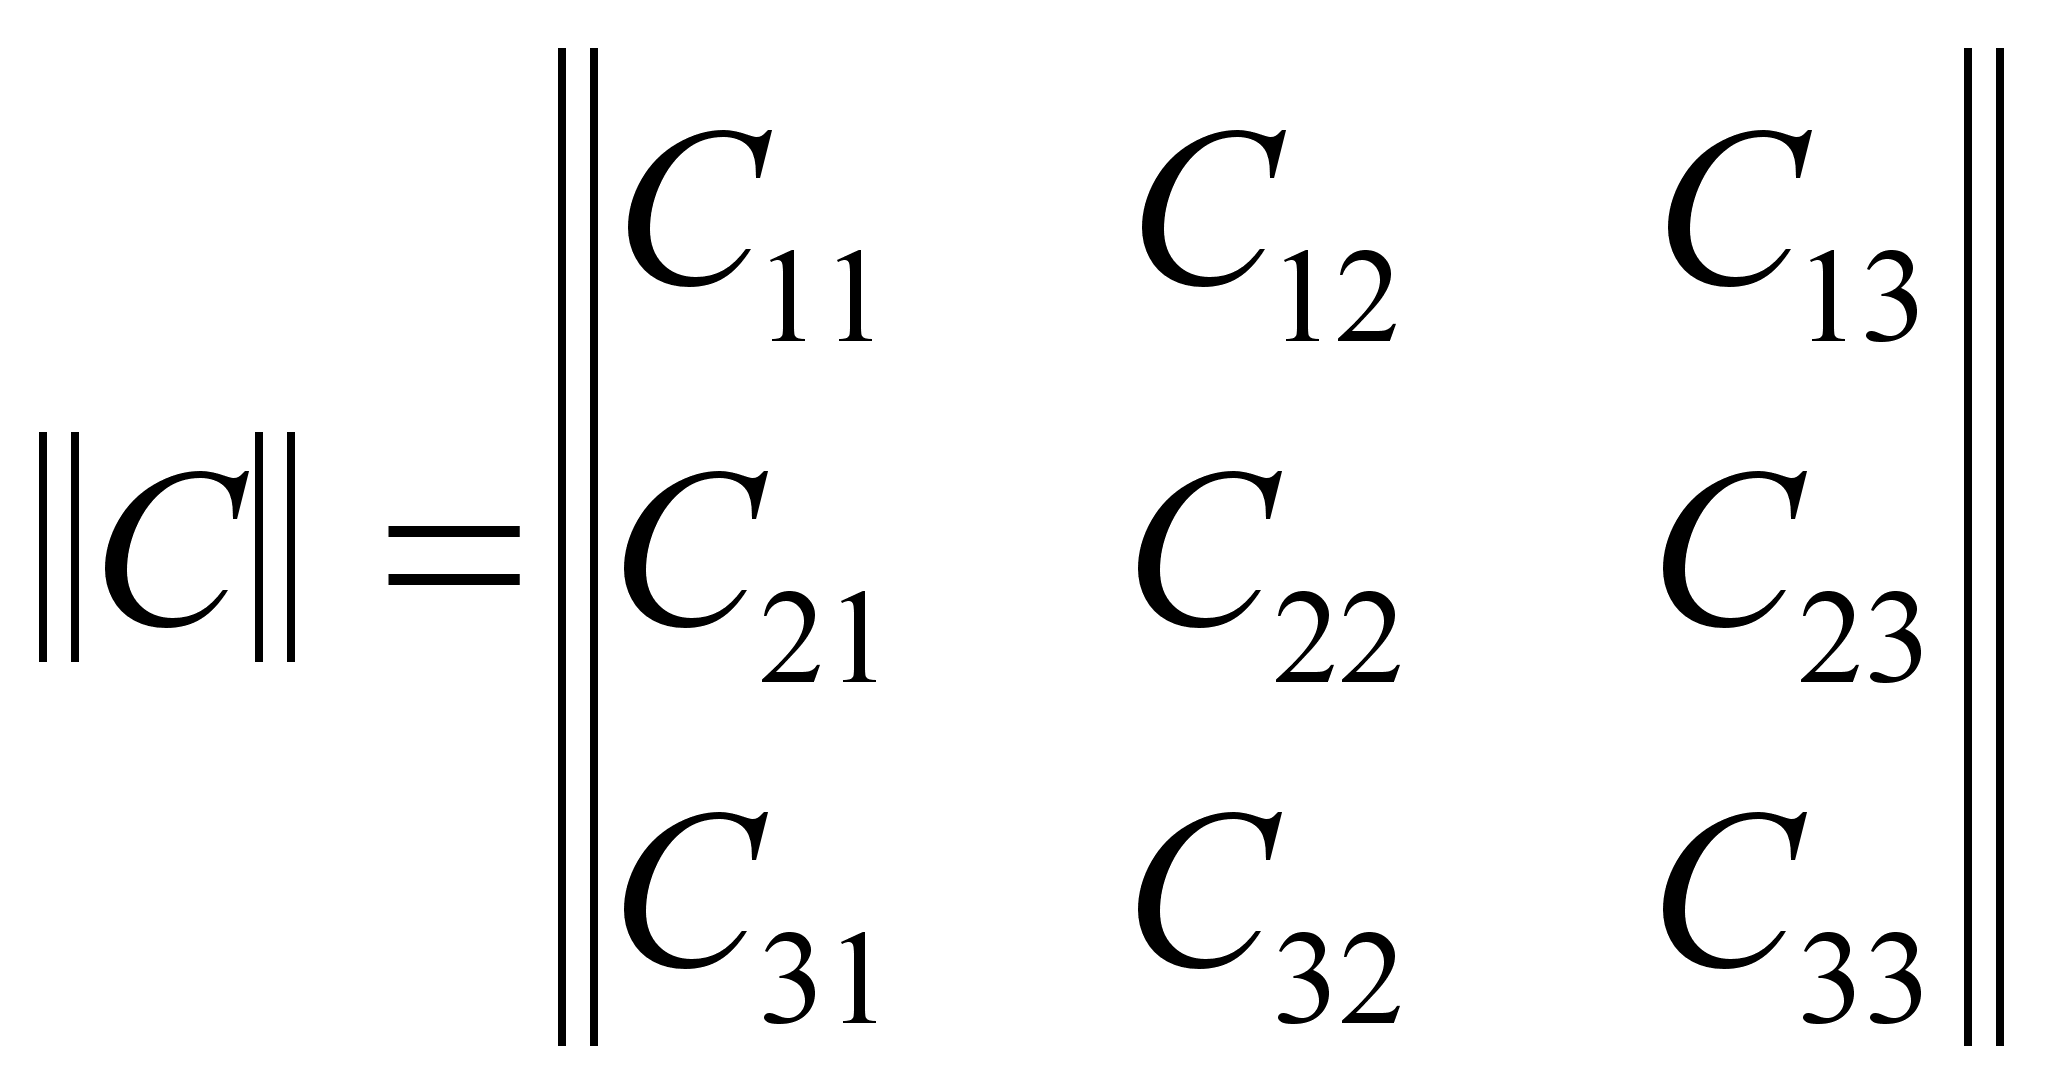
Теперь поймем, что если априорная вероятность отнесения объекта к i-му классу, в то время как он принадлежит к j-му классу (то есть, априорная вероятность ошибки) равна
P(Wi /Wj ),
то среднее значение платы за ошибочную классификацию всех m объектов в системе распознавания определяется как условное МОЖ потерь (зависимость от Wj
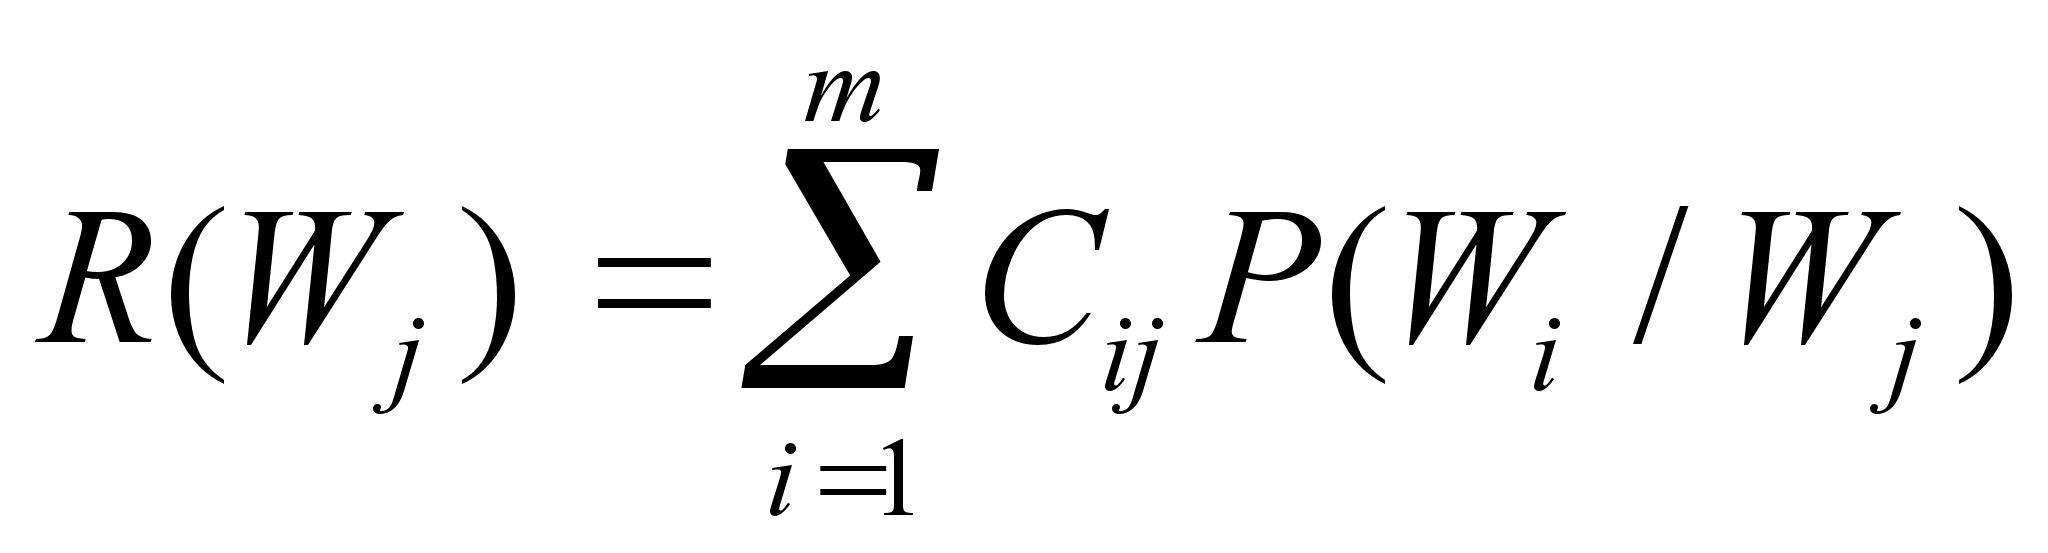
В целом средние потери классификации (то есть, потери по всем классам) определяются как среднее
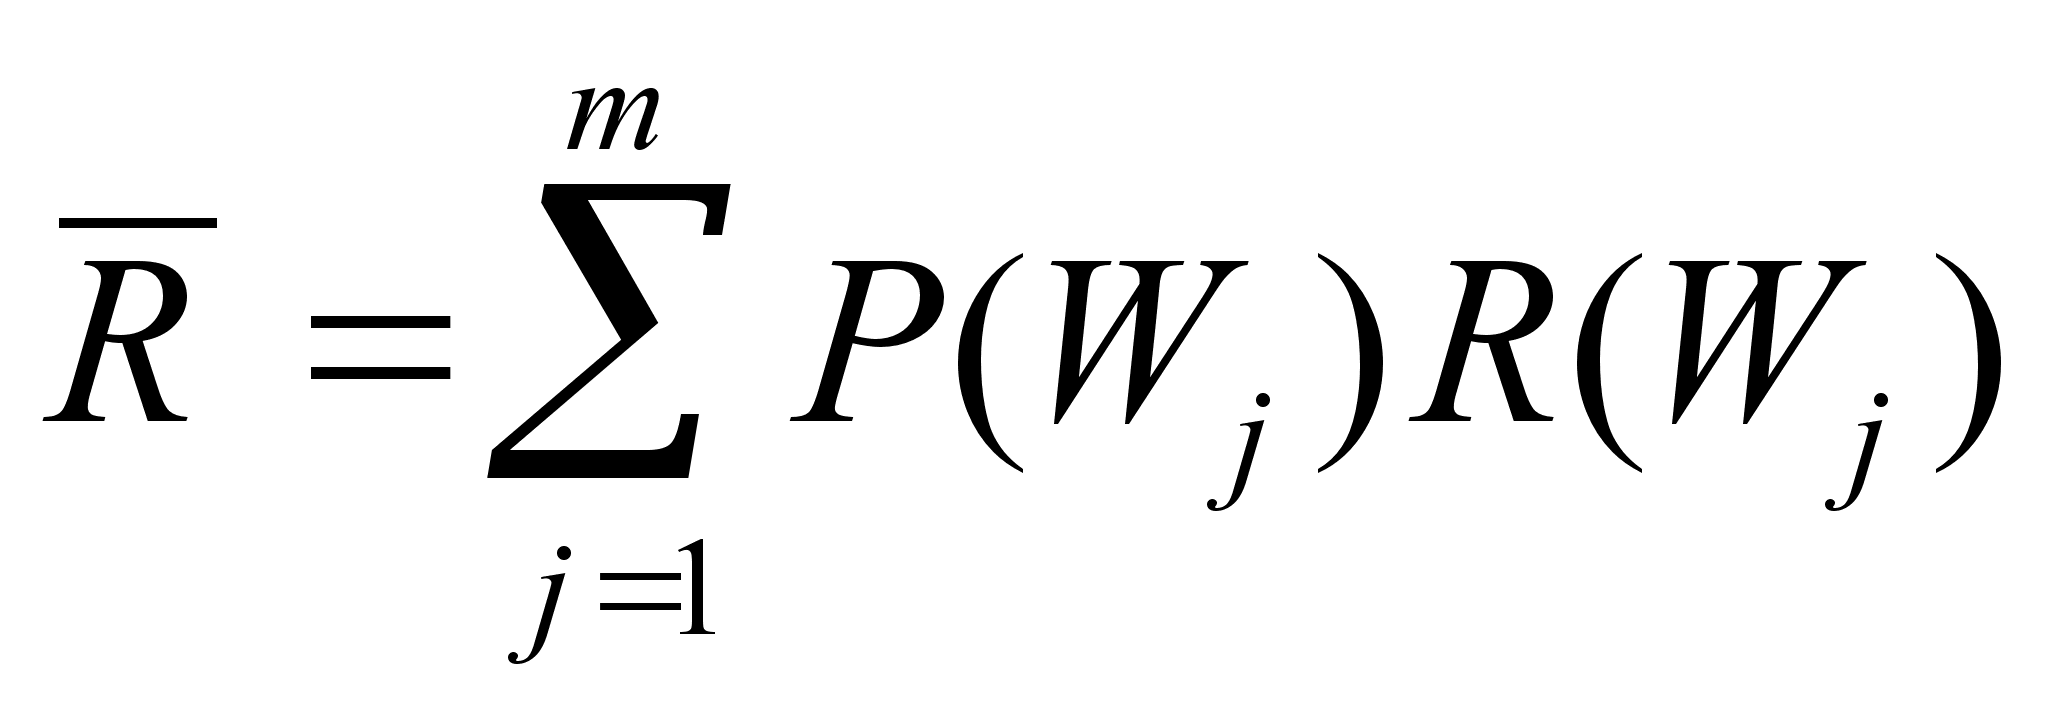
Остается определить вероятность P(Wi /Wj ), так как априорное описание классов напрямую не дает ее значений.
Изобразим
ситуацию
классификации
в рассматриваемом
нами примере
в виде функций
ПРВ параметра
распознавания
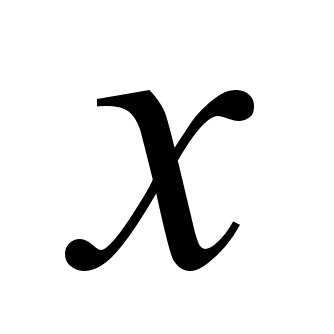 для трех классов
(Рис 4.1.1)
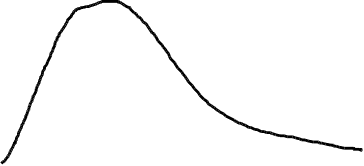
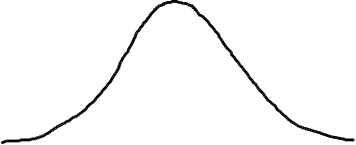
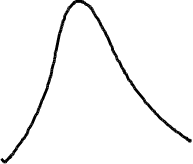
 f(x/Wi)

 f(x/W1)
f(x/W2)
f(x/W3)

a b X
Рис. 4.1.1
Если теперь определить области возможного разброса параметра распознавания каждого класса как Gi ,то легко определить записанную нами вероятность ошибки так
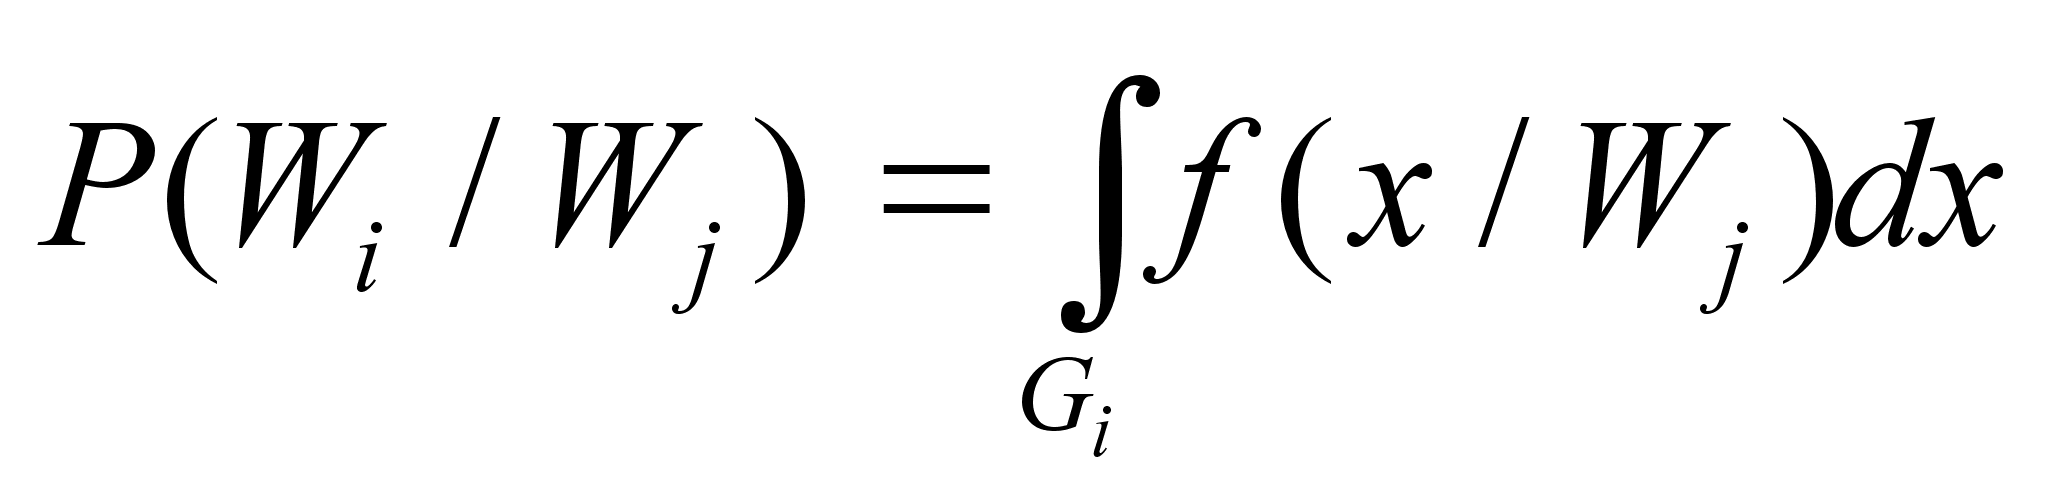
Обозначим указанные области Gi на рисунке. Здесь эти области в силу одномерности случая должны представлять собой отрезки. Поэтому достаточно указать границы
а - граница между 1-ым и 2-ым классами;
b - граница между 2-ым и 3-им классами
Соответственно отрезки:
1-го класса ]- Ґ +a];
2-го класса ]+a +b];
3-го класса ]+b + Ґ[ .
Теперь можно записать в соответствии с приведенной формулой условные риски ошибочных решений
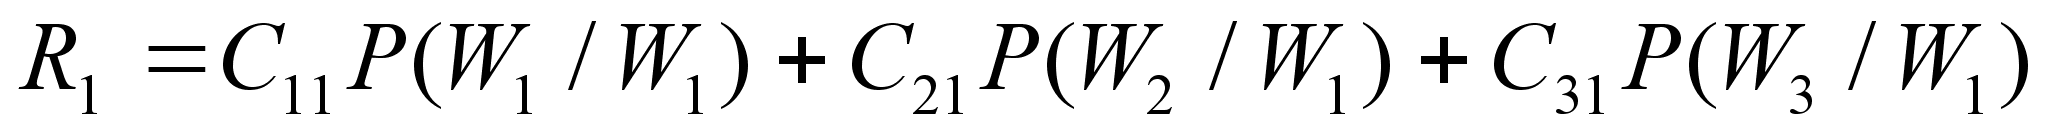
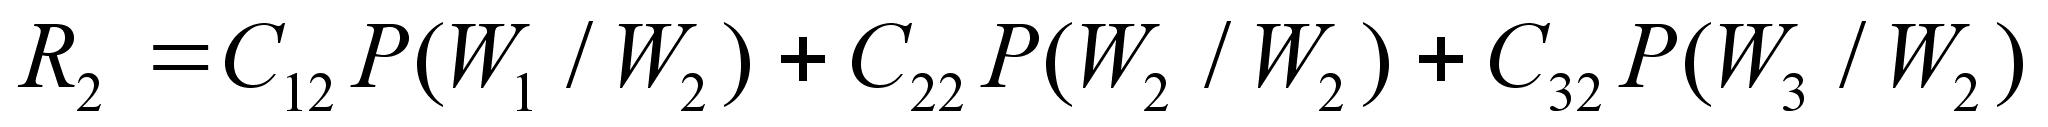
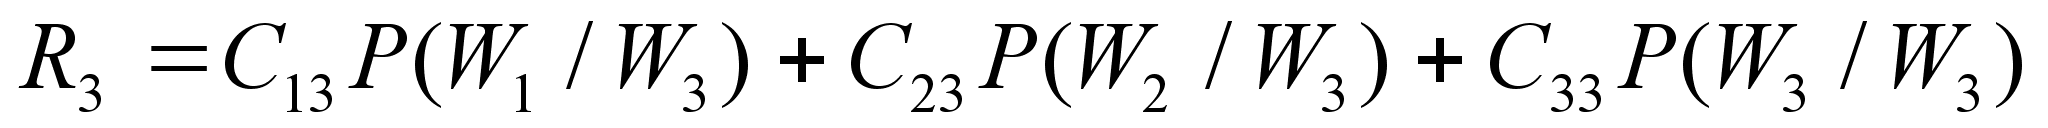
Отсюда средний риск ошибочных решений в системе распознавания (то есть, риск ошибочной классификации всех классов):
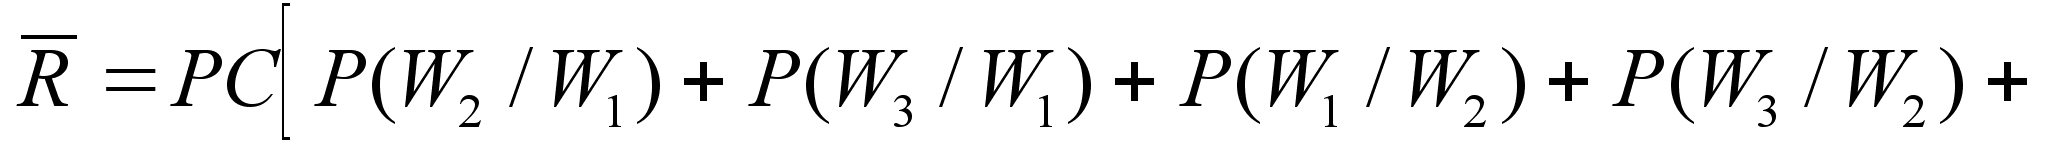
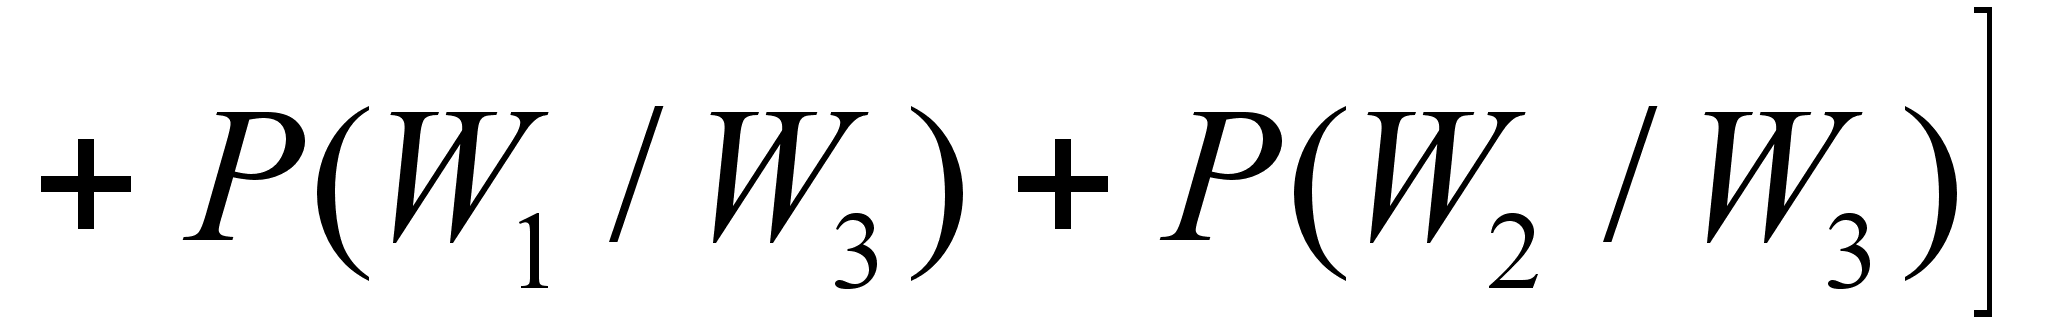
Для простоты рассмотрения принимаем Сii = 0, Cij = C, Pi = P и, пользуясь рисунком, получим
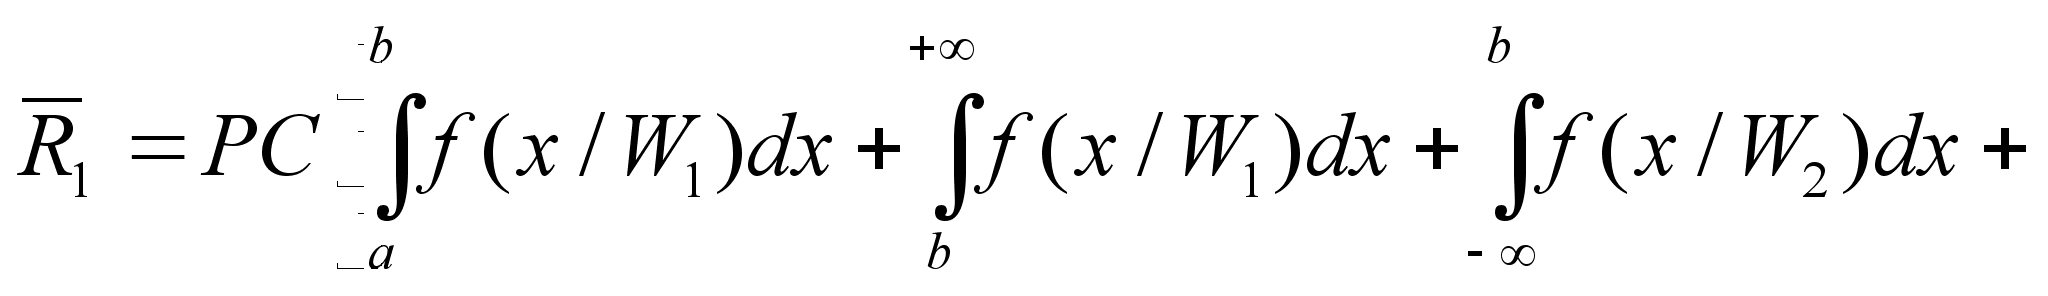
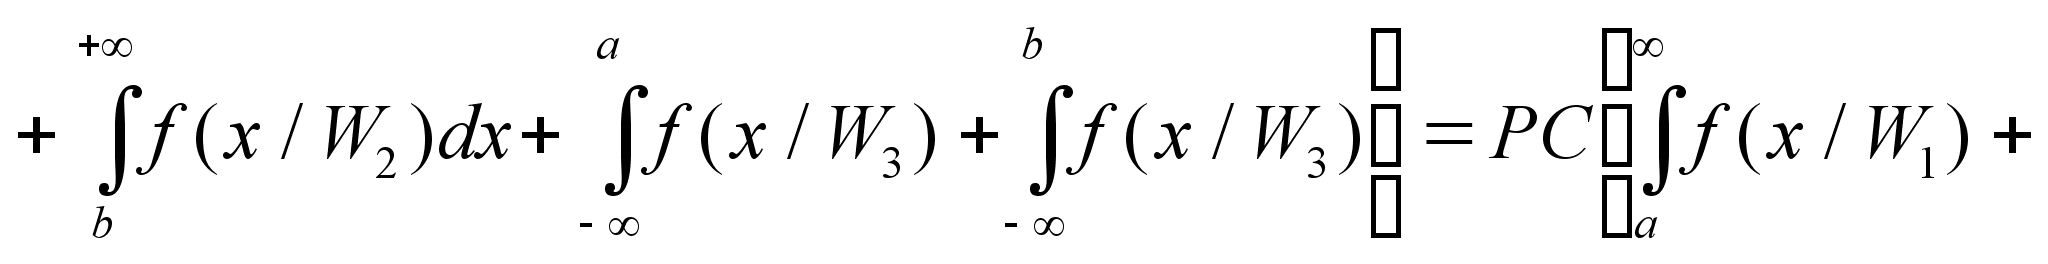
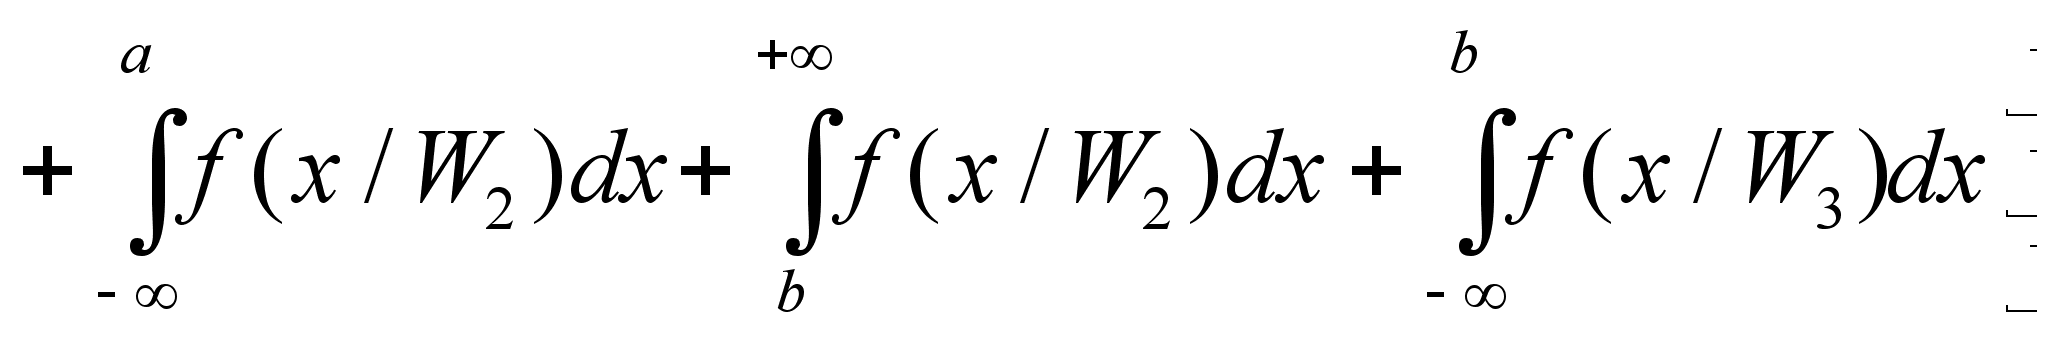
Здесь обозначен средний риск индексом "1", так как теперь рассмотрим вторую ситуацию, для которой постараемся уменьшить число классов, объединяя первый и второй классы в один - четвертый.
Определим по правилам теории вероятностей ПРВ четвертого класса по ПРВ первого и второго классов
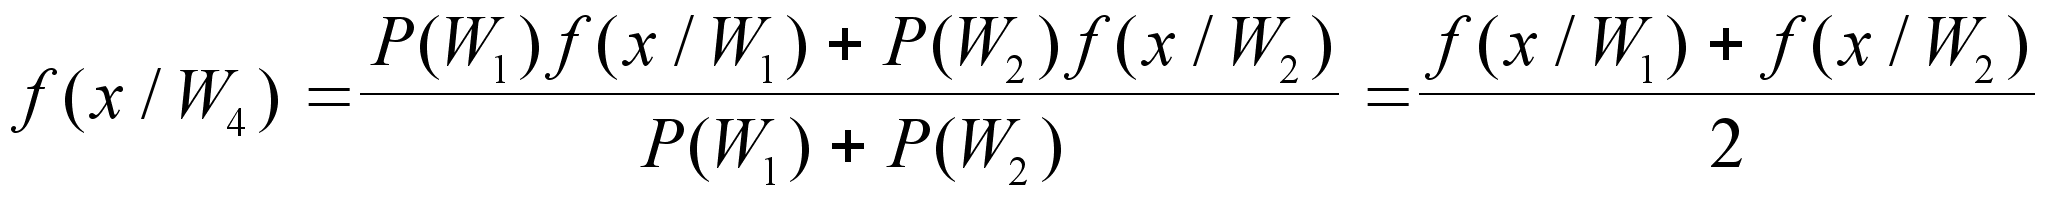
До этого мы упрощали представление вероятностей и плат за ошибки для трех классов. Добавим к этому и четвертый класс
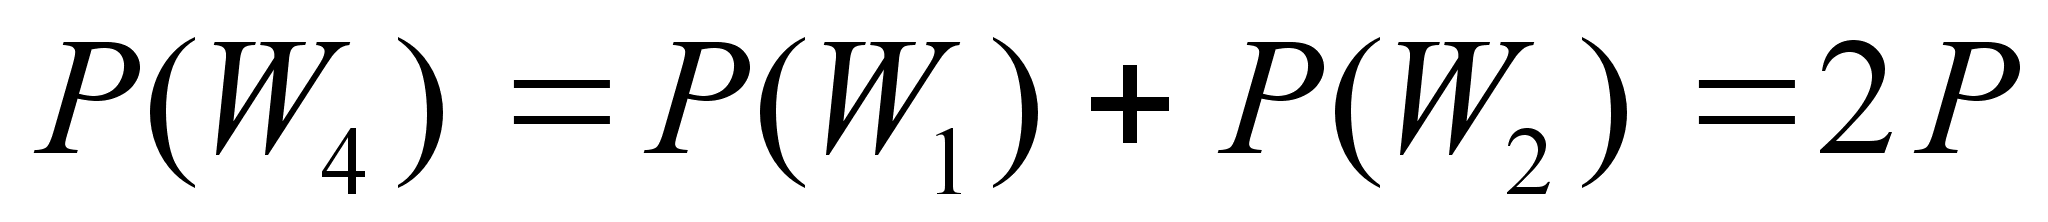
C44=0; C14 =C41 = C.
На рисунке ПРВ классов изобразим ПРВ четвертого класса (пунктир).
Теперь можно записать, как и в первом случае (три класса), условные риски ошибочных решений для оставшихся 3-го и 4-го классов
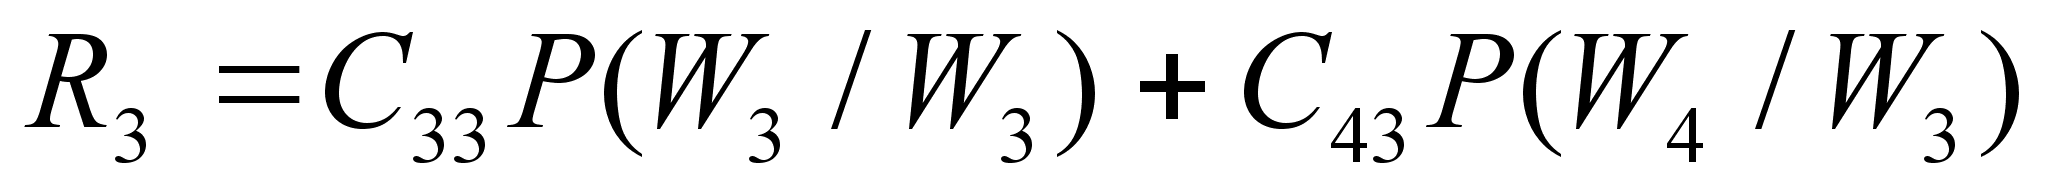
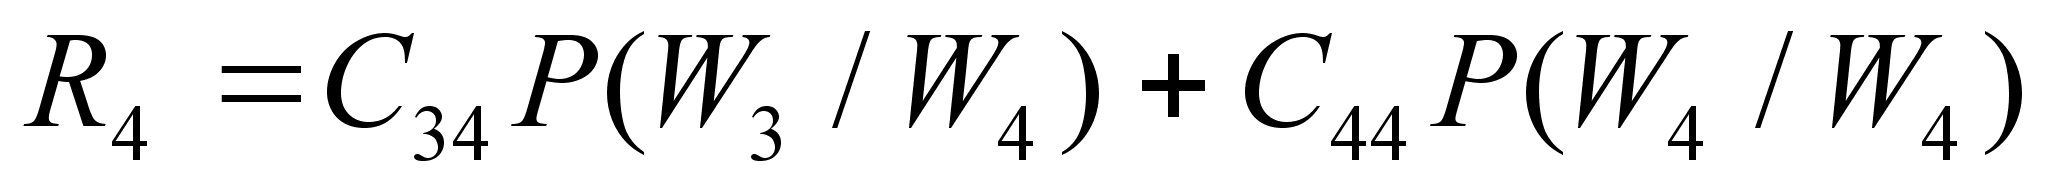
(Условные риски R1 и R2 здесь отсутствуют, так как произошло объединение 1-го и 2-го классов в 4-ый. Кроме того, матрица плат за ошибки с учетом четвертого класса приняла сначала следующий вид
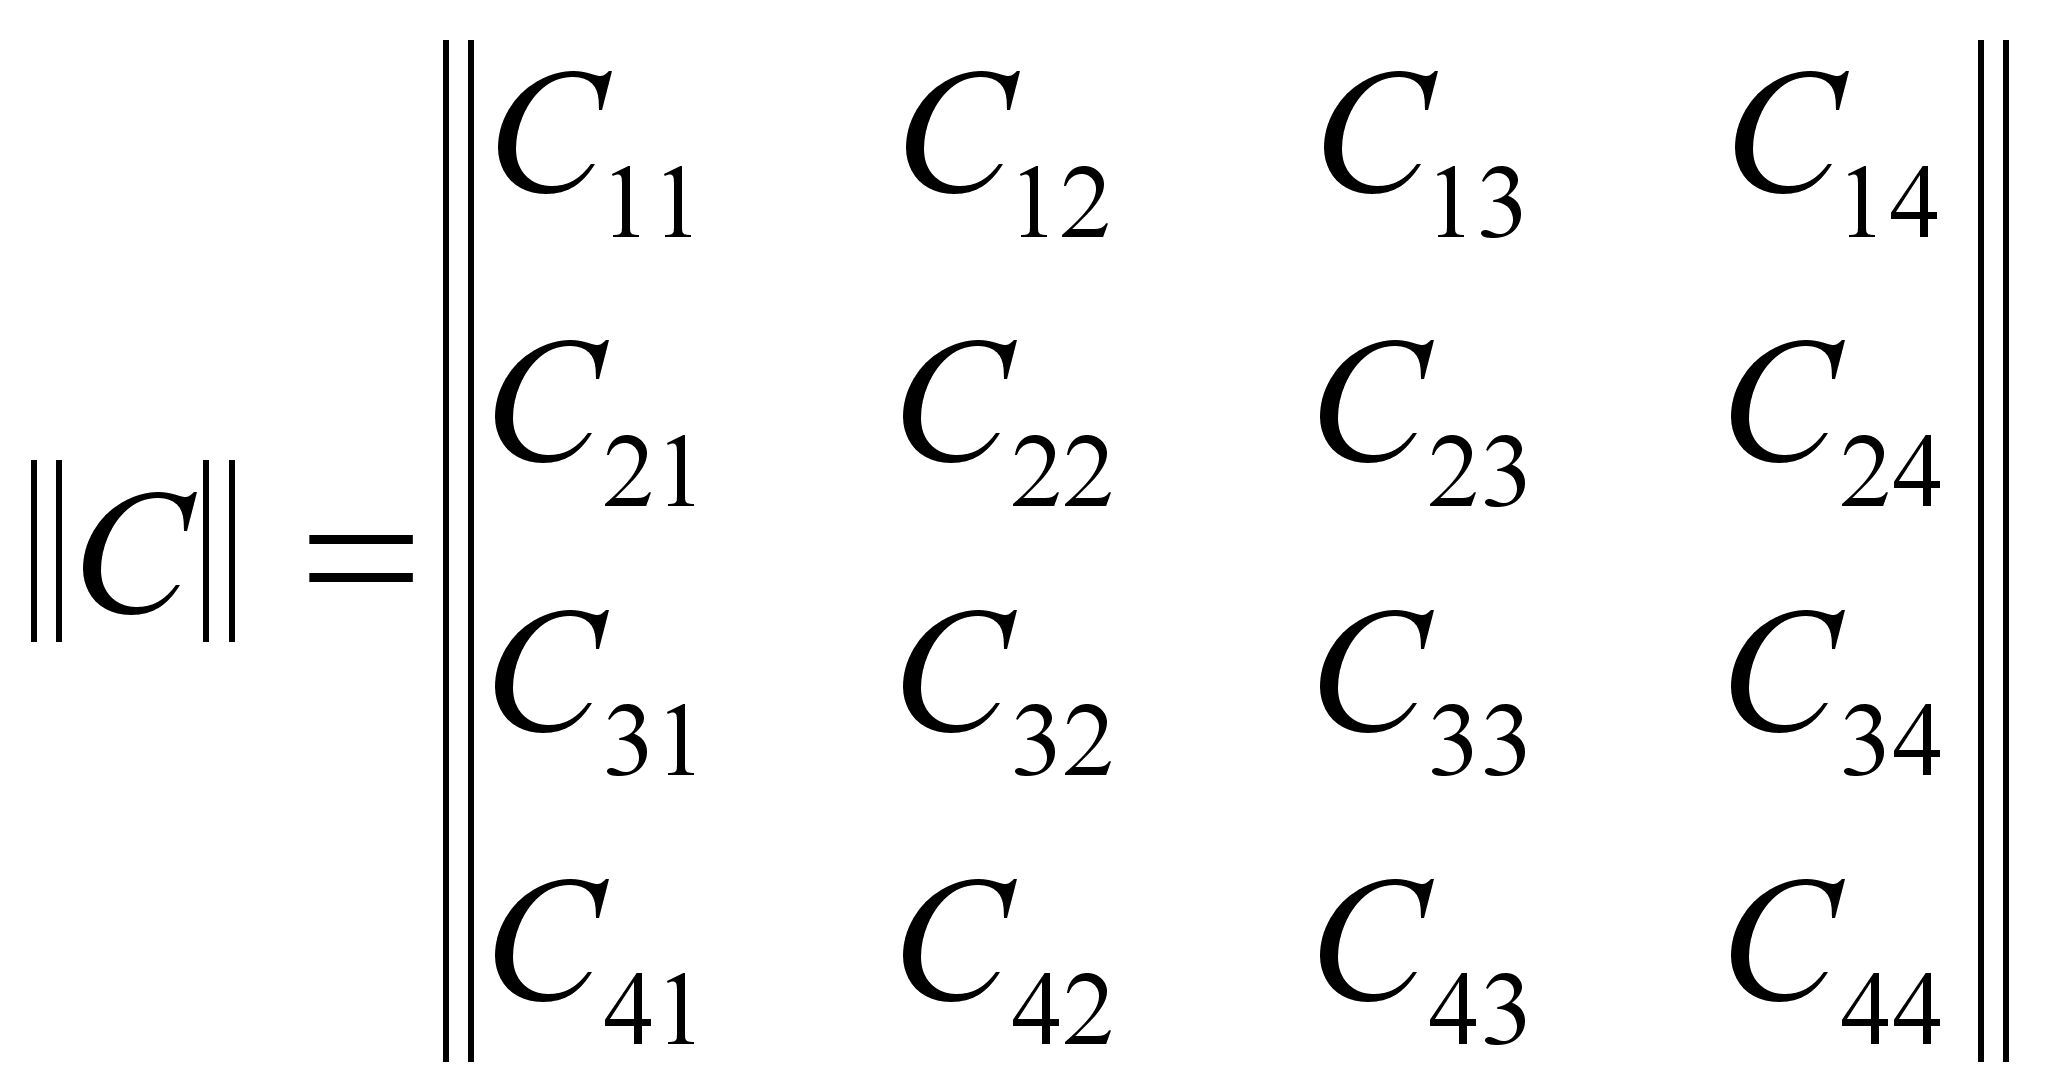
а затем из нее за счет того же объединения исключили столбцы и строки, имевшие индексы "1" и "2". В результате получили:
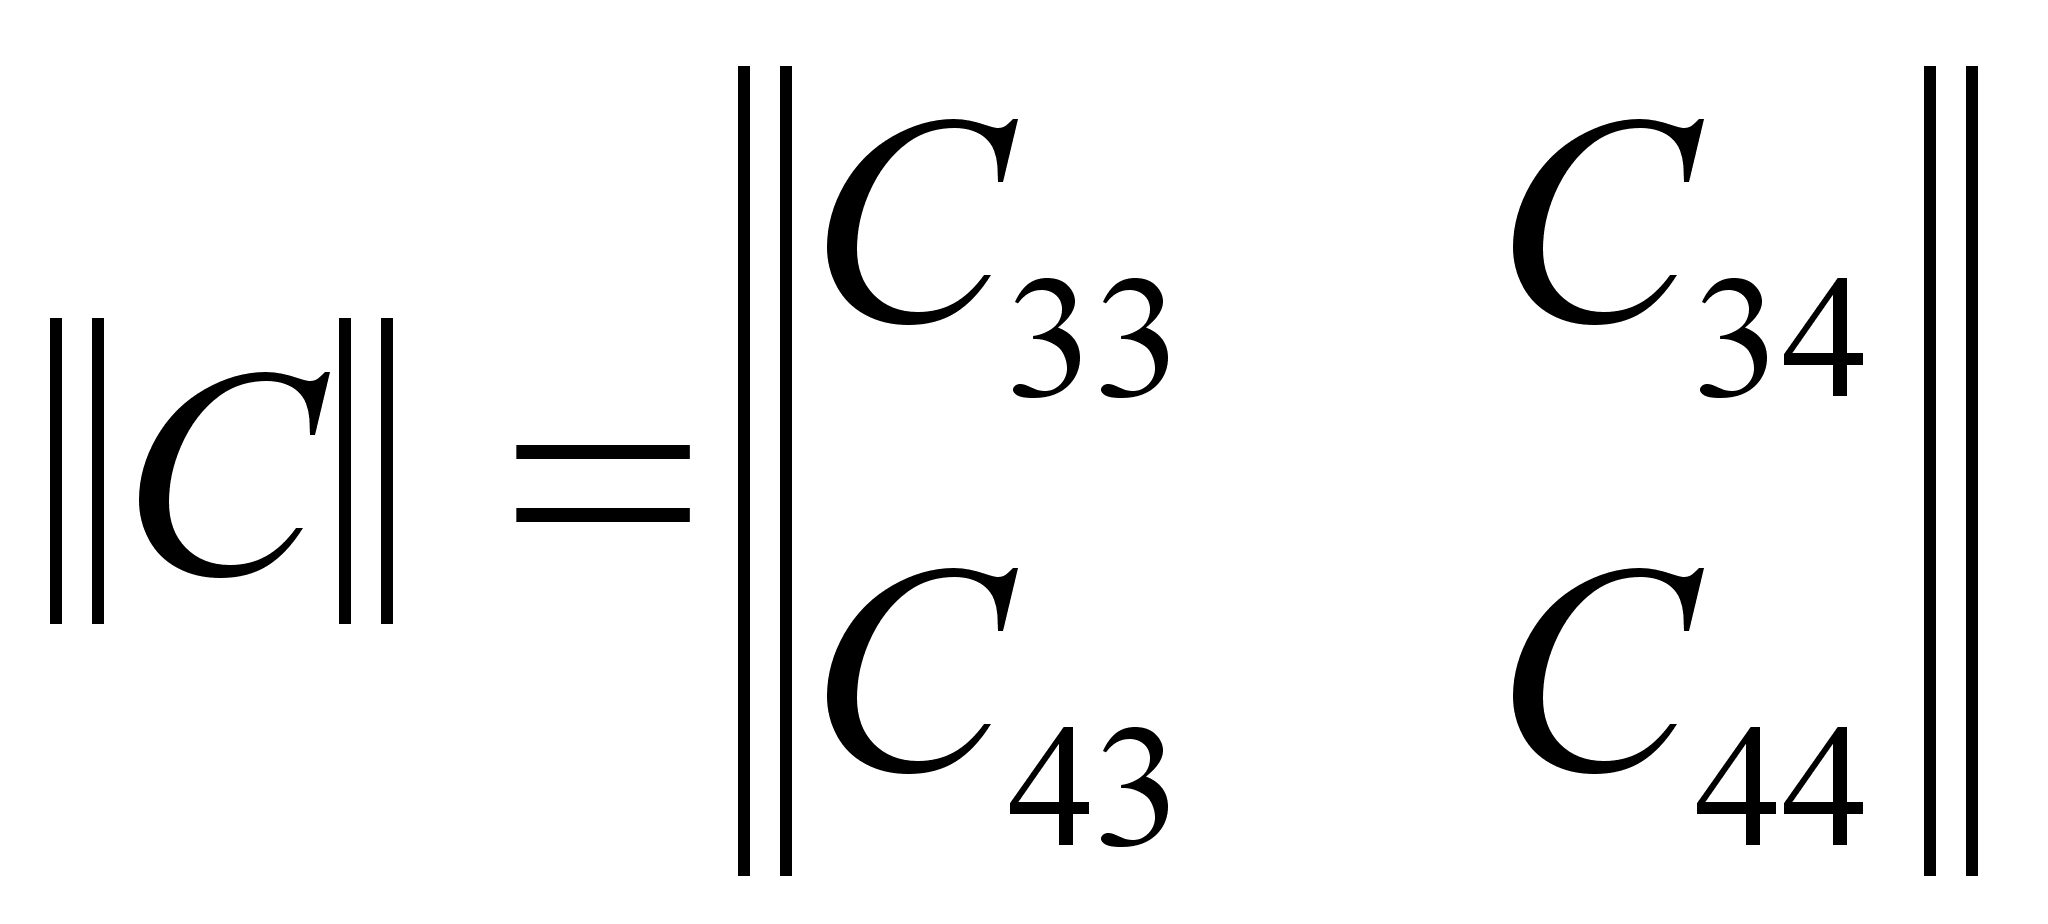
Средний риск для случая двух оставшихся классов W3 и W4 обозначим индексом "2" и также, как для первого случая, после простых преобразований получим
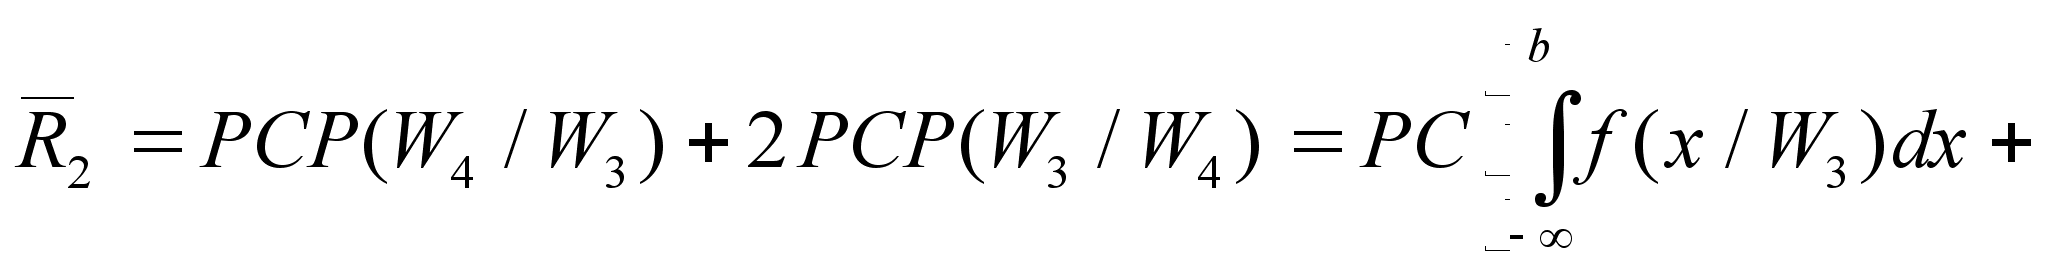
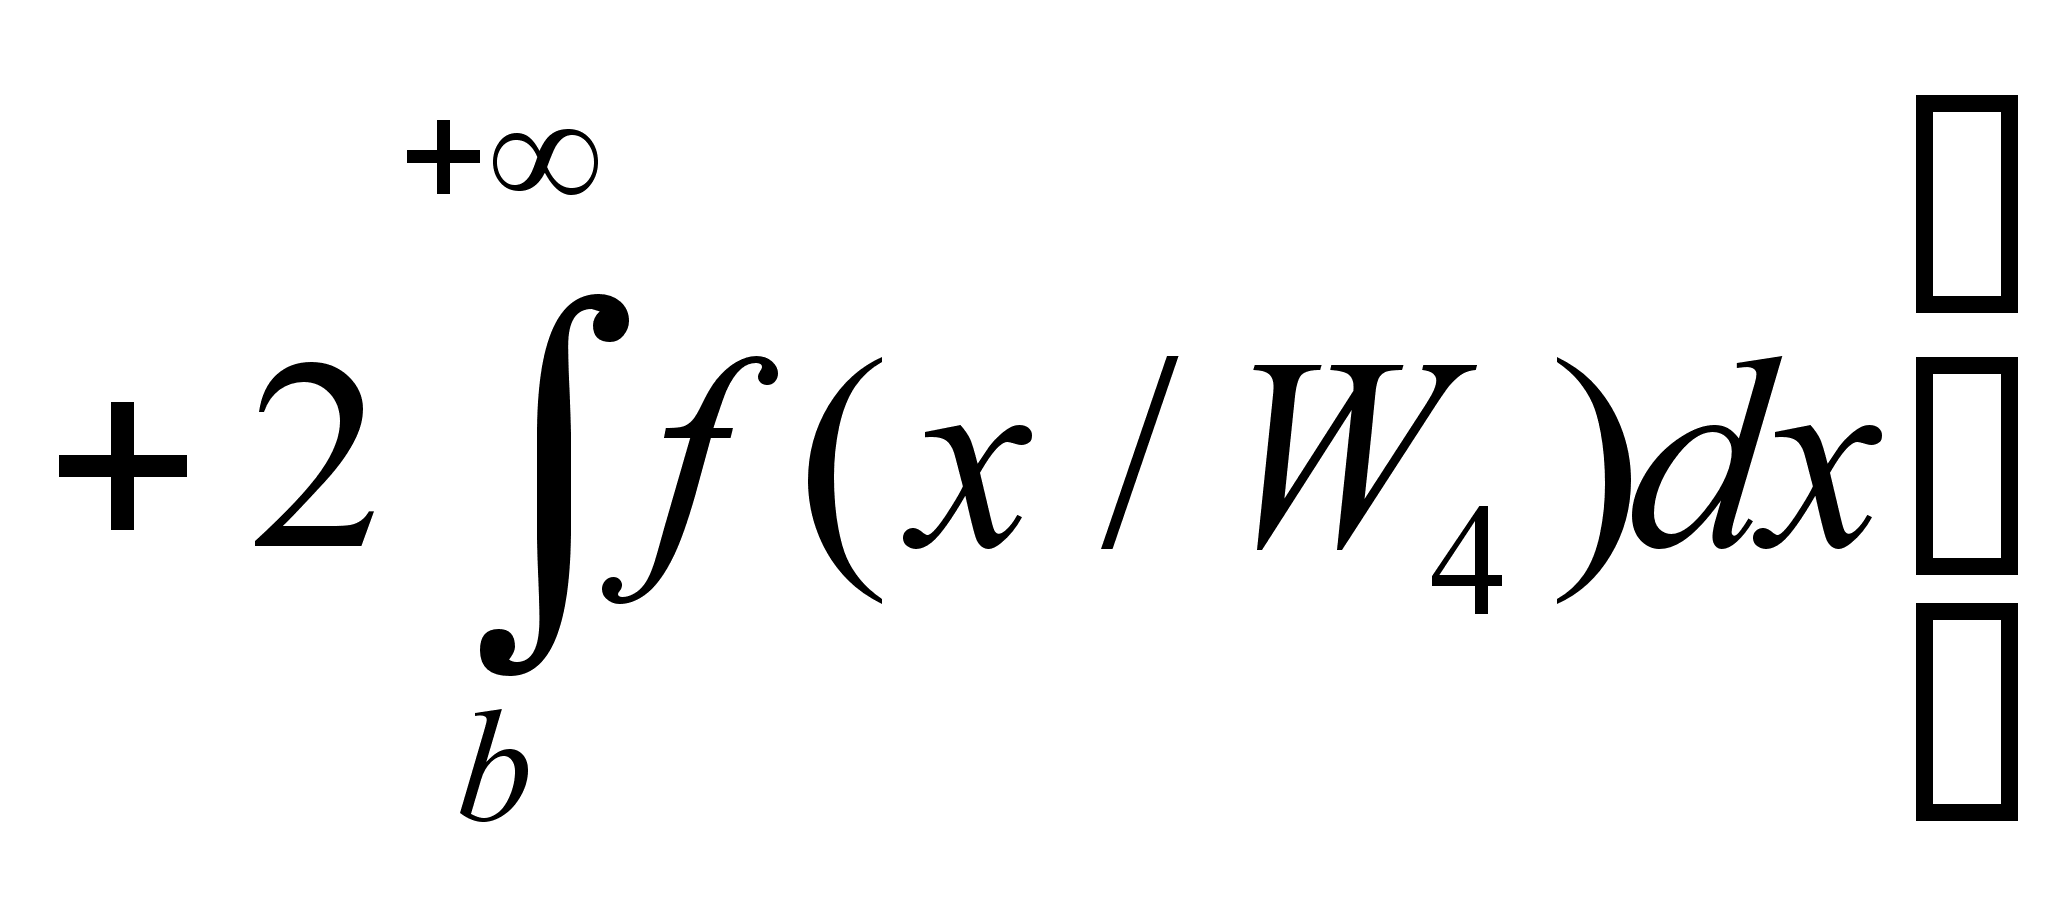 .
Теперь, если подставим сюда вместо ПРВ f(x/W4) его выражение, определенное уже нами, то получим
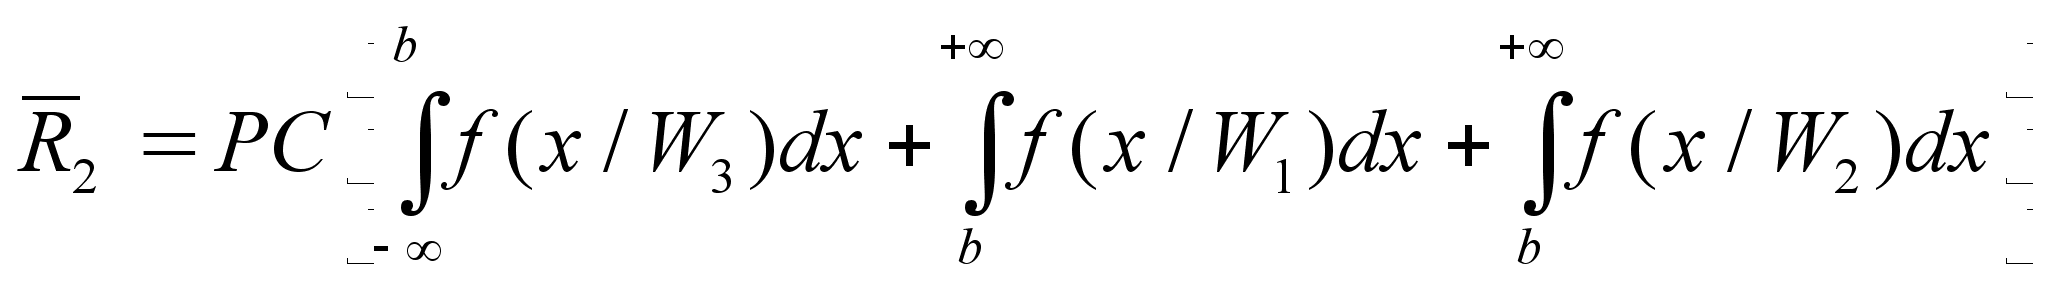
Наконец мы можем сравнить средний риск R1 и R2
__ __
R1 > R2
Вывод:
При заданном признаковом пространстве и прочих равных условиях уменьшение числа классов приводит к меньшению ошибок распознавания.
Следствие:
При увеличении числа классов для уменьшения среднего риска (через уменьшение вероятности ошибочных решений) необходимо включать в состав словаря признаков такие, которые имеют меньший разброс.
Действительно, для рассмотренного нами одномерного случая по приведенному рисунку можно проследить, что вероятности ошибочных решений снижаются, если распределения имеют меньший разброс. То есть, при этом опять-таки уменьшается риск ошибочных решений в системе и тем самым достигается большая эффективность, но теперь уже без уменьшения числа классов.
Л е к ц и я 4.2
Оптимизация алфавита классов и словаря признаков
(продолжение)
4.2.1. Взаимосвязь размерности вектора признаков и эффективности СР
Из предположений, возникающих в связи с приведенным следствием изучения вопроса уменьшения числа классов, можно заключить, что увеличение числа признаков должно приводить к повышению эффективности СР, так как рано или поздно в составе вектора может появиться такой признак, разброс которого минимален. Это качественное утверждение является достаточно важным в построении систем распознавания и поэтому требует строгого доказательства.
Итак, докажем, что с увеличением числа признаков вероятность правильного распознавания неизвестных объектов также увеличивается.
Рассмотрим такое доказательство, допуская, что
- для каждого k-го признака распознавания существует некоторая вероятность такого события Ak, когда решение о принадлежности объектов к Wi классу принимается однозначно.
-признаки распознавания независимы между собой.
Независимость признаков означает и независимость событий Ak (событий принятия однозначных решений о принадлежности).
Обратимся к теории вероятностей. Вероятность наступления двух совместных или несовместных событий A1 и A2
P (A1 + A2 ) = P (A1 ) + P (A2 ) - P (A1 A2 )
Отсюда для трех событий получим
P (A1 + A2 + A3 ) = P [A1+ (A2 + A3 )] = P (A1 ) + P (A2 + A3 ) - P [A1 (A2 + A3 )] = P (A1 ) + P (A2 ) + P (A3 ) - P (A2A3 ) - P (A1A2 + A1A3 ) =
=P (A1 ) + P (A2 ) + P (A3 ) - P (A2 A3 ) -[ P(A1A2 ) + P (A1A3 ) - P (A1A2A3 )]
или
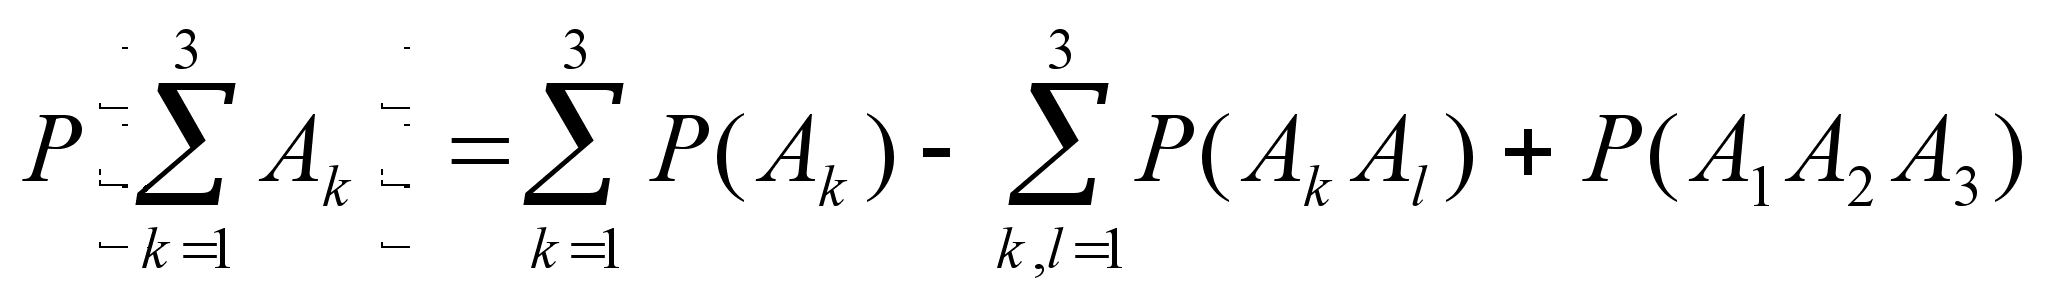
Точно также для четырех событий
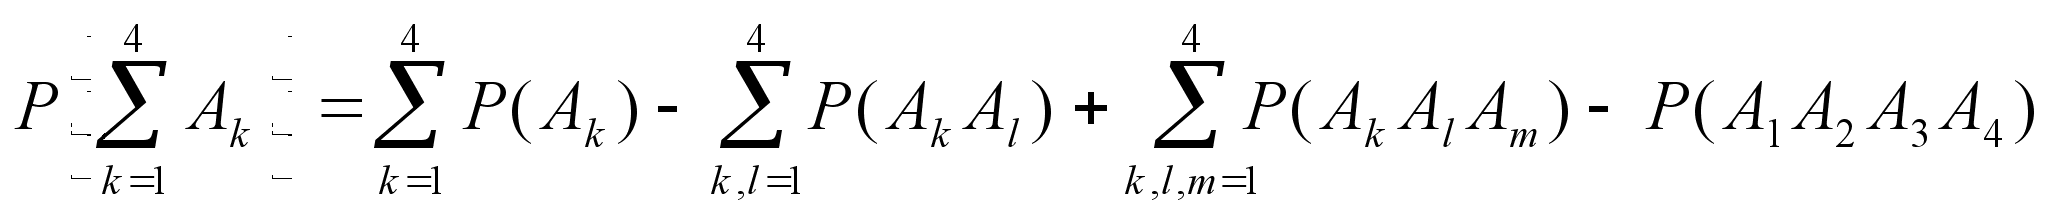
Теперь образуем разность между вероятностями суммы 4-х и 3-х событий, состоящих в рассматриваемом нами случае в принятии однозначного решения о принадлежности по 4-м и 3-м признакам распознавания соответственно:
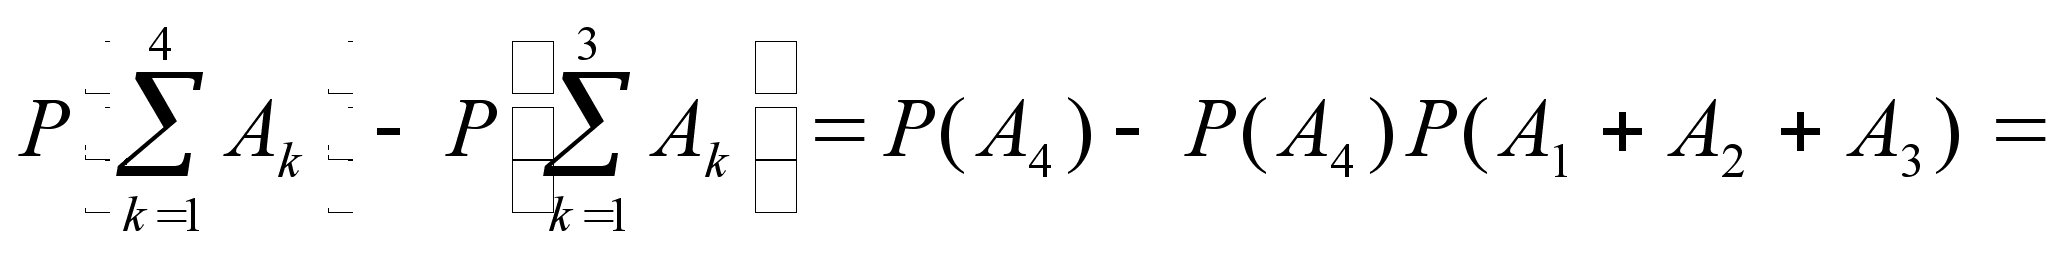
=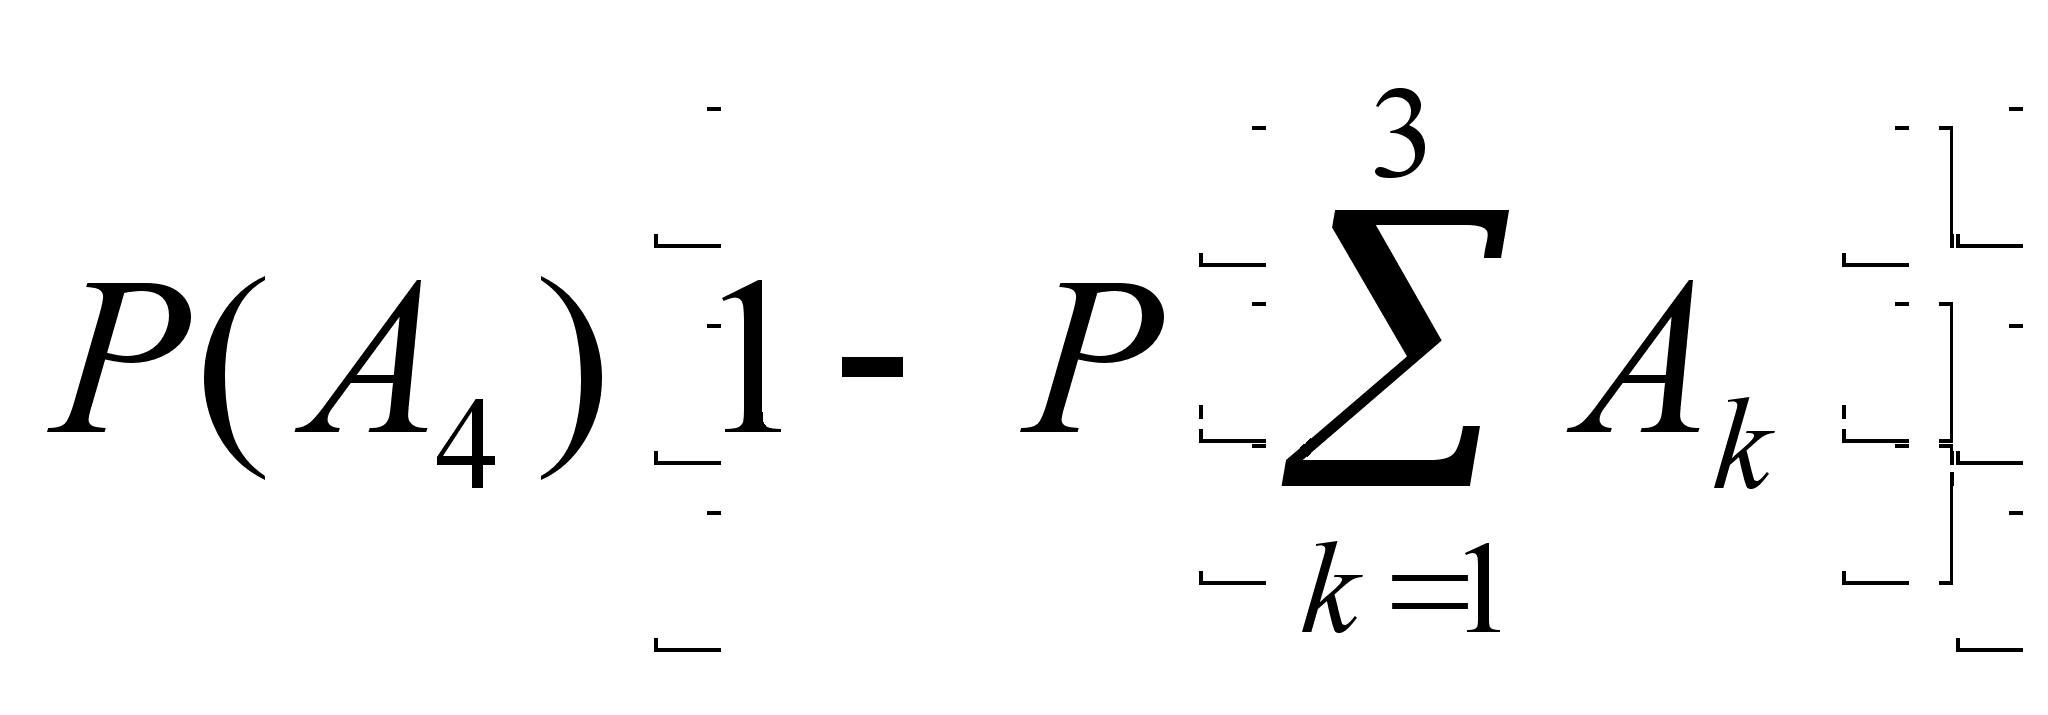
(Наиболее просто эту разность получить, не доводя уменьшаемое до конечного вида
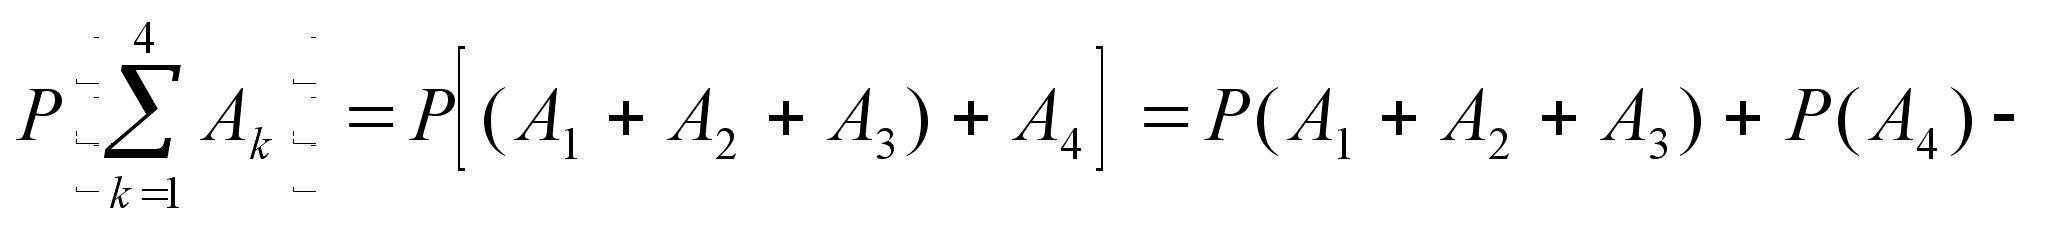
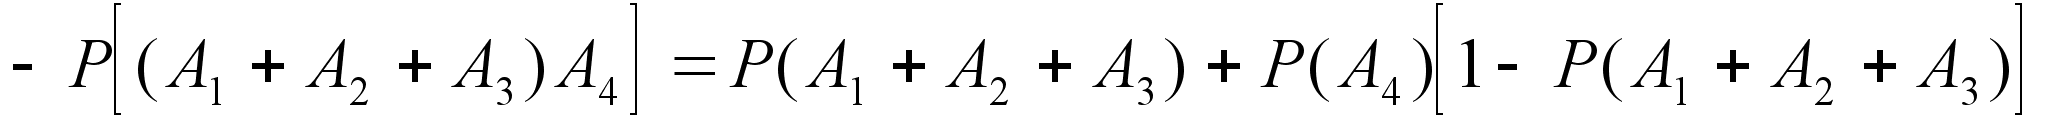
Теперь по индукции можно записать:
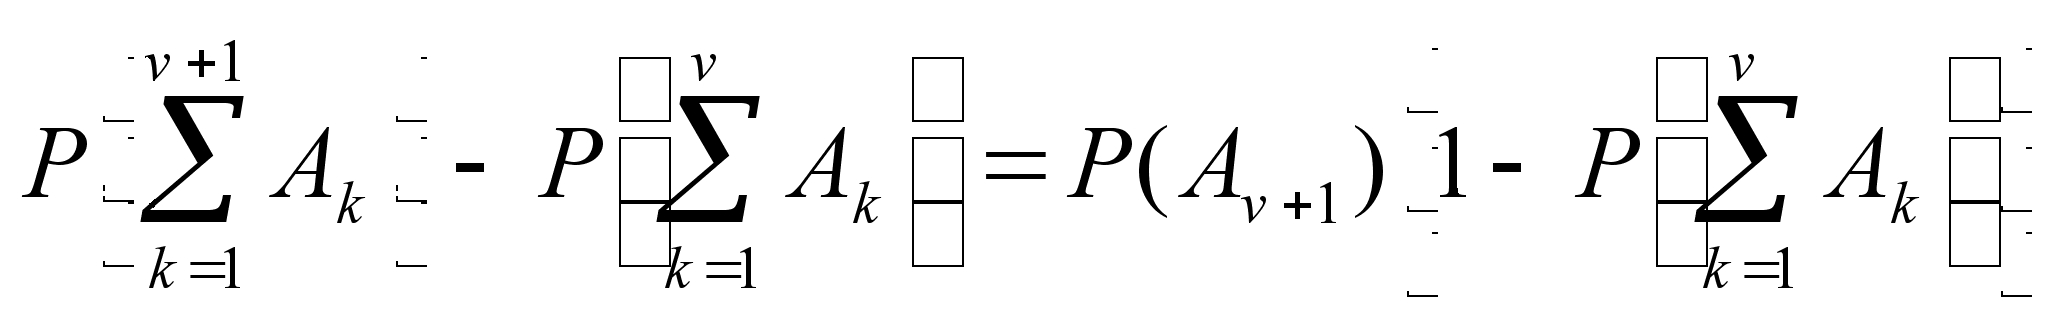
Из приведенного выражения следует, что если не достигнута предельная вероятность правильного распознавания, то есть:
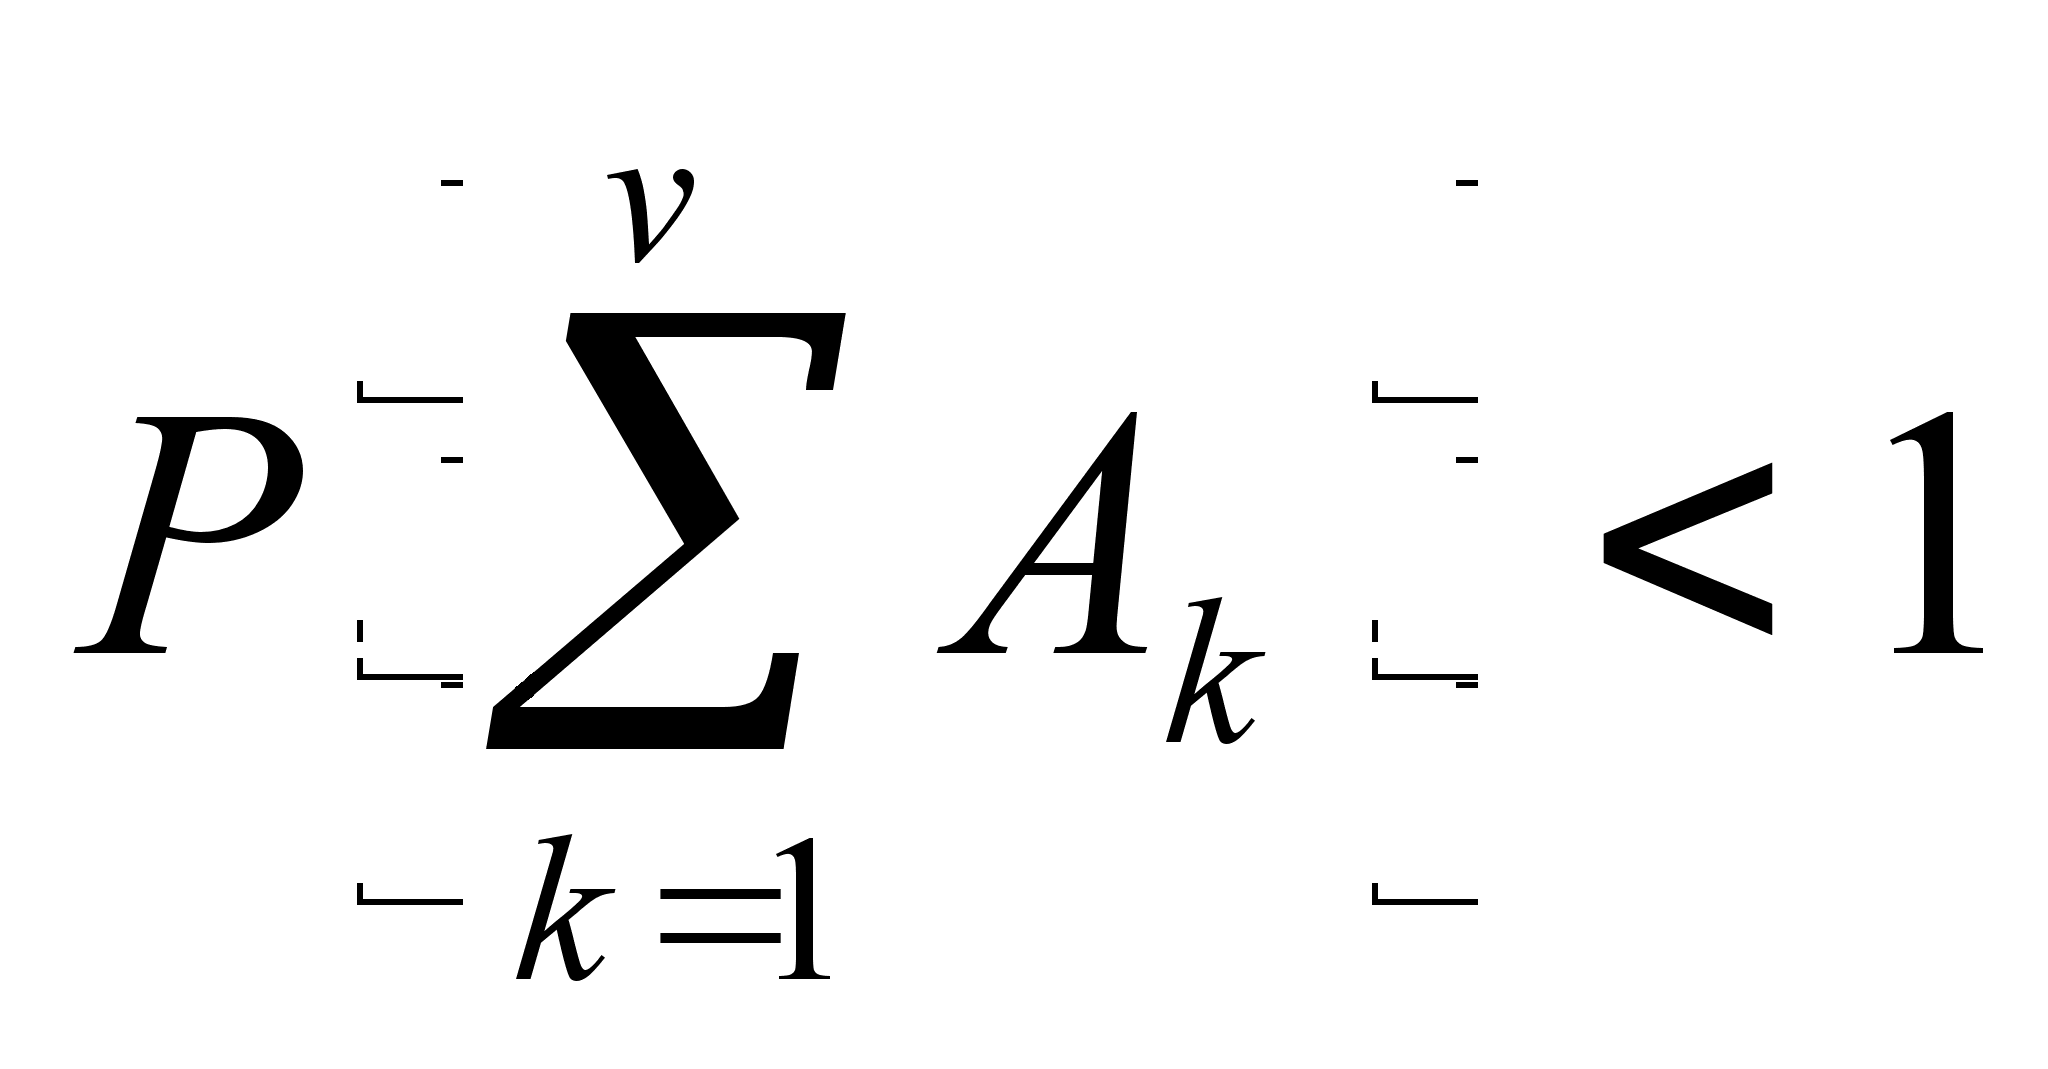
то при любом n имеем
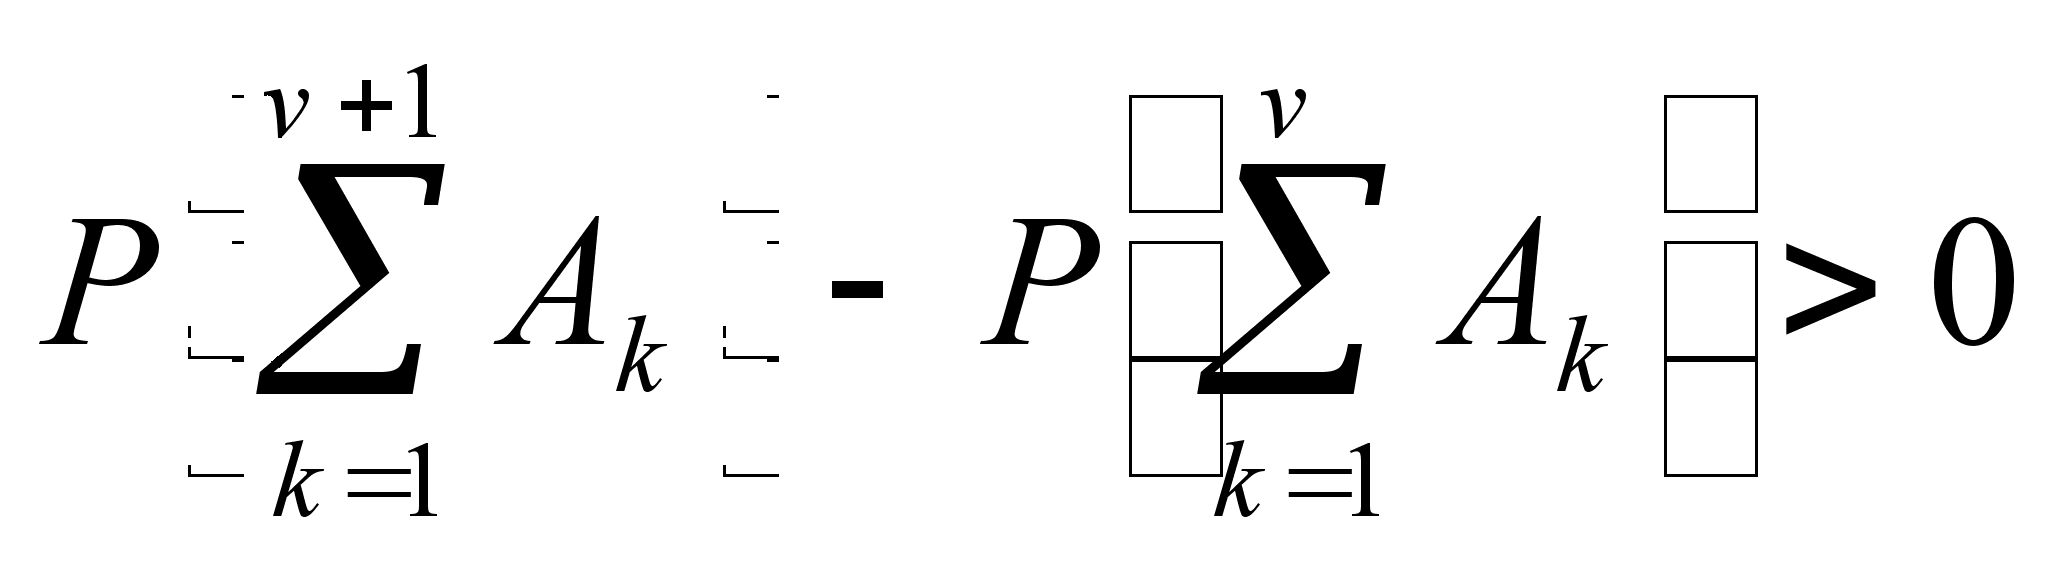
Это является доказательством возрастания вероятности при увеличении числа признаков.
Таким образом, последовательность
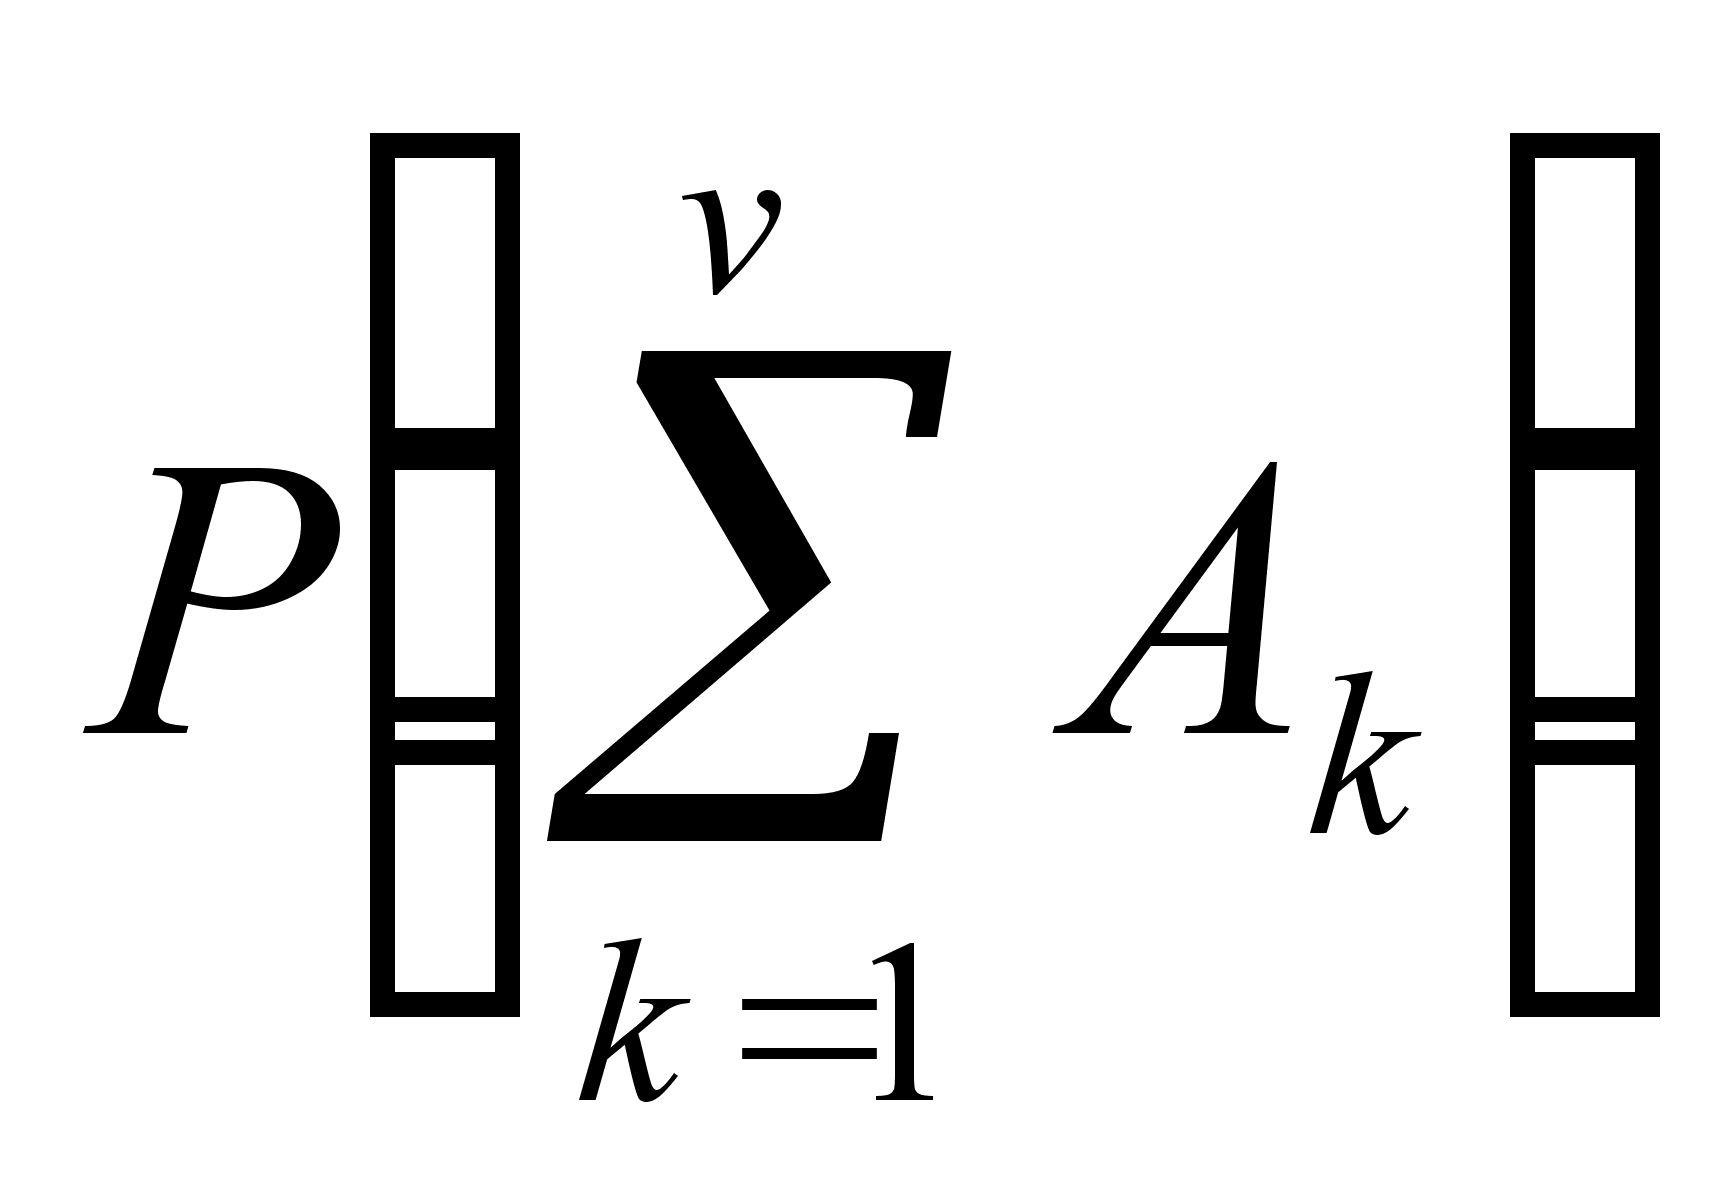
при
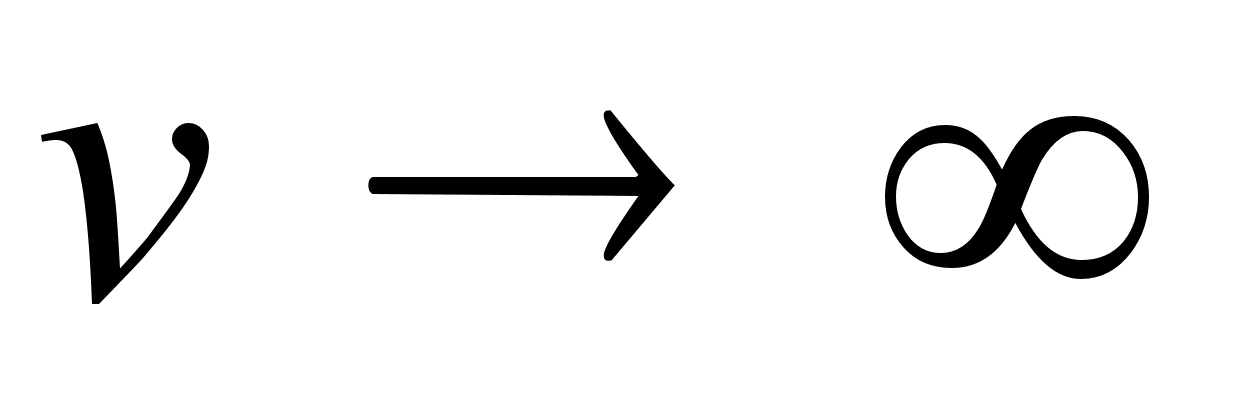 является монотонно
возрастающей,
а значит и
сходящейся,
так как предел
возрастания
-
“1”.
Для сходящейся последовательности
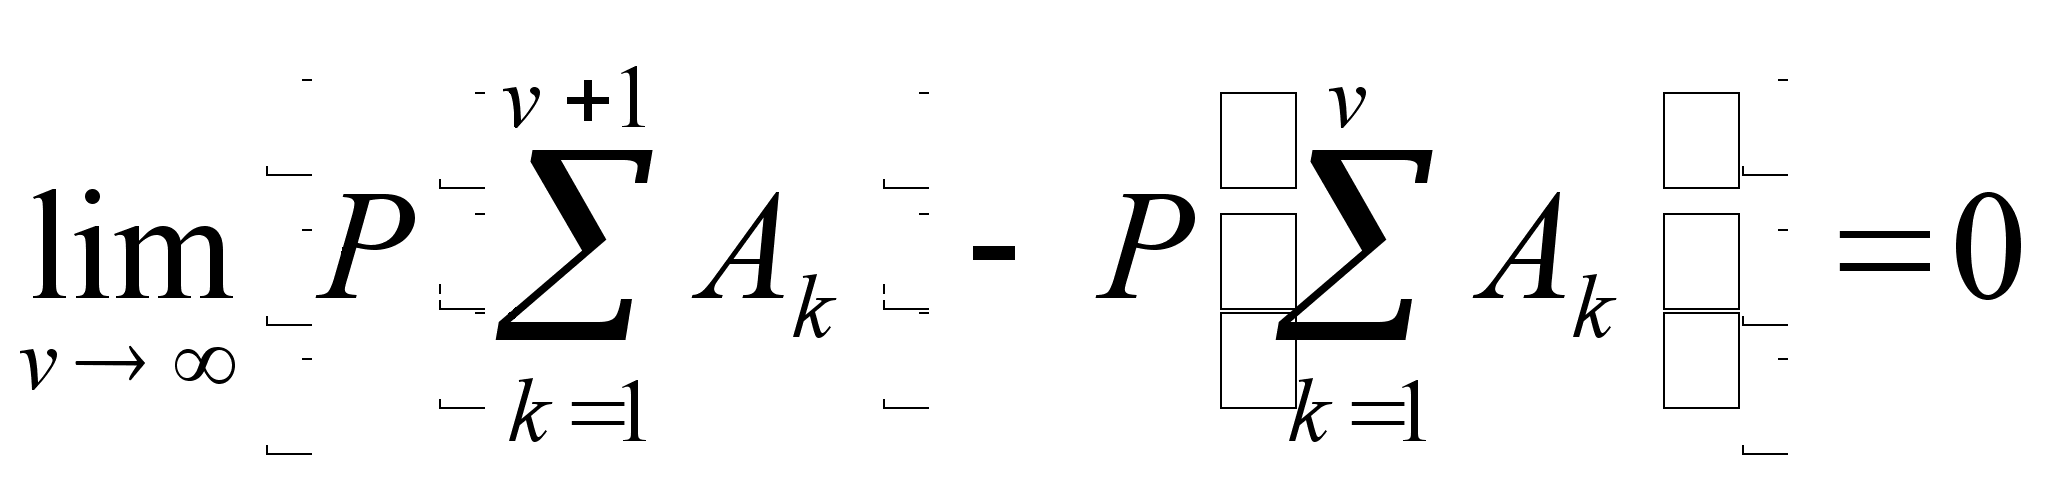
а значит
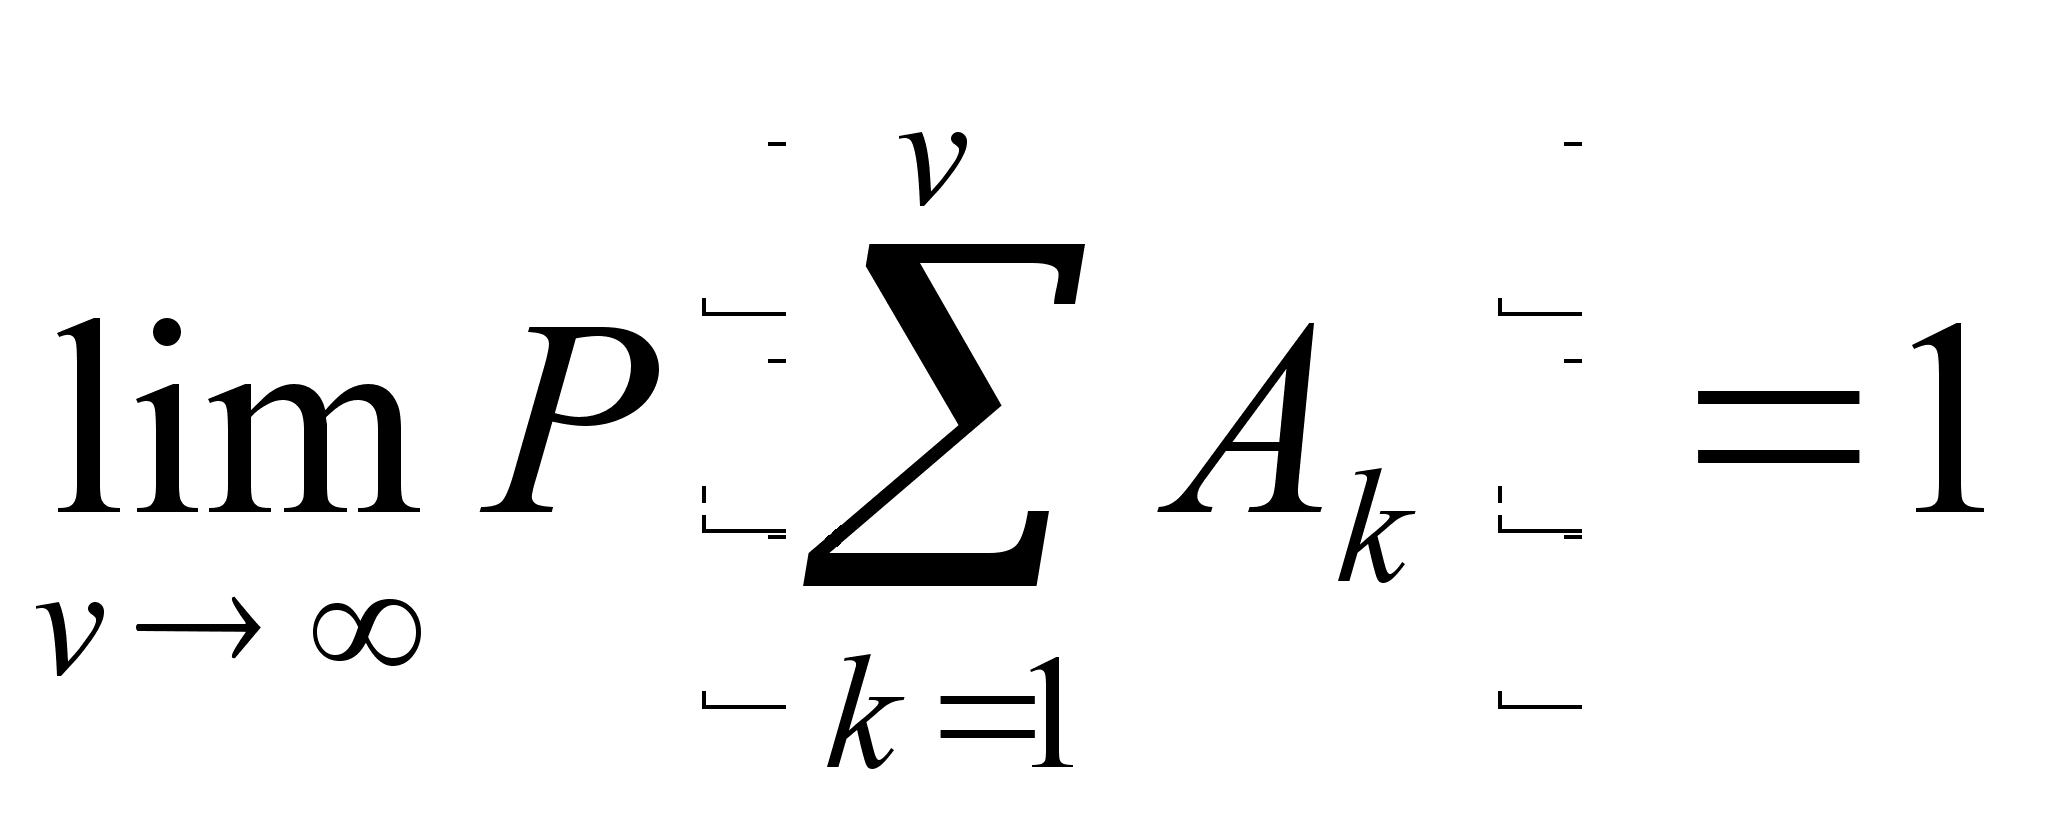
что и требовалось доказать.
Следствие:
Снижение эффективности распознавания за счет увеличения числа классов может быть скомпенсировано увеличением размерности вектора признаков.
Заметим, что мы вели доказательство для независимых признаков. В случае зависимых признаков (коррелированных) надежда на повышение эффективности основывается на наличии связей, приводящих к лучшей разделимости классов (Это можно показать на примере двумерного пространства признаков, которому соответствуют неперекрывающиеся эллипсы рассеяния).
4.2.2.Формализация задачи оптимального взаимосвязанного выбора алфавита классов и словаря признаков
Решая задачу повышения эффективности СР за счет увеличения размерности вектора признаков, мы не обращали внимания на то, что указанное увеличение - это часто возрастание числа технических средств измерений, каждое из которых обеспечивает определение одного или группы признаков. Значит при этом растут расходы на построение СР. А ресурсы часто ограничены.
Поэтому в условиях ограниченных ресурсов на создание СР только некоторый компромисс между размерами алфавита классов и объемом рабочего словаря признаков обеспечивает решение задачи оптимальным образом. Для обеспечения этого компромисса требуется предварительная формализация задачи. Начнем с общей формулировки задачи.
4.2.2.1. Формализация исходных данных
Пусть задано множество объектов или явлений
W ={w1 , w2 ,....,wl };
(например, W=самолеты, а w1 -пассажирский самолет Ту-154 , w2 - военно-транспортный самолет АН-12, w3 - истребитель МИГ-29 и т.д.).
Введем множество из r возможных вариантов разбиения этих объектов W на классы (варианты алфавита классов)
A ={A1, A2, ..., Ar}
(например, A1 - 2 класса - пассажирские, военные (m1 =2); A2 -5 классов - истребители, бомбардировщики, штурмовики, пассажирские, военно- транспортные (m2 =5) )
Таким образом, с учетом возможного отказа от решений в каждом варианте множество объектов W подразделяется на свое число классов:
в варианте A1 - на (m1 +1) классов;