Построение систем распознавания образов
 Модуль имитации
начала и продол- начала и продол-
жительности из- жительности из- ....
мерений мерений
 Модуль оценки
Модуль
оценки ....
параметров параметров
 Модуль имитации
аппаратурных аппаратурных ....
ошибок ошибок
Модуль имитации
Модуль
имитации
ошибок канала ошибок канала ....
связи связи
 Модуль имитации
преобразования преобразования ....
параметра в циф- параметра в циф-
ровой код ровой код
Рис.5.6.1. Модель средств измерения характеристик
Л Е К Ц И Я 5.7.
Моделирование алгоритма распознавания
5.7.1. Модель алгоритма распознавания
объектов (явлений, процессов)
О модели алгоритма распознавания следует вести речь в следующих случаях:
1)При программной реализации соответствующего алгоритма не на рабочей ЭВМ, а на ЭВМ, предназначенной только для предварительной его отработки.
2)При отличиях языка программирования модели от языка программирования рабочего алгоритма.
3)При отработке в процессе моделирования принципов построения алгоритма и, в частности, алфавита классов и словаря признаков, а также решающего правила.
4)При различных сочетаниях ситуаций, представленных в пп. 1-3 настоящего перечня.
Если алгоритм системы распознавания реализуется на “своей” ЭВМ в эксплуатационном представлении, то он уже в силу полной изоморфности и аналогичности не представляет собой модель, а является реальной составной частью системы или ее модели (если идет речь о модели системы). В этом случае функциональная схема алгоритма ничем не отличается от схем, приведенных при изучении вопросов их классификации.
Реализация алгоритма распознавания на “своей” ЭВМ совместно с моделью объекта распознавания и средств измерения характеристик представляет собой комбинированную модель СР (реальный программно реализованный алгоритм СР и модели входных воздействий), предназначаемую для оценок:
-правильности функционирования алгоритма СР;
-эффективности системы распознавания, имеющей выбранную структуру и реализацию.
Первая из рассмотренных ситуаций применения моделирования систем распознавания может иметь достаточно широкий спектр задач в процессе создания алгоритма и его отработки, если отсутствуют экономически допустимая возможность его реализации на рабочей ЭВМ или ЭВМ подобного типа.
Точно также существуют условия для возникновения второй ситуации.
Например, желание приспособить готовую программно реализованную СР для другой системы на ЭВМ, где в соответствии с имеющимися требованиями программирование ведется на другом языке или на автокоде, заставляет рассматривать существующую реализацию как модель.
Третья ситуация применения моделей систем распознавания представляется наиболее соответствующей конструирования систем распознавания. В том случае, когда целью моделирования алгоритма является выбор признаков распознавания и алфавита классов, состав модели оказывается наиболее полным по сравнению с другими и поэтому представляющим наибольший интерес.
Главное что отличает такую модель - это наличие модуля описания классов на языке признаков. Забегая вперед, можно заметить, что подобный модуль может быть и принадлежностью рабочего алгоритма СР. Наиболее это очевидно для обучающихся систем распознавания.
Алгоритм функционирования модуля описания классов на языке признаков в максимальной степени интересен для вероятностных систем распознавания. Другие системы имеют более простую и очевидную реализацию.
На начальной стадии модельной отработки вероятностной СР имеем дело с m классами и N признаками распознавания .В дальнейшем их число может быть изменено. Для этого и проводится моделирование.
Тогда, как известно, описание каждого из классов представляется так:
_
Класс 1 : f(X/W1) и P(W1)
_
Класс 2 : f(X/W2) и P(W2)
_
Класс 3 : f(X/W3) и P(W3)
..............................
_
Класс m : f(X/Wm) и P(Wm)
При независимости всех N признаков обычно имеем:
_ _ _ _
f(X/W1) = f(X1/W1)*f(X2/W1)*....*f(XN/W1)
_ _ _ _
f(X/W2) = f(X1/W2)*f(X2/W2)*....*f(XN/W2)
.......................................
_ _ _ _
f(X/Wm) = f(X1/Wm)*f(X2/Wm)*....*f(XN/Wm)
 Как
видим, исходными
данными для
описания классов
N признаками
являются в этом
случае частные
описания каждого
из классов
по каждому
признаку
f(Xj/Wi), где j = 1,N
Отсюда понятно, что если j-ый признак распознавания имитируется в модели объекта ( а у нас такая имитации будет предусмотрена), то при достаточном количестве запусков модели (числе испытаний) получим в каждом заранее известном классе ряд измерений

{Xjk} k = 1, Nисп
Отсюда статистической обработкой может быть получена сначала гистограмма плотности распределения вероятностей
f(Xj/Wi)
Затем аппроксимация этой плотности теоретическим непрерывным распределением (например нормальным) дает требуемое частное описание i-го класса по данному j-му признаку. Точно также получаются частные описания всех классов по каждому из признаков. Они и обеспечивают при указанной независимости признаков начальное описание всех классов.
Таким образом, отсюда понятно, что в составе модуля описания классов модели СР должен находиться субмодуль восстановления плотностей распределения вероятностей признаков в каждом из назначенных классов, реализующий рассмотренный алгоритм.
Обратим теперь внимание на то, что число классов и число признаков в соответствии с имеющимися представлениями о создании СР в исходном состоянии должно быть максимально возможным. Число классов - так как всегда есть стремление к максимальной детализации решений. Число признаков - так как их максимуму соответствует максимум вероятности правильной классификации.
В соответствии с этим модель СР может быть использована для оценки результативности увеличения числа признаков, введения новых. Здесь без дополнения ее путем доработок не обойтись. Ну, а все последующие шаги оптимизации СР, обеспечивающей максимум вероятности правильной классификации, связываются, во-первых, с выбором такого числа признаков, которое удовлетворяло бы имеющимся ограничениям на создание средств измерений и обработки информации. Таким образом, здесь уже имеем дело с противоположной тенденцией - ограничением числа признаков (исключением менее эффективных), но при стремлении сохранить достигнутую эффективность на полном их наборе.
Следовательно, во-вторых, в задачи оптимизации должны входить действия по компенсация потерь от уменьшения числа признаков, которые сопровождаются, как мы уже доказали, только уменьшением числа классов в исходном алфавите.
В результате сокращения числа признаков сокращенное описание будет иметь вид:
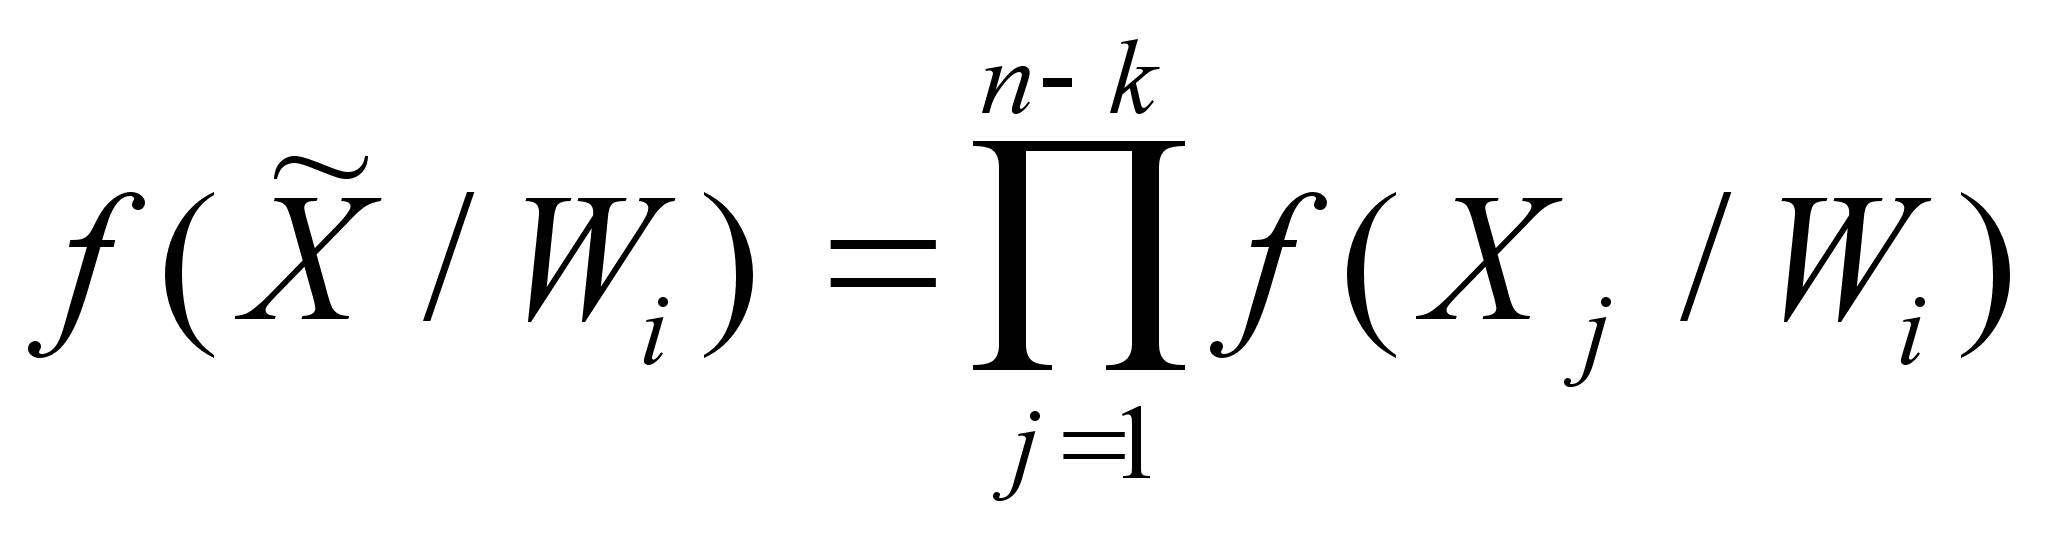
где k - число исключенных признаков распознавания из i-го класса
i = 1,(m-l)
l - число исключенных классов.
Причем здесь предполагается, что после отбора в состав вектора признаков тех, которые удовлетворяют предъявленным ограничениям, производится повторное описание классов .
Когда же есть необходимость уменьшить число классов, то исключаемые из алфавита классы вынужденно объединяются с теми оставшимися в его составе, для которых такое объединение не принесет увеличения числа ошибочных решений в системе. Тогда при объединении, например, двух классов (p-го и q-го) и тот и другой исчезают из алфавита и появляется один новый (m+1)-ый с описанием:
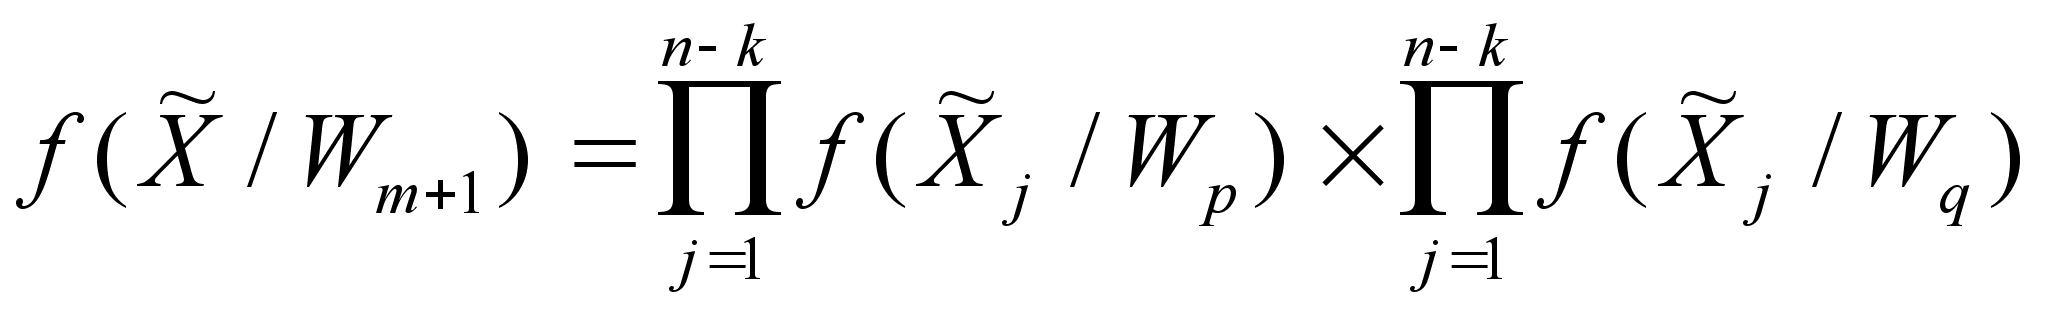
и
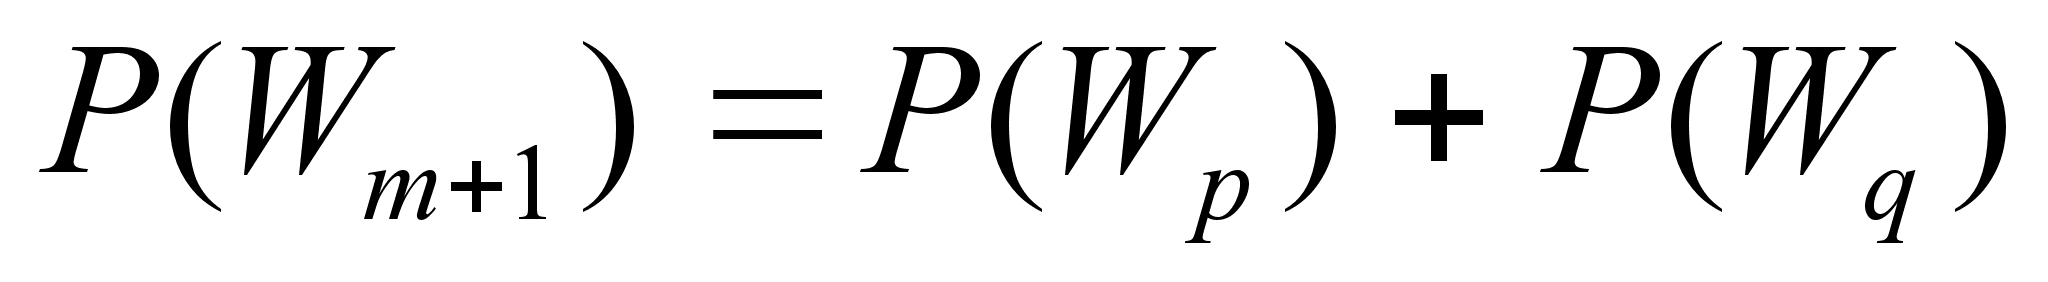
Естественно, что тогда (после исключения) последней алгоритмической функцией в модуле описания классов должна быть функция их перенумерации в новом составе.
Таким образом, последовательность алгоритмических действий модуля описания классов включает:
1)Расчет одномерных плотностей распределения вероятностей каждого из признаков по классам по репрезентативной выборке реализаций измеренных значений (при моделировании объектов и измерителей).
2)Исключение из описаний одномерных плотностей распределения при сокращении размерности вектора признаков.
3)Перекомпоновка плотностей описания классов и априорных вероятностей при сокращении числа классов.
4)Перенумерации классов после объединения отдельных.
Учитывая тот факт, что при имеющихся ограничениях на создание средств измерений и (или) средств обработки приходится варьировать наборами признаков, рассмотренный модуль описания классов должен повторять функции 2-го пункта при каждом новом наборе.
Наличие рассмотренного модуля в составе модели СР предъявляет определенные требования к его окружению. Во-первых, для каждого нового описания классов необходимо в качестве входной информации модуля иметь используемый в данной серии испытаний вектор отбора признаков. При решении задачи объединения классов в качестве входной информации модуля необходимо иметь решение в виде номеров классов, назначенных к объединению. В соответствии с этим модуль обеспечивает:
-повторное описание классов при каждом новом векторе отбора;
-описание объединенных классов после испытаний системы распознавания для одного состава алфавита (перекомпоновка векторов-признаков при их независимости).
Если первая из приведенных задач решается автоматически исключением признаков, то вторая не может быть решена без оценки эффективности СР в данной серии испытаний. То есть, решается после проведения испытаний с данным вариантом алфавита во всем диапазоне допустимых векторов отбора признаков распознавания.
5.7.2. Модуль оценки эффективности системы распознавания
Оценка эффективности СР, как это следует из самого понятия “эффективность”, представляется необходимым элементом модели СР в целом, позволяющим ответить на вопрос, каково качество или созданной системы или системы после ее очередных доработок (изменений алфавита классов и словаря признаков распознавания), осуществляемых в процессе оптимизации.
В том случае, когда решение системы зависит от многих факторов, имеющих случайный характер, показателями, характеризующими оптимальность, являются вероятности правильных и ошибочных решений. Отсюда целесообразным для конструкции модели оценки эффективности должен быть субмодуль оценки вероятностей решений системы.
К основным данным для формализации такого субмодуля относятся исходы модельных испытаний. Они представляют собой решения о принадлежности при известной принадлежности классифицируемого объекта в каждом испытании.
Поэтому работа алгоритма субмодуля в рассматриваемой части заключается в фиксации решений и истиной принадлежности объекта в некоторой матрице решений:
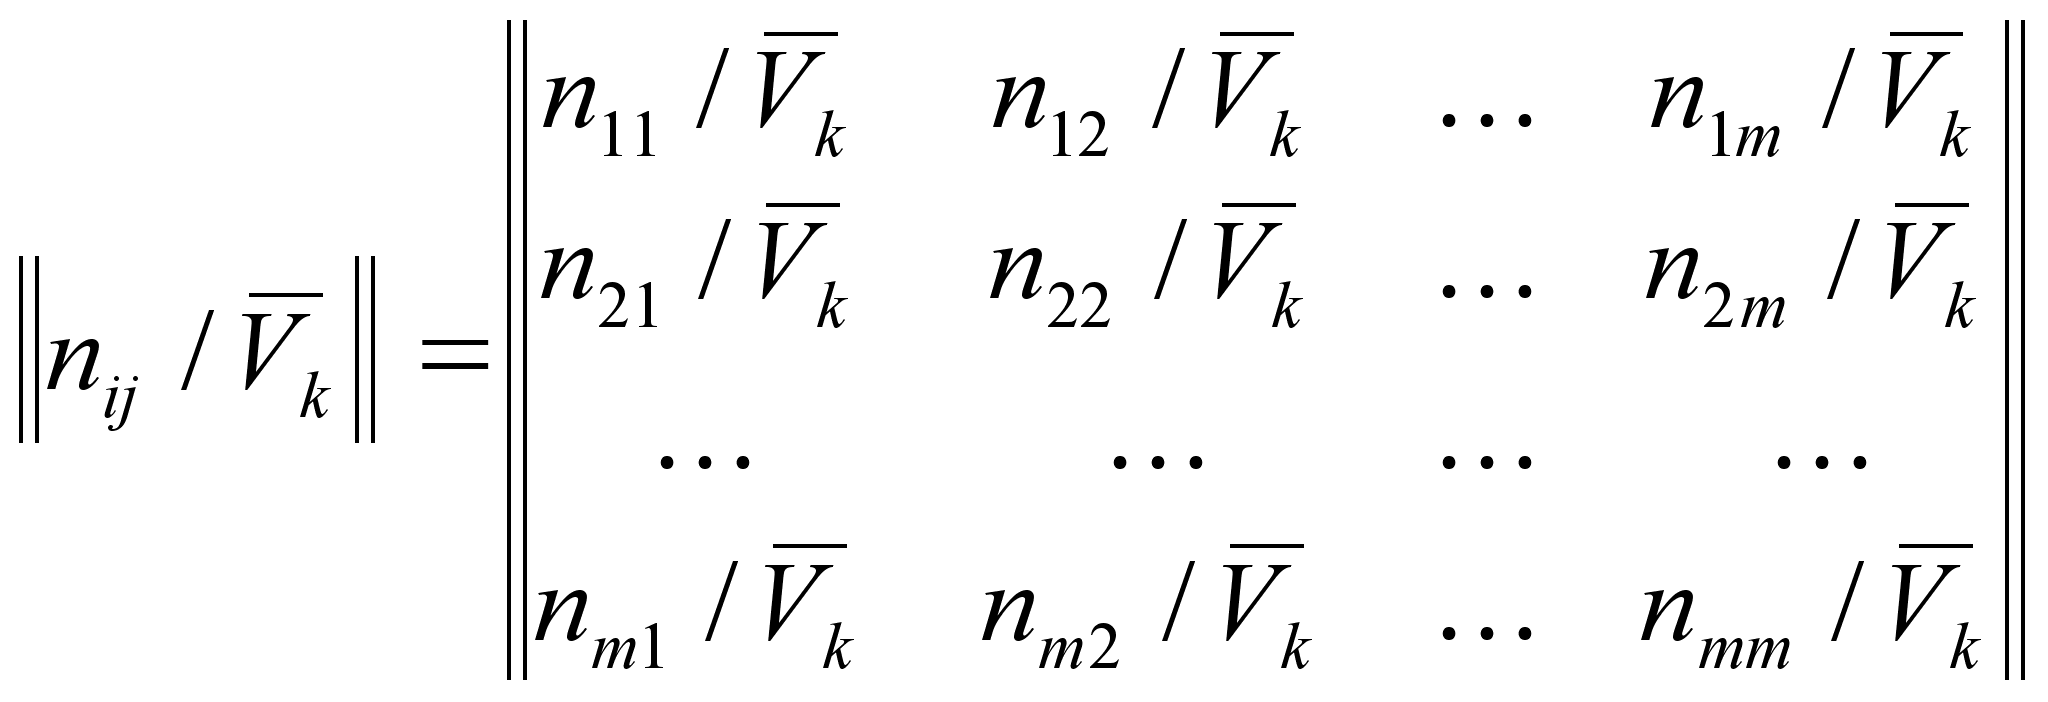
где nij/Vk - число отнесений объекта j-го класса (известного при организации моделирования) к классу i.
Число таких матриц после испытаний СР для каждого вектора отбора Vk равно числу таких векторов, удовлетворяющих ограничениям средств на создание или использование систем измерений признаков распознавания. Если же имеем дело с оценкой конкретной структуры системы распознавания, то естественно будем иметь всего одну матрицу для заданного конкретного набора признаков распознавания.
В любом случае эти матрицы легко преобразуются в матрицы вероятностей соответствующих решений (точнее, частот, сходящихся к вероятности с заданной точностью при специально выбранном количестве модельных испытаний).Тогда для алфавита классов Ar имеем:
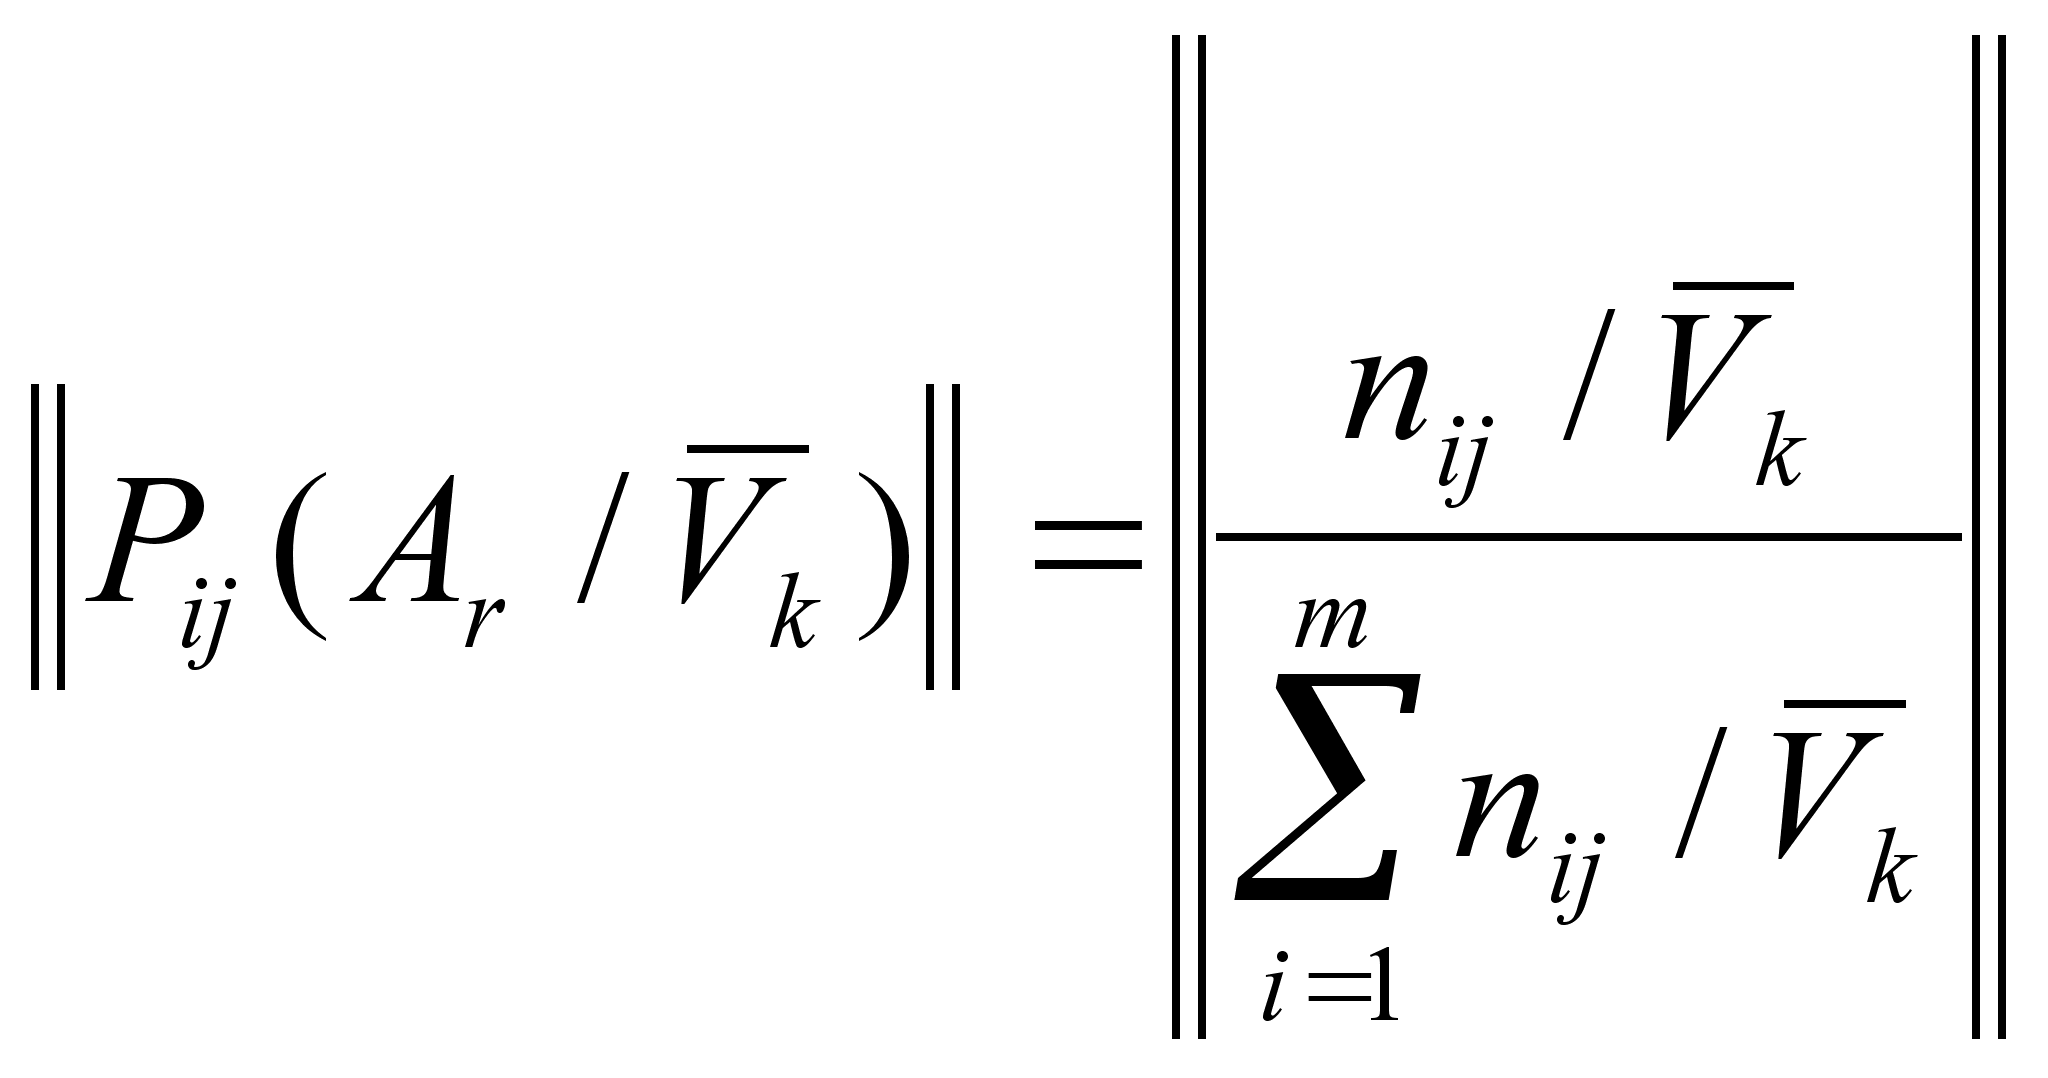
Эта простота конечной оценки показателей функционирования системы как раз и является характерной особенностью метода статистических испытаний (метода Монте-Карло).
Отсюда может быть получена вероятность правильных системных решений в целом (то есть, отнесений ко всем классам алфавита):
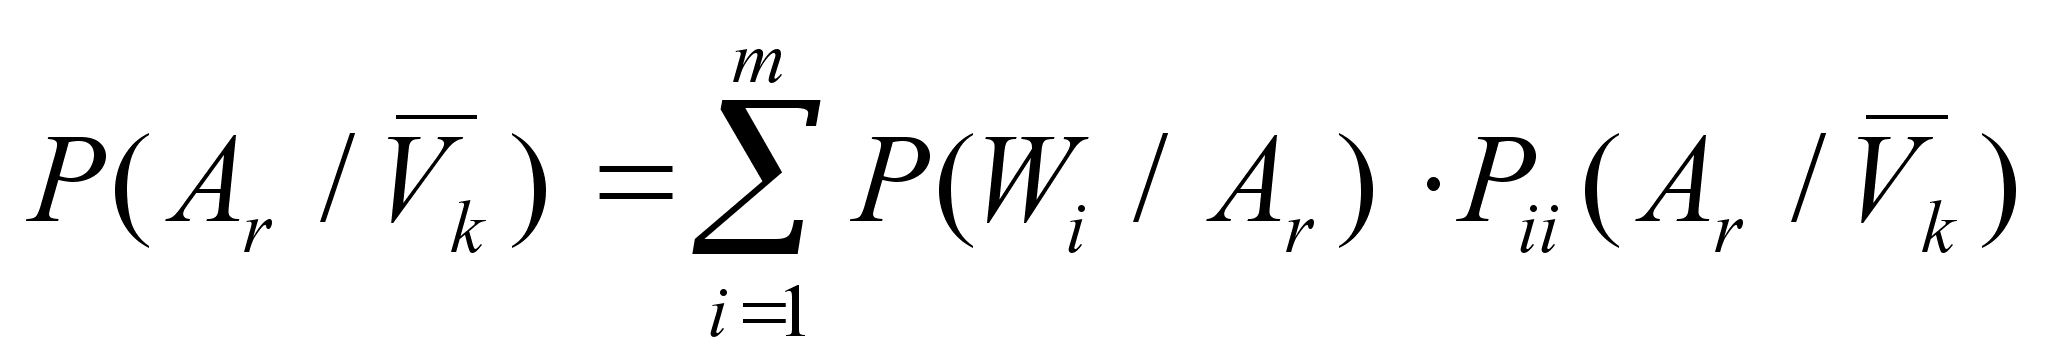
На этом при оценке эффективности СР с конкретной детерминированной структурой моделирование завершается и рассмотренным