Економічне прогнозування
Прогнозом називають науково обґрунтований висновок про майбутні події і перспективи розвитку процесів, про можливі наслідки управлінських рішень.
За специфікою об'єктів прогнози поділяють на науково-технічні, економічні, соціальні, військово-політичні тощо. Економічні прогнози класифікують за масштабністю об'єкта на глобальні, макроекономічні, структурні (міжгалузеві та міжрегіональні), регіональні, галузеві, мікроекономічні.
B світовій практиці прикладного прогнозування використовують різні методи: статистичні (прогнозна екстраполяція), функціонально-ієрархічні (прогнозні сценарії), методи структурної аналогії, імітаційного моделювання, експертні оцінки.
При прогнозуванні соціально-економічних процесів перевага віддається статистичним методам, прогнозним результатом яких є очікувані у майбутньому значення характеристик процесу, тобто статистичний прогноз завжди є умовним.
Іншою особливістю статистичного прогнозу є визначеність його в часі. Часовий горизонт прогнозу називають періодом упередження. За тривалістю цього періоду вирізняють прогнози: короткострокові (до 1 року), середньострокові (до 5 років) і довгострокові (від 5 до 20 років і більше). Тривалість періоду упередження залежить від специфіки об'єкта прогнозування, інтенсивності динаміки, тривалості дії виявлених закономірностей та тенденцій.
Прогнозний результат на період упередження можна представити одним числом (точковий прогноз) або інтервалом значень, до якого з певною ймовірністю належить прогнозна величина (інтервальний прогноз).
Статистичні прогнози ґрунтуються на гіпотезах про стабільність значень величини, що прогнозується; закону її розподілу; взаємозв'язків з іншими величинами тощо. Основний інструмент прогнозування — екстраполяція.
Суть прогнозної екстраполяції полягає в поширенні закономірностей, зв'язків і відношень, виявлених в t-му періоді, за його межі.
Залежно від гіпотез щодо механізму формування і подальшого розвитку процесу використовуються різні методи прогнозної екстраполяції. Їх можна об'єднати в дві групи:
екстраполяція закономірностей динаміки — тренду і коливань;
екстраполяція причинно-наслідкового механізму формування процесу — факторне прогнозування.
Ці методи різняться не процедурою розрахунків прогнозу, а способом описування об'єкта моделювання. Екстраполяція закономірностей розвитку ґрунтується на вивченні його передісторії, виявленні загальних і усталених тенденцій, траєкторій зміни в часі. Абстрагуючись від причин формування процесу, закономірності його розвитку розглядають як функцію часу. Інформаційною базою прогнозування слугують одномірні динамічні ряди.
При багатофакторному прогнозуванні процес розглядається як функція певної множини факторів, вплив яких аналізується одночасно або з деяким запізненням. Інформаційною базою виступає система взаємозв'язаних динамічних рядів. Оскільки фактори включаються в модель у явному вигляді, то особливого значення набуває апріорний, теоретичний аналіз структури взаємозв'язків.
Важливим етапом статистичного прогнозування є верифікація прогнозів, тобто оцінювання їх точності та обґрунтованості. Ha етапі верифікації використовують сукупність критеріїв, способів і процедур, які дають можливість оцінити якість прогнозу.
Найбільш поширене ретроспективне оцінювання прогнозу, тобто оцінювання прогнозу для минулого часу (ex-post прогноз). Процедура перевірки така. Динамічний ряд поділяється на дві частини: перша — для t= 1,2,3, ...,p — називається ретроспекцією (передісторією), друга — для t=p + 1, p + 2, p + 3, ..., p +(n —р) — прогнозним періодом.
За даними ретроспекції моделюється закономірність динаміки і на основі моделі розраховується прогноз Yp+v, де v — період упередження. Ретроспекція послідовно змінюється, відповідно змінюється прогнозний період, що унаочнює рис. 1.1 (для v = 1).
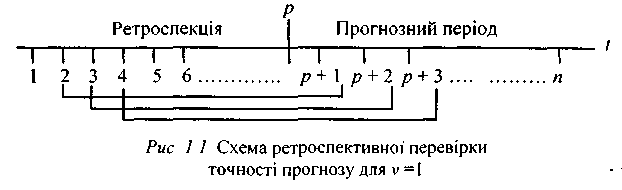
Оскільки фактичні значення прогнозного періоду відомі, то можна визначити похибку прогнозу як різницю фактичного уt і прогнозного Yt рівнів: et = yt – Yt. Всього буде n —р похибок. Узагальнюючою оцінкою точності прогнозу слугує середня похибка:
абсолютна
 ,
квадратична
 .
Для порівняння точності прогнозів, визначених за різними моделями, використовують похибку апроксимації (%):
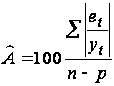
Якщо результат оцінювання точності прогнозу задовольняє визначені критерії точності, скажімо, 10%, то прогнозна модель вважається прийнятною і рекомендується для практичного використання. Очевидно, що похибка прогнозу залежить від довжини ретроспекції та горизонту прогнозування. Оптимальним співвідношенням між ними вважається 3 : 1.
При оцінюванні та порівнянні точності прогнозів використовують також коефіцієнт розбіжності Г. Тейла, який дорівнює нулю за відсутності похибок прогнозу і не має верхньої межі:
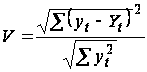
Існуючі методи верифікації прогнозів у більшості своїй ґрунтуються на статистичних процедурах, які зводяться до побудови довірчих меж прогнозу, себто до побудови інтервальних прогнозів.
Методи і моделі прогнозування одновимірних процесів
Ряди динаміки характеризують процеси розвитку соціально-економічних явищ. Цим процесам властиві дві взаємопов'язані риси: динамічність та інерційність, що формують закономірність розвитку.
Ряди, в яких рівні коливаються навколо постійної середньої, називаються стаціонарними. Економічні ряди, як правило, нестаціонарні. Для більшості з них характерна систематична зміна рівнів з нерегулярними коливаннями, коли піки і западини чергуються з різною інтенсивністю. Скажімо, економічні цикли (промислові, будівельні, фондового ринку тощо) повторюються з різною тривалістю і різною амплітудою коливань.
Короткострокове прогнозування на основі ковзних середніх
Досить поширеним і простим методом аналізу динаміки є згладжування ряду. Суть його полягає в заміні фактичних рівнів уt , середніми за певними інтервалами. Варіація середніх порівняно з варіацією рівнів первинного ряду значно менша, а тому характер динаміки проявляється чіткіше. Процедуру згладжування називають фільтруванням, а оператори, за допомогою яких вона здійснюється, — фільтрами. На практиці використовують переважно лінійні фільтри, з-поміж яких найпростіший — ковзна середня з інтервалом згладжування m < n. Інтервали поступово зміщуються на один елемент:
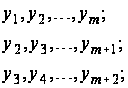
Для
кожного з них
визначається
середня
 ,
яка припадає
на середину
інтервалу. Якщо
m — непарне
число, тобто
m = 2p + 1,
а ваги членів
ряду в межах
інтервалу
однакові
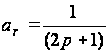 ,
то
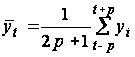
де yi — фактичне значення рівня в i-й момент; i — порядковий номер рівня в інтервалі.
При парному m середина інтервалу знаходиться між двома часовими точками і тоді проводиться додаткова процедура центрування (усереднення кожної пари значень).
Ковзна
середня з однаковими
вагами аr
при згладжуванні
динамічного
ряду погашає
не лише випадкові,
а й властиві
конкретному
процесу періодичні
коливання.
Припускаючи
наявність таких
коливань,
використовують
зважену ковзну
середню, тобто
кожному рівню
в межах інтервалу
згладжування
надають певну
вагу. Способи
формування
вагової функції
різні. B одних
випадках ваги
відповідають
членам розкладання
біному
 , при m=3,
скажімо, ar
= 1/4, 1/2,1/4. B інших
випадках до
даних інтервалу
згладжування
добирається
певний поліном,
наприклад,
парабола
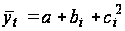 , де i
= -р, …, p. Тоді
вагова функція
така:
Для m = 5
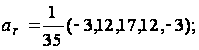
Для m = 7
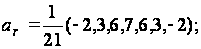 і
т.д.
Як видно
з формул, ваги
симетричні
відносно центра
інтервалу
згладжування,
сума їх з урахуванням
винесеного
за дужки множника
дорівнює
 .
Основна перевага ковзної середньої — наочність і простота тлумачення тенденції. Проте не слід забувати, що ряд ковзних середніх коротший за первинний ряд на 2p рівнів, а отже, втрачається інформація про крайні члени ряду. I чим ширший інтервал згладжування, тим відчутніші втрати, особливо нової інформації . Окрім того, маючи спільну основу розрахунку, ковзні середні виявляються залежними, що при згладжуванні значних коливань навіть за відсутності циклів у первинному ряду може вказувати на циклічність процесу (ефект Слуцького).
У симетричних фільтрах стара і нова інформація рівновагомі, а при прогнозуванні важливішою є нова інформація. У такому разі використовують асиметричні фільтри. Найпростіший з них — ковзна середня, яка замінює не центральний, а останній член ряду (адаптивна середня):
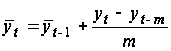 .
У наведеній
формулі перший
елемент характеризує
інерцію розвитку,
другий — адаптує
середню до
нових умов.
Таким чином
середня
 з
кожним кроком
ніби оновлюється.
Ступінь оновлення
визначається
постійною вагою
 .
При використанні
зважених асиметричних
фільтрів вагова
функція формується
з урахуванням
ступеня новизни
інформації.
Такою є середня
з екс-поненційно
розподіленими
вагами:
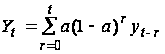 ,
де Yt,
— експоненційна
середня, тобто
згладжене
значення рівня
динамічного
ряду на момент
t;
 — вага ( t - r )-гo
рівня; a — параметр
згладжування,
який визначає
вагу t-гo рівня,
значення його
коливаються
в межах від 0
до 1.
Розклавши формулу за елементами суми, маємо
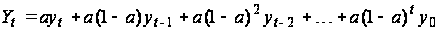 ,
або
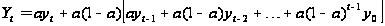
Друга
складова останньої
формули є не
що інше, як
експоненційна
середня для
(t- l)-гo моменту.
Отже, експоненційну
середню можна
представити
як лінійну
комбінацію
фактичного
рівня t-гo моменту
та експоненційної
середньої (t
- l)-гo моменту:
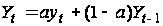 .
Чим віддаленіший від t-го моменту рівень ряду, тим менша його відносна вага і вклад у тенденцію. Так, при a = 0,2 ваги становлять: для t- го моменту — 0,2, для ( t – 1 )- го моменту — 0,2(1 -O,2) = 0,16; для (t-2)-ro моменту — 0,2(1 -0,2)2 = 0,128 і т. д. Надаючи більшу вагу новій інформації, експоненційна середня адаптується до нових умов, що робить її досить ефективним і надійним методом короткострокового прогнозування.
Для розрахунку
експоненційної
середньої Yt,
необхідно
визначити
початкові
умови: початкову
величину Y0
і параметр
а. Як початкову
величину можна
використати
середній рівень
за минулий (до
динамічного
ряду) період,
або за відсутності
таких даних,
перший рівень
ряду, тобто
Yo=yt. Щодо
параметра а,
то на практиці
найчастіше
використовують
його значення
в інтервалі
від 0,1 до 0,3 . Оскільки
від параметра
а залежить
сума вагових
коефіцієнтів
 на певному
часовому інтервалі
m, то можна за
наперед заданим
значенням цих
величин орієнтовно
визначити
параметр а:
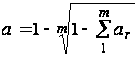
Наприклад,
якщо часовий
інтервал m = 10
місяців, а сума
ваг
 = 0,90 , то
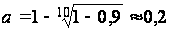 .
Тобто, при a =
0,2 десять членів
динамічного
ряду визначать
90% величини
експоненційної
середньої.
При
прогнозуванні
процесу вдаються
до багаторазового
згладжування.
Якщо період
упередження
v = 1, то використовують
подвійне
згладжування.
Експоненційна
середня другого
порядку
 визначається
за такою ж самою
рекурентною
формулою на
основі згладженого
ряду
 :
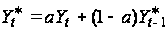 .
Якщо припустити наявність лінійного тренда, прогнозний рівень Yt+1 можна розрахувати за формулою :
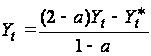
Довірчі межі прогнозного рівня визначаються традиційно:
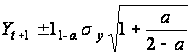
де
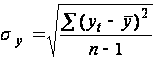 ѕ
дисперсія
рівнів первинного
динамічного
ряду; t— квантиль розподілу Стьюдента для ймовірності ( 1 - a ).
Очевидно, що за умови значної варіації рівнів динамічного ряду довірчі межі будуть досить широкими.
Базову модель експоненційного згладжування можна використати при моделюванні рядів, які мають сезонну компоненту.
Оцінювання сезонної компоненти
Сезонні коливання формуються під впливом не лише природно-кліматичних, але й соціально-економічних факторів. Сила і напрям дії окремих факторів формує різну конфігурацію сезонної хвилі. За своїм характером сезонна компонента може бути адитивною або мультиплікативною. Для адитивної компоненти характерні сталі коливання навколо середнього рівня чи тренда, для мультиплікативної — зростання амплітуди коливань з часом.
Кожний рівень ряду уt , належить до певного сезонного циклу s, Довжина якого становить 12 місяців, або 4 квартали. Відношення Yt до середнього рівня за цикл називається індексом сезонності:
 .
За умови, що вплив несезонних факторів еліміновано, середня з iндексіву j-го циклу становить 1, або 100 % .
У нестаціонарних рядах замість середньої використовують лі-н'ю тренда Yt = y(t), яка плавно проходить через ряд динаміки і , як і середня , елімінує його нерівномірності. Сукупність індексів Сезонності в межах циклу характеризує сезонний ритм.
Прогнозування
сезонних процесів
ґрунтується
на декомпозиції
динамічного
ряду. Припускають,
що у майбутньому
збережеться
тенденція і
такий же характер
коливань. За
таких умов
прогноз на
будь-який місяць
(квартал), визначений
методом
екстра-поляціїтренда,
коригується
індексом сезонності:
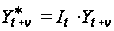 , де v — період
упередження.
Скажімо, поквартальна
динаміка обсягів
імпорту пального
(тис. т) за два
роки (n = 8, t1 =
-3,5, tn = 3,5) описується
трендом Yt
= 923,7 + 33,8t, за яким
теоретичний
обсяг імпорту
у восьмому
кварталі становить
1042,0 тис.т, а в 1-му
кварталі наступного
року (v=1) передбачається
Yt+v= 1042,0 + 33,8 * 1 = 1075,8 . Якщо
середній індекс
сезонності
1-го кварталу
It = 1,34, то
скоригований
на сезонність
прогнозний
рівень дорівнює
 ,=
1,34 - 1075,8 = 1441,6 тис.т.
Динаміка більшості показників не виявляє чітко вираженої тенденції розвитку. Через постійний перерозподіл впливу факторів, які формують динаміку процесу, змінюється інтенсивність динаміки, частота та амплітуда коливань. До таких фактичних даних більш еластичною виявляється ковзна середня, інтервал згладжування якої дорівнює сезонному циклу (4 або 12). Коригування ковзної середньої на сезонність здійснюється так само, як коригування лінійного тренда.
Ha використанні експоненційної середньої ґрунтується ceзонно-деколіпозиційна модель Холта-Вінтера, в якій поєднуються моделі стаціонарності, лінійності та сезонності. Послідовність операцій така:
1. Визначаються індекси сезонності It
2. Ряд динаміки фільтрується від сезонних коливань діленням yt на коефіцієнт сезонності з лагом s; ряд ut = yt : It-s називається декомпозиційним.
3. Перші різниці декомпозиційного ряду bt = (ut – ut-1 ) розглядаються як характеристики лінійного тренда.
Кожна з компонент моделі згладжується за допомогою експоненційної середньої. При комбінації лінійної та сезонно-адитивної моделей тренда:
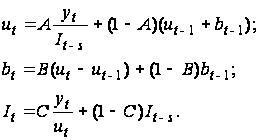
Значення параметрів згладжування A, D і C в системі Statistica за умовчування визначаються на рівні 0,1, в [10] рекомендуються: A = 0,2; B = 0,2; C = 0,5.
За умови ізольованої оцінки трьох факторів прогноз на період упередження v визначається як скоригована на сезонність сума прогнозного рівня ut , і лінійного тренда:
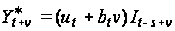 .
При комбінації лінійного та сезонно-мультиплікативного трендів кінцевий прогноз визначається за формулою :
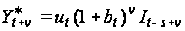 ,
де
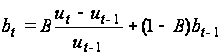 .
Типи трендових моделей
При моделюванні динамічних процесів причинний механізм формування властивих їм особливостей у явному вигляді не враховується. Будь-який процес розглядається як функція часу. Певна річ, час не є фактором конкретного соціально-економічного процесу, змінна часу t просто акумулює комплекс постійно діючих умов і причин, які визначають цей процес.
У моделях динаміки процес умовно поділяється на чотири складові:
довгострокову, детерміновану часом еволюцію — трендf(t));
періодичні коливання різних частот Ct;
сезонні коливання St;
випадкові коливання et.
Зв'язок між цими складовими представляється адитивно (сумою) або мультиплікативно (добутком):
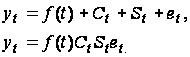
Така умовна конструкція дає змогу, залежно від мети дослідження, вивчати тренд, елімінуючи коливання, або вивчати коливання, елімінуючи тренд. При прогнозуванні здійснюється зведення прогнозів різних елементів в один кінцевий прогноз.
Характерною
властивістю
будь-якого
динамічного
ряду є залежність
рівнів: значення
уt
, певною
мірою залежить
від попередніх
значень: i т. д. Для оцінювання
ступеня залежності
рівнів ряду
використовують
коефіцієнти
автокореляції
rр
з часовим
лагом p =
1, 2, ..., т.
Коефіцієнт
rр
характеризує
щільність
зв'язку між
первинним рядом
динаміки і цим
же рядом, зсуненим
на p моментів.
У табл. 2.1 наведено
зсунені ряди
динаміки з
лагами p
- 1, 2, 3. Як видно,
із збільшенням
лага p кількість
пар корельованих
рівнів зменшується.
Так, при p
= 1
довжина корельованих
рядів менша
за первинний
ряд на один
рівень, при p
= 2 — на два
рівні і т. д. Через
це на практиці
при визначенні
автокореляційної
функції дотримуються
правила, за
яким кількість
лапв
 .
Таблиця 2.1
| Змінна часу t | Рівень ряду у | р=1 | р = 2 | р = 3 |
| 1 |
|
— | — | — |
| 2 |
|
|
— | — |
| З |
|
|
|
— |
| … | … | … | … | … |
| n-2 |
|
|
|
|
| n-1 |
|
|
|
|
| n |
|
|
|
|


Значення коефіцієнта автокореляції rр визначається величиною лага p і не виходить за межі ±1:

де
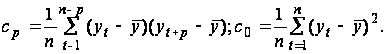
Послідовність коефіцієнтів rр називають автокореляційною функцією і зображують графічно у вигляді автокорелограми з абсцисою p та ординатою rp.
За
швидкістю
згасання
автокореляційної
функції можна
зробити висновок
про характер
динаміки. Найчастіше
використовується
значення r1.
Характеризуючи
ступінь залежності
двох послідовних
членів ряду,
коефіцієнт
автокореляції
є мірою неперервності
цього ряду.
Якщо
 ,
то ряду динаміки
властива тенденція
розвитку, якщо
 — рівні ряду
незалежні.
Відносно високі
значення коефіцієнта
автокореляції
при p = k, 2k, 3k, …
свідчать про
регулярні
коливання.
На відміну від детермінованої складової випадкова складова не зв'язана із зміною часу. Аналіз цієї складової є основою перевірки гіпотези про адекватність моделі реальному процесу. За умови, що модель вибрано правильно, випадкова складова являє собою стаціонарний процес з математичним сподіванням M(e) = 0 і дисперсією
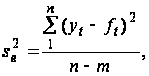
де m — число параметрів функції.
Для оцінювання
стаціонарності
випадкової
складової
використовують
циклічний
коефіцієнт
автокореляції
першого порядку
r1. Корелюються
ряди залишкових
величин:
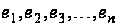 та
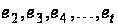
Припускаючи,
що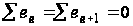 ,
формула розрахунку
спрощується:
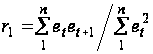 .
Існують таблиці критичних значень циклічного коефіцієнта автокореляції для додатних і від'ємних значень (додаток 5). Якщо фактичне значення r1 менше за критичне, автокореляція вважається неістотною, а випадкова складова — стаціонарним процесом. У разі, коли фактичне значення r1 перевищує критичне, можна зробити висновок про неадекватність детермінованої складової реальному процесу.
Важливою складовою динамічних процесів є тенденція середньої, тобто основний напрям розвитку. B аналізі динамічних рядів тенденцію представляють у вигляді плавної траєкторії та описують певною функцією, яку називають трендом Yt = f(t), де t= 1, 2, … , n — змінна часу. Ha основі такої функції здійснюється вирівнювання динамічного ряду і прогнозування подальшого розвитку процесу.
Процедура вирівнювання динамічних рядів включає два етапи: обґрунтування (вибір) типу функції, яка б адекватно описувала характер динаміки, та оцінювання параметрів функції. Ha практиці переважно використовують функції, параметри яких мають конкретну інтерпретацію залежно від характеру динаміки. Найбільш поширені поліноми (многочлени), різного роду експоненти та логістичні криві. Так, параметри полінома p-ro ступеня Yt = a + bt + ct2 + dt3… характеризують:
а — рівень динамічного ряду при t = 0;
b — абсолютну швидкість зміни рівнів ряду (ординат);
2c — прискорення (прирощення абсолютної швидкості);
d — зміну прирощення тощо.
Поліном 1-го ступеня, тобто лінійний тренд Yt = a + bt, описує процеси, які рівномірно змінюються в часі і мають стабільні прирости ординат. Поліном 2-го ступеня (парабола) Yt = a + bt + ct2 здатний описати процес, характерною особливістю якого є рівноприскорене зростання або зменшення ординат. Форма параболи визначається параметром c: при c > 0 гілки параболи спрямовані вгору — парабола має мінімум, при c < 0 гілки параболи спрямовані вниз — парабола має максимум. При визначенні екстремуму (max, min) похідну параболи прирівнюють до нуля і розв'язують систему рівнянь відносно t. Наприклад, динаміка захворювань при епідемії грипу (чол.) описується параболою Yt = 264 + 45t - 1,5t2. Похідна параболи 45-2,25t = 0, a t = 20. Максимум захворювань буде зафіксовано через 20 днів від початку відліку часу (t = 0) і становитиме Ymах = 264 + 45 – 20 - 1,5 Ч 202 = 564 чол. У полінома 3-го ступеня Yt = a + bt + ct2 + dt3 знак прирощення ординати може змінюватися один чи два рази.
Якщо характерною властивістю процесу є стабільна відносна швидкість (темпи приросту), такий процес описується експонентою яка може набувати різних еквівалентних форм. Основна (показникова) форма експоненти
Yt = abt
де b — середня відносна швидкість зміни ординати: при b > 1 ордината зростає з постійним темпом, при b < 1, навпаки, зменшується. Абсолютний приріст пропорційний досягнутому рівню. Експоненту можна представити у формі:
 або

де l = lnb, е = 2,718 — основа натурального логарифма, lne = 1.
Експоненти приводяться до лінійного виду заміною yt десятковими або натуральними логарифмами:
lgY =lga + tlgb, |
lnY = lna + ltlne = lna + lt,
lnY = lnea + lnebt = lna + lnbt = lna + lt .
Оцінювання параметрів трендових рівнянь найчастіше здійснюється методом найменших квадратів (MHK), основною умовою якого є мінімізація суми квадратів відхилень фактичних значень yt від теоретичних Yt, визначених за трендовим рівнянням :
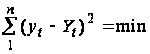 .
Параметри поліноміального тренда визначаються безпосередньо розв'язуванням систем p + 1 нормальних рівнянь. Експонента, як показано вище, приводиться до лінійного виду логарифмуванням; розраховані параметри підлягають потенціюванню.
Виявлену тенденцію можна продовжити за межі динамічного ряду Така процедура називається екстраполяцією тренда. Принципова можливість екстраполяції ґрунтується на припущенні, що