Економічне прогнозування
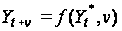 ,
де
Yt+v
— прогнозне
значення на
період упередження
v;
 — база
екстраполяції,
найчастіше
це останній,
визначений
за трендом
рівень ряду.
Екстраполяція
тренда дає
точковий прогноз.
Очевидно, що
«влучення в
точку» малоймовірне.
Адже тренду
властива
невизначеність,
передусім через
похибки параметрів.
Джерелом цих
похибок є обмежена
сукупність
спостережень
yt,
кожне з
яких містить
випадкову
компоненту
et,.
Зсунення
періоду спостереження
лише на один
крок веде до
зсунення оцінок
параметрів.
Випадкова
компонента
буде присутня
і за межами
динамічного
ряду, а отже,
її необхідно
врахувати. Для
цього визначають
довірчий інтервал,
який би з певною
ймовірністю
окреслив межі
можливих значень
Yt
+
v
Точковий
інтервал
перетворюється
в інтервальний.
Ширина інтервалу
залежить від
варіації рівнів
динамічного
ряду навколо
тренда та ймовірності
висновку (1
- а):
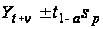
Де
Sp
— середня
квадратична
похибка прогнозу,
значення якої
залежить від
дисперсії
тренда
 та дисперсії
відхилень від
тренда
 .
Зокрема,
для лінійного
тренда
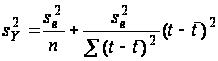 .
Якщо база
прогнозування
— останній
рівень ряду,
то
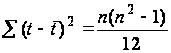 ,
a
 замінюється
на
 .
Після нескладних
алгебраїчних
перетворень
похибку прогнозу
за лінійним
трендом можна
представити
так:
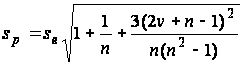
або, позначивши підкореневий вираз символом z, sp = sez.
Тобто
похибка прогнозу
залежить від
залишкової
дисперсії
 ,
довжини динамічного
ряду (передісторії)
n та періоду
упередження
v. Чим довший
період передісторії,
тим похибка
менша, а збільшення
періоду упередження,
навпаки, веде
до зростання
похибки прогнозу.
Прогнозування повних циклів
Свої
особливості
має моделювання
динамічних
процесів з
ефектом насичення,
коли темпи
зростання
(зниження)
уповільнюються
і рівень наближується
до певної межі
(питомі витрати
ресурсів, споживання
продуктів
харчування
на душу населення
тощо). Для їх
описування
використовують
клас кривих,
що мають горизонтальну
асимптоту
 .
Найпростішою
з-поміж них є
модифікована
експонента:
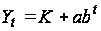
де параметр а — різниця між ординатою Yt, при t = 0 та асимптотою K. Якщо a < 0, асимптота знаходиться вище кривої, якщо a > 0 — асимптота нижче кривої. Параметр b характеризує співвідношення послідовних приростів ординати. За умови рівномірного розподілу ординати по осі часу ці співвідношення є сталими:
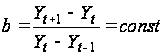 .
Модифікована експонента описує процеси, на які діє певний обмежувальний фактор, і вплив цього фактора зростає зі зростанням Yt. У разі, коли обмежувальний фактор впливає лише після певного моменту, до якого процес розвивався за експоненційним законом, то такий процес найкраще апроксимується S-подібною функцією з точкою перегину P, в якій прискорене зростання змінюється уповільненням. Наприклад, попит на новий товар попервах незначний; потім, після визнання споживачами, він стрімко зростає, але у міру насичення ринку темпи зростання уповільнюються, згасають. Попит стабілізується на певному рівні. Аналогічні фази розвитку мають процеси нововведень і винаходів, ефективність використання ресурсів тощо. З-поміж S-подібних кривих, що описують повний цикл розвитку, найпоширенішою є функція Перла-Ріда — логістична крива:
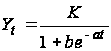 .
Якщо показник процесу — частка, що змінюється в межах від 0 до 1, то формула логістичної функції спрощується:
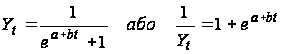 .
У страховій
і демографічній
статистиці
використовують
іншу S-подібну
функцію — криву
Гомперца:
 або в логарифмах
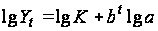 .
Тобто крива Гомперца приводиться до модифікованої експоненти, у якої сталими є відношення приростів ординат у логарифмах.
Оцінювання параметрів функцій, які мають асимптоти, порівняно з поліномами та експонентами значно складніше. Тут можливі два варіанти.
За першим
варіантом
асимптота у
вигляді нормативу,
стандарту тощо
визначається
апріорі —
 .
Тоді модифіковану
експоненту
можна представити
так:
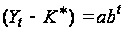 .
Замінивши
 на z і прологарифмувавши
рівняння, дістанемо
лінійну функцію
логарифмів
lgz = lga + tlgb. Аналогічно
приводиться
до лінійного
виду логістична
функція
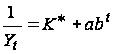 ,
яка при заміні
 на z у логарифмах
набуває такого
ж вигляду: lgz =
lga + tlgb. Параметри
приведених
до лінійного
виду функцій,
як і параметри
поліномів,
можна оцінити
методом найменших
квадратів.
Отже, клас
моделей динаміки
досить широкий,
і вони описують
різні процеси
розвитку. Вибір
типу моделі
у конкретному
дослідженні
ґрунтується
передусім на
теоретичному
аналізі специфіки
процесу, його
внутрішньої
структури,
взаємозв'язків
з іншими процесами.
Ha основі такого
аналізу в загальних
рисах визначається
характер динаміки
(рівномірний,
рівноприскорений,
з насиченням
тощо) та окреслюється
коло функцій,
здатних апроксимувати
цей процес.
Серйозною
підмогою при
виборі конкретної
моделі слугують
формальні
методи. Скажімо,
для поліномів
— це аналіз
послідовних
різниць. Рівність
різниць р-го
порядку розглядається
як симптом
того, що процес
описується
поліномом р-го
порядку. Якщо
приблизно
однакові різниці
1-го порядку
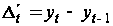 ,
використовують
лінійний тренд,
якщо однакові
різниці 2-го
порядку —
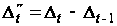 — параболу і
т. д. Певні складнощі
можуть виникнути
при виборі
експоненти.
Адже S-подібна
крива до точки
перегину описує
експоненційний
тренд, а сама
точка перегину
може бути за
межами динамічного
ряду. Отже, якщо
межа насичення
теоретично
можлива і процес
у майбутньому
може згасати
або існують
певні обмеження
для процесу
(правові, матеріальних
ресурсів, виробничих
потужностей
тощо), то перевага
віддається
S-подібній кривій.
Оскільки первинним рядам динаміки властива значна варіація рівнів yt то аналіз послідовних різниць більш коректно проводити на основі рядів ковзних середніх. У табл.2.2 наведено основні характеристики такого аналізу (апріорні тести), за якими визначається конкретний тип моделі повного циклу.
Таблица 2.2
| Характеристика | Властивості характеристик | Тип трендової моделі |
|
|
Приблизно однакові | Поліном 1-го ступеня |
|
|
Лінійно змінюються | Поліном 2-го ступеня |
|
|
Приблизно однакові | Експонента |
|
|
Лінійно змінюються | Модифікована експонента |
|
|
Лінійно змінюються | Логістична крива |
|
|
Лінійно змінюються | Крива Гомперца |


При зворотному напрямку тенденції різниці розраховуються, починаючи з кінця. За наявності від'ємних різниць логарифмування неможливе, тому необхідно збільшити інтервал згладжування ковзних середніх.
Типи моделей взаємозв'язку
Усі явища навколишнього світу взаємопов'язані й взаємозумовлені. У складному переплетенні всеохоплюючого взаємозв'язку будь-яке з них є наслідком дії певної множини причин і водночас причиною інших явищ.
Логічний зміст і практичну значущість статистичних моделей взаємозв'язку слід розглядати саме в площині співвідношення причинності і зв'язків, що вимірюються статистичними методами. Суть причинності полягає в породженні одного явища іншим. Причина — активна основа, що примушує інше явище змінюватися. Сама по собі причина не визначає наслідку. Останній залежить і від умов, у яких діє причина. Через нерозрізненість причин і умов при моделюванні вони об'єднуються в одне поняття «фактор», а наслідок розглядається як результат дії факторів. Отже, в рамках моделі досліджується детермінованість результату факторами.
Методологічні проблеми побудови моделей взаємозв'язку можна об'єднати в дві групи:
формування ознакової множини моделі, себто визначення кількості факторів та їх числових еквівалентів;
модельна специфікація — вибір функціонального виду моделі, ідентифікація та оцінювання параметрів.
При формуванні
ознакової
множини моделі
різноманітні
прояви причинно-наслідкових
зв'язків доцільно
представляти
візуально у
вигляді спеціальних
конструкцій
— графів зв'язку,
елементами
яких е вершини
та орієнтовані
ребра (дуги).
Вершини графа
відповідають
ознакам, а дуги
показують
відношення
між ознаками.
На рис. 2.1 ілюструється
граф зв'язку
чотирьох ознак.
За дугами графа
можна простежити
систему відношень
між ними: х
впливає на
у прямо, безпосередньо,
z — прямо та
опосередковано
двома шляхами:
 та
 .
У такій логічній
конструкції
ознака у є
результатом,
а х, z і
 —
факторами, що
визначають
результат.
Граф відображує теоретично обґрунтовану систему відношень між ознаками. Кожна ланка цієї системи розглядається як окрема гіпотеза, що підлягає перевірці в подальшому аналізі на усіх етапах побудови моделі. Основна мета моделей взаємозв'язку - виявити і кількісно виміряти вплив факторів на результат. Очевидно, щоб визначити ефект впливу і-го фактора, необхідно елімінувати (усунути) вплив інших факторів, умовно зафіксувавши їх шляхом відповідних розрахунків на одному і тому ж рівні.
На етапі модельної специфікації враховується характер зв'язку та особливості наявної інформації. За своїм характером зв'язки поділяються на стохастичні, різновидом яких є кореляційні зв'язки, та жорстко детерміновані (функціональні). Перші відображують стохастичний характер причинно-наслідкових відношень, Другі - адитивні чи мультиплікативні зв'язки між елементами розрахункових формул показників. Відповідно вибирається функціональна форма моделі: кореляційні зв'язки описуються переважно регресійними моделями, функціональні - балансовими або індексними. У моделях, що описують функціональні зв'язки, ступінь вільності при формуванні ознакової множини обмежена, маневрувати можна лише кількістю факторів, укрупнюючи їх чи деталізуючи. Для регресійних моделей характерна багатоваріантність як ознакової множини, так і функціональної форми моделі. Інформаційна база моделі залежить від того, як представлено об’єкт моделювання. Якщо він розглядається як сукупність елементів у просторі, то інформація подається просторовими рядами
У вигляді
матриці обсягом
 ,
де п - обсяг
сукупності,
т - кількість
включених у
модель факторів.
Класична регресія
передбачає
однорідність
сукупності,
тобто всі одиниці
сукупності
мають бути
однотипними
щодо комплексу
умов існування,
а властиві їм
закономірності
однаковими
для усіх одиниць
без винятку.
Якщо сукупність
внутрішньо
диференційована,
має у своєму
складі певні
групи (класи)
одиниць зі
специфічним
характером
зв'язку, в моделі
слід врахувати
неоднорідність
за принципом
структурної
подібності.
Методи відображення
неоднорідності
залежать від
характеру та
сталості міжгрупових
розбіжностей.
Моделі, побудовані у просторовій площині, охоплюють одиничний, фіксований інтервал часу. Серія такого типу моделей за певний період дає можливість простежити динаміку взаємозв'язків, оцінити зміну потужності впливу окремих факторів, його перерозподіл.
Якщо об'єкт моделювання розглядається як первинний, неподільний елемент (галузь економіки, регіон, країна), то інформаційна база представляється багатовимірним динамічним рядом у вигляді матриці обсягом (т • Т), де Т- довжина динамічного ряду. В такому разі в моделі необхідно відобразити властиві процесу закономірності динаміки, як-от: тенденції, коливання, запізнення впливу тощо. За умови, що об'єкт моделювання нечисленний, а довжина динамічного ряду обмежена, просторові та динамічні ряди об'єднуються.
На практиці використовують переважно автономно побудовані моделі, тобто моделі одного показника-функції. Специфікація моделі залежить від її призначення, природи і структури взаємозв'язків, специфіки об'єкта моделювання, наявної інформації. Поєднання, комбінація усіх цих елементів визначає безліч типів моделей.
В автономних регресійних моделях (одного рівняння) відбувається складний процес елімінування впливів між включеними в модель факторами і виокремлення безпосереднього впливу кожного з них на результат. Фактичне використання такої моделі передбачає, що в разі необхідності рівні факторів можна змінювати незалежно один від одного. Проте в реальних умовах зміна одного фактора не може відбуватися за незмінності інших, вона спричиняє ланцюгову реакцію в усій системі взаємозв'язаних показників. Поряд з безпосереднім прямим впливом має місце опосередкований вплив, часом за різними напрямами, що потребує оцінювання сумарного впливу. Іноді одна й та сама змінна виступає водночас причиною і наслідком. Тоді виникає необхідність одночасного оцінювання прямого і зворотного впливів.
Складне переплетення взаємозв'язків соціально-економічних явищ потребує і складних інструментів аналізу. З-поміж таких інструментів є системи рівнянь, заміна множин висококорельованих ознак інтегральними факторами (головними компонентами) тощо. Методологічні засади модельної специфікації розглядаються за принципом «від простого до складного».
Класична регресія
Регресійна модель описує об'єктивно існуючі між явищами кореляційні зв'язки. За своїм характером кореляційні зв'язки надзвичайно складні та різноманітні. В одних випадках результат у зі зміною фактора х, зростає чи зменшується рівномірно, в інших — нерівномірно. Іноді зростання може змінитися зменшенням і навпаки. Простежити всі ці взаємозв'язки і встановити точний функціональний вид практично неможливо. А тому при виборі типу функції йдеться лише про апроксимацію відносно простими функціями незрівнянно більш складних за своєю природою взаємозв'язків. На практиці перевагу віддають моделям, які є лінійними або приводяться до лінійного виду шляхом перетворення змінних, наприклад логарифмуванням. Такий підхід, безперечно, містить у собі певну умовність, оскільки передбачає однаковий характер зв'язку з усіма факторами. Проте використання надто складних функцій неминуче веде до збільшення кількості параметрів, а отже, зменшує точність вимірювання та ускладнює інтерпретацію результатів.
При обґрунтуванні типу функції слід враховувати й той факт, що межі варіації корельованих ознак у конкретних умовах простору і часу, в конкретній сукупності значно вужчі за їх можливі значення, і в цих межах варіації навіть лінійна функція може задовільно апроксимувати зв'язок.
У
лінійному щодо
параметрів
рівнянні регресії
індивідуальне
значення
результативного
показника
 (де j — порядковий
номер одиниці
сукупності)
записується
так:
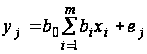 ,
де
 — вільний член
рівняння;
економічного
змісту, як правило,
не має, лише
окреслює область
існування
моделі;
 —
коефіцієнт
регресії;
показує,
як в середньому
змінюється
 зі зміною
 на
одиницю її
шкали вимірювання
за незмінності
інших включених
в модель факторів
і за інших рівних
умов;
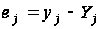 —
залишкова
величина.
У
регресійній
моделі основне
навантаження
покладається
на коефіцієнт
регресії
,
він розглядається
як своєрідна
міра «очищеного»
впливу
 на у
і називається
ефектом
впливу.
Процедура оцінювання параметрів регресійної моделі ґрунтується на методі найменших квадратів (МНК). Оскільки алгоритми МНК описано в математико-статистичній літературі й реалізовано в комп'ютерних програмах, наведемо лише загальну схему розрахунку статистичних характеристик моделі, акцентуючи увагу на їх змістовній інтерпретації.
Первинна
інформація
представляється
як матриця
факторних ознак
X розміром (п
• т) і вектора
результативної
ознаки у
розміром
(п • 1).
Задля зручності
використання
алгоритмів
МНК матриця
X розширюється
за рахунок
додатково
введеної фіктивної
змінної
 , вектор
якої представлений
одиницями.
Параметри
моделі — вектор
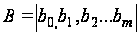 визначаються
розв'язуванням
системи нормальних
рівнянь, яка
записується
так:
X'ХВ =
 у,
де
X
— матриця
розміром п
(т + 1).
Послідовність розрахунків включає етапи:
обчислення
матриці
 X
і вектора
у
обертання
матриці С
= ;
розрахунок
параметрів
 ;
визначення
теоретичних
значень результативної
ознаки
 та залишків
.
Значення коефіцієнтів регресії певною мірою залежать від складу введених у модель факторів.
З розширенням
ознакової
множини моделі
відбувається
перерозподіл
впливу попередньо
введених факторів.
Чим вагоміший
вплив нововведеного
фактора, тим
помітніші
зміни. Ілюстрацією
перерозподілу
впливу факторів
може слугувати
регресійна
модель урожайності
рису, ц/га [11]. У
модель послідовно
вводились
агротехнічні
фактори:
 — попередник,
балів;
 —
внесення добрив
під основний
обробіток,
центнерів
поживної речовини
(ц п. р.) на 1 га посіву;
 —
передпосівний
обробіток, та
м'якої оранки;
 —
підживлення,
ц п. р.;
 —
норма висіву;
 —
кількість
прополювань.
Відповідно
отримано такі
рівняння регресії:
1. Y=30,432 + 3,001;
2. Y= 26,208 + 2,049
+ 5,995;
3. Y= 21,563 + 1,970
+ 4,610
+ 2,906;
4. Y= 22,332 + 1,321
+ 4,558
+ 1,465+
9,791;
5. Y= 18,960 + 1,342
+ 4,483
+ 1,347
+ 9,545
+ 1,756;
6. Y= 19,387+ 0,965,
+ 3,400
+ 0,501
+ 7,500
+ 1,73
+ 3,433.
Як бачимо, введення кожного нового фактора спричиняє зменшення впливу попередньо введених факторів, таку ж тенденції має й вільний член рівняння.
Оскільки
факторні ознаки
мають, як правило,
різні одиниці
вимірювання,
то для порівняння
ефектів їх
впливу в рамках
моделі використовують
стандартизовані
коефіцієнти
регресії
 (бета-коефіцієнти)
або коефіцієнти
еластичності
-
 .
Бета-коефіцієнт
характеризує
ефект впливу
на у в середньоквадратичних
відхиленнях,
коефіцієнт
еластичності
— в процентах.
У табл. 5.2 наведено
бета-коефіцієнти
останнього
(шостого) варіанта
моделі врожайності
рису. Згідно
із значеннями
Р, найвагоміший
вплив на врожайність
рису мають:
прополювання
(
 =
0,360), підживлення
 =
0,264), внесення
добрив під
основний обробіток
(
 =
0,248).
Для оцінювання адекватності регресійної моделі використовують:
стандартне відхилення;
множинні коефіцієнти детермінації та кореляції;
частинні коефіцієнти детермінації та кореляції;
коефіцієнти окремої детермінації;
критерії перевірки істотності зв'язку.
Стандартне відхилення характеризує варіацію залишкових величин
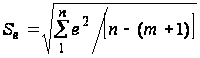 ,
де n — обсяг сукупності, т — кількість коефіцієнтів регресії.
Розрахунок характеристик щільності зв'язку ґрунтується на декомпозиції (розкладанні) варіації у за джерелами формування:
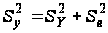 ,
де
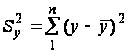 — загальна
сума квадратів
відхилень,
зумовлена
впливом усіх
можливих факторів;
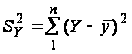 — факторна
сума квадратів
відхилень,
зумовлена
впливом включених
у модель факторних
ознак;
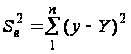 — залишкова
сума квадратів
відхилень,
розмір
якої залежить
від потужності
впливу не включених
у модель факторів.
Відношення факторної суми квадратів до загальної характеризує частку варіації у, пов'язану з варіацією включених у модель факторів, і називається множинним коефіцієнтом детермінації
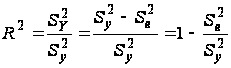 .
За
відсутності
зв'язку
 = 0. Якщо
зв'язок функціональний,
то
 =
1. Очевидно,
що
пов'язаний
із стандартним
відхиленням
 .
При зменшенні
значення
зростатиме
і навпаки. Корінь
квадратний
із коефіцієнта
детермінації
називають
коефіцієнтом
кореляції
 .
Для моделі
врожайності
рису R =
0,8394,
= 0,7029, тобто
70,29% варіації
врожайності
рису лінійно
пов'язані з
агротехнічними
факторами,
включеними
в модель.
Окрім
названих множинних
коефіцієнтів
щільності
зв'язку, в комп'ютерних
програмах
передбачено
розрахунок